9 Najlepsze offline'owe narzędzia AI do transkrypcji do użytku prywatnego 2026
Wybór narzędzia do transkrypcji to w rzeczywistości decyzja o powierzeniu danych. Etykieta „offline” obejmuje trzy bardzo różne architektury, a tylko jedna z nich naprawdę trzyma Twoje audio z dala od cudzego serwera.
Powszechne przekonanie wśród użytkowników prosumenckich w małych firmach, często jednej osoby odpowiedzialnej za zamianę nagrania na tekst, jest takie, że wybór dowolnego narzędzia oznaczonego jako „offline” wystarczy, by chronić to audio, ponieważ offline automatycznie oznacza, że plik nigdy nie opuszcza urządzenia. Za każdym razem, gdy przesyłasz nagranie na serwer transkrypcji w chmurze, to audio opuszcza Twoje urządzenie bez wyraźnej zgody każdej osoby, która na nim mówiła. To nie jest preferencja dotycząca prywatności.
To transfer powierzenia danych, a dla każdego, kto ma do czynienia z wrażliwymi nagraniami, konsekwencje są wymierne i udokumentowane. Większość ludzi traktuje wybór oprogramowania do transkrypcji jako kwestię wygody. Prawdziwym pytaniem jest, kto sprawuje pieczę nad audio po naciśnięciu przycisku przesyłania.
Zobacz nasze oprogramowanie do transkrypcji, aby dowiedzieć się, jak to działa w praktyce.
RODO i HIPAA wymagają zarówno umów o przetwarzaniu danych, jak i, w wielu przypadkach, wyraźnej zgody osoby, której dane dotyczą, zanim osobiste audio zostanie przekazane zewnętrznemu procesorowi. Freelance'owy dziennikarz, którego rozmówca nigdy nie zgodził się na przetwarzanie swojego głosu przez amerykańskiego dostawcę chmury, już w momencie przesłania pliku stworzył ekspozycję prawną, niezależnie od tego, czy doszło do naruszenia. Ryzyko nie jest hipotetyczne: badania konsumenckie konsekwentnie pokazują, że około jedna trzecia dorosłych doświadczyła już naruszenia danych w firmie, której powierzyła swoje dane. Usługi transkrypcji w chmurze otrzymują audio jako normalną część swojego modelu biznesowego, a to, co dzieje się dalej, regulują ich warunki świadczenia usług, a nie Twoje założenia.
Etykieta „offline” jest stosowana niekonsekwentnie na rynku. Niektóre narzędzia wykonują pełne wnioskowanie modelu na urządzeniu. Inne buforują audio lokalnie, ale synchronizują się z serwerami w chmurze, gdy dostępne jest połączenie.
Niewielka liczba po cichu kieruje trudne nagrania do interfejsów API chmury bez widocznego wskaźnika dla użytkownika. Badania branżowe dotyczące wykrywania naruszeń konsekwentnie pokazują, że duża część zdarzeń eksfiltracji danych jest odkrywana dopiero po tym, jak dane pojawią się na zewnątrz, na ciemnych rynkach lub w alertach stron trzecich, a nie poprzez monitoring wewnętrzny, oraz że większość organizacji nie ma widoczności w czasie rzeczywistym, czy wrażliwe dane w ogóle opuszczają ich środowisko. Dla pojedynczego użytkownika ta luka w widoczności jest całkowita.
Ten przewodnik opiera się na dopasowaniu wymogu powierzenia danych do właściwej architektury. Etykieta „offline” obejmuje co najmniej trzy odrębne architektury techniczne, z których tylko jedna trzyma Twoje audio z dala od cudzego serwera.
Najważniejsze wnioski
- Wybór narzędzia do transkrypcji offline to przede wszystkim decyzja o prywatności danych; pytanie nie brzmi, czy Twój internet jest wystarczająco szybki, ale czy Twoje audio kiedykolwiek dotknie cudzego serwera.
- Wiele narzędzi reklamowanych jako offline przechodzi na wnioskowanie w chmurze, gdy dokładność staje się trudna, co oznacza, że obietnica prywatności i obietnica dokładności po cichu przestają iść w parze dokładnie w najgorszym momencie.
- Każde przesłanie do transkrypcji w chmurze przenosi Twoje audio bez wyraźnego ujawnienia, kto je przetwarza, jak długo jest przechowywane i do czego jest wykorzystywane do trenowania.
- Wnioskowanie na urządzeniu uruchamia cały model lokalnie, więc plik audio nigdy nie opuszcza Twojego sprzętu, ale ta gwarancja obowiązuje tylko wtedy, gdy potok narzędzia jest w pełni lokalny na każdym etapie, nie tylko na pierwszym.
- Rozmiar modelu Whisper to problem dopasowania do sprzętu, a nie maksymalizacji dokładności; uruchamianie modelu zbyt dużego dla Twojej maszyny kosztuje Cię więcej czasu na minutę audio, niż jest warta korzyść w dokładności.
- Publikowane wartości wskaźnika błędów słów (Word Error Rate) dla transkrypcji offline są obliczane po tym, jak normalizator tekstu Whisper usunie interpunkcję i wygładzi niestandardowe formy, więc błędy najbardziej szkodliwe dla rzeczywistych transkrypcji są systematycznie wykluczane z testu porównawczego.
- Jeśli nagranie nie musi pozostawać na Twoim urządzeniu, usługa w chmurze, taka jak Cockatoo, jest pragmatyczną alternatywą: pełne transkrypcje za darmo bez dziennego limitu, wyniki dokładności dla poszczególnych języków publikowane wraz z metodą oraz dane przechowywane i przetwarzane w USA i UE (Finlandia).
Co tak naprawdę oznacza transkrypcja AI offline pod względem technicznym
Większość narzędzi, które nazywają się offline, i tak łączy się z serwerem w najważniejszym momencie: gdy przetwarzane jest Twoje audio.
Wnioskowanie na urządzeniu - Co model faktycznie robi z Twoim audio
Odtwarzanie 45-minutowego spotkania, aby zlokalizować pojedyncze zadanie do wykonania, jest naprawdę nieefektywne i to właśnie ta uciążliwość sprawia, że warto dobrze zrozumieć transkrypcję offline.
Transkrypcja AI offline, precyzyjnie definiując, oznacza, że cały potok wnioskowania wykonuje się na lokalnym sprzęcie bez żadnych wywołań sieciowych na każdym etapie. Według analizy danych branżowych dotyczących OpenAI Whisper, model jest transformerem enkodera-dekodera wytrenowanym na 680,000 godzinach wielojęzycznego audio, wykonującym wnioskowanie mowa-na-tekst w całości na lokalnym CPU, GPU lub Apple Neural Engine, bez opuszczania danych z urządzenia. Co faktycznie dzieje się podczas uruchomienia transkrypcji: przebieg fali dźwiękowej jest dzielony na segmenty 30-sekundowe, każdy konwertowany na spektrogram log-mel, a enkoder odwzorowuje ten spektrogram na reprezentację wektorową, której dekoder używa do przewidywania sekwencji tokenów.
680,000
godzin audio, na których trenowano Whisper
Cockatoo to usługa w chmurze: Twoje audio jest przetwarzane na jej serwerach w USA i UE (Finlandia). Jeśli przetwarzanie w chmurze jest akceptowalne dla danego nagrania, jego plan Free nie wymaga karty kredytowej i daje nieograniczone transkrypcje pełnej długości bez dziennego limitu, więc możesz porównać jego wynik z lokalnym uruchomieniem Whisper na tym samym pliku. W planie Pro Canvas podsumowuje długie nagranie do tego, co faktycznie wymaga działania, zamieniając plik audio, którego odtworzenie zajęłoby 45 minut, w krótką listę decyzji w ułamku tego czasu.
Jak OpenAI Whisper i Whisper.cpp stały się silnikiem w niemal każdym narzędziu offline
OpenAI wydało Whisper we wrześniu 2022 jako wagi modelu open-source na GitHubie, dostępne do bezpłatnego pobrania, uruchamiania i modyfikacji. Wykonuje pełne lokalne wnioskowanie modelu AI na Apple Silicon przy użyciu Neural Engine, osiągając współczynniki czasu rzeczywistego znacznie poniżej 1.0 dla wariantów medium i large, co oznacza, że 10-minutowe nagranie kończy się w mniej niż 10 minut na nowoczesnym MacBooku.
Dla długich nagrań, które nie muszą pozostać offline, plan Pro Cockatoo obsługuje nieograniczoną długość pliku, więc wielogodzinne duże przesłania przechodzą w całości. To właśnie te nagrania, w których transkrypcja oszczędza najwięcej czasu: te zbyt długie, by odtwarzać je ręcznie.
Pułapka łączenia się z serwerem - Dlaczego „Nie wymaga internetu” nie zawsze znaczy to, co myślisz
Etykieta „nie wymaga internetu” gwarantuje jedynie, że narzędzie może działać bez łączności, a nie że nigdy nie podejmie prób wywołań sieciowych, gdy połączenie jest dostępne.
Audio, które najbardziej potrzebuje prywatności, to dokładnie to audio, które jest przesyłane.
Cockatoo, usługa w chmurze, publikuje wskaźniki błędów dla poszczególnych języków dla 36 języków, które obsługuje, na swojej stronie benchmarków, więc użytkownicy mogą sprawdzić wydajność przed przesłaniem czegokolwiek. To oddaje wybór między prywatnością na urządzeniu a dokładnością w chmurze w ręce użytkownika, zamiast ukrywać go w drobnym druku. Gdy już wiesz, że prawdziwa transkrypcja offline stoi lub upada na tym, co lokalny sprzęt może faktycznie wykonać, kolejne pytanie staje się praktyczne: jaki rozmiar modelu Whisper może uruchomić Twoja konkretna maszyna, nie zamieniając 10-minutowego nagrania w 40-minutowe oczekiwanie?
Jak wybrać odpowiedni rozmiar modelu Whisper dla swojego sprzętu
Pięć poziomów Whisper i ile każdy z nich faktycznie kosztuje Twoją maszynę
Wybierz odpowiedni rozmiar modelu Whisper, dopasowując najpierw RAM i VRAM. Modele Tiny i Base działają na standardowym RAM bez dedykowanego GPU. Są wykonalne na każdej maszynie, ale dają zauważalnie wyższe wskaźniki błędów na wszystkim poza czystym audio z jednym mówcą, co jest szeroko udokumentowaną ograniczeniem przez praktyków przeprowadzających porównania w rzeczywistych warunkach. Small i Medium zajmują środkową pozycję, oferując znacząco lepszą dokładność, pozostając wykonalnymi na skromnym sprzęcie. Turbo i Large-v3 zapewniają najwyższą dokładność, ale wymagają co najmniej 8 GB pamięci VRAM GPU, aby działać bez przeciążania pamięci systemowej.
| Model | Przybliżone wymagania VRAM / RAM | Szybkość na CPU | Najlepsze do |
|---|---|---|---|
| Tiny | ~1 GB RAM, karta GPU niepotrzebna | Bardzo szybki | Szybkie notatki, czysta mowa |
| Base | ~1 GB RAM, karta GPU niepotrzebna | Szybki | Transkrypcja swobodna, jeden mówca |
| Small | ~2 GB RAM lub GPU | Umiarkowany | Codzienne nagrania, większość akcentów |
| Medium | ~5 GB RAM lub GPU | Wolniejszy | Mowa z akcentem, dźwięk wielojęzyczny |
| Turbo | ~6 GB VRAM zalecane | Szybki na GPU | Wysoka dokładność i szybkość na sprzęcie RTX |
| Large-v3 | ~8 GB VRAM minimum | Wolny na CPU | Nagrania techniczne, wielojęzyczne, zaszumione |
Według porównania modeli z marca 2026 na blogu Tinrec, próba uruchomienia Large lub Turbo bez wystarczającej ilości VRAM zmusza CPU do kompensacji, co skutkuje wydajnością wolniejszą niż w czasie rzeczywistym lub błędami braku pamięci i niweluje wszelkie korzyści z dokładności.
Zasada decyzyjna oparta na sprzęcie: dopasuj RAM i GPU, zanim wybierzesz model
Zasada decyzyjna jest prosta: najpierw znajdź górny limit swojego sprzętu, a następnie wybierz największy model, który się w nim mieści. MacBook Pro M3 z 16 GB RAM i układem Apple może bezproblemowo uruchomić Whisper Large-v3, ponieważ Apple Silicon przenosi wnioskowanie do Neural Engine. Czteroletni Intel Core i5 z 8 GB RAM ma realny limit w postaci Small lub Medium co najwyżej.
Na sprzęcie NVIDIA Turbo jest często mądrzejszym wyborem niż Large-v3, oferując porównywalną dokładność przy większej szybkości na średniej klasy GPU, takich jak RTX 3060, więc jest to domyślna rekomendacja dla większości laptopów Windows z dedykowaną kartą graficzną.
Kiedy przejść na wyższy poziom modelu: różnice w dokładności wpływające na rzeczywiste transkrypcje
Różnica w dokładności między poziomami jest realna, ale zależna od kontekstu, jak zauważa analiza z marca 2026 na blogu Tinrec. W przypadku czystych nagrań z jednym mówcą w cichym otoczeniu Small często dorównuje Medium w praktyce. Różnica między Medium a Large-v3 staje się istotna dopiero wtedy, gdy dźwięk jest gęsty technicznie, wielojęzyczny lub mocno akcentowany.
Dla użytkowników, których sprzęt nie może niezawodnie obsłużyć Medium, a których nagrania mogą opuścić urządzenie, transkrypcja w chmurze Cockatoo działa na własnych serwerach. Jakość wyniku jest wtedy determinowana przez model i dźwięk, a nie przez ilość RAM w laptopie użytkownika – praktyczny limit, którego narzędzia offline nie mogą usunąć.
Powiązane lektury
- Najlepsze oprogramowanie do transkrypcji
- Cennik Turboscribe
- Lokalna transkrypcja AI
- Jak transkrybować wideo
- Transkrypcja wielojęzyczna
9 Najlepsze offline'owe narzędzia do transkrypcji AI do użytku prywatnego, uszeregowane według platformy
Dziewięć narzędzi, trzy platformy, jedno pytanie, które naprawdę ma znaczenie: czy Twoje dźwięki pozostają na Twoim sprzęcie na każdym etapie procesu, w tym na etapach łatwych do przeoczenia.
Podstawowe twierdzenie, na którym opiera się ten przewodnik, warto wyrazić jasno przed rozpoczęciem porównań narzędzi: żadna pojedyncza etykieta „offline” nie odróżnia wiarygodnie narzędzi architektonicznie prywatnych od tych, które są jedynie opcjonalnie chmurowe domyślnie, ponieważ narzędzie może uruchamiać swój główny model lokalnie, jednocześnie po cichu kierując otaczające etapy procesu – przywracanie interpunkcji, diaryzację, tłumaczenie, pingi licencyjne, telemetrię – na zewnątrz. Oznacza to, że użytkownicy oceniający narzędzia pod kątem naprawdę wrażliwych dźwięków muszą niezależnie sprawdzić każdą funkcję procesu, a nie akceptować górnej etykiety „offline” jako ogólnej gwarancji prywatności.
Etykieta „offline” wykonuje dużo pracy, do której nigdy nie została zaprojektowana. Jak dokumentuje wrześniowe porównanie MacWhisper autorstwa Fraze, narzędzie może uruchamiać swój podstawowy model wnioskowania lokalnie, jednocześnie kierując opcjonalne funkcje, takie jak transkrypcja w chmurze, tłumaczenie i podpowiedzi AI, przez serwery zewnętrzne. To rozróżnienie ma ogromne znaczenie dla każdego, kto przetwarza nagrania wywiadów, notatki prawne lub wrażliwe pliki audio, w których proces musi być w pełni audytowalny. Gwarancja prywatności narzędzia obowiązuje tylko wtedy, gdy każdy etap procesu, w tym przywracanie interpunkcji, diaryzacja, pingi licencyjne i telemetria, jest weryfikowalnie lokalny. Zaakceptowanie górnej etykiety „offline” jako ogólnej gwarancji to błąd, który naraża wrażliwe dźwięki na ryzyko.
Poniższe dziewięć narzędzi jest pogrupowanych według platformy i uszeregowanych w ramach każdej grupy według tego, jak czysto spełniają ten surowszy test.
1. MacWhisper - Najlepsza natywna dla macOS transkrypcja AI offline dla użytkowników nietechnicznych
MacWhisper zajmuje najwyższe miejsce w kategorii macOS, ponieważ jego podstawowe wnioskowanie domyślnie działa lokalnie, a polityka prywatności potwierdza, że żadne dane nie opuszczają urządzenia poza anonimowymi weryfikacjami licencji. Trzeba jednak zaznaczyć, że dokumentacja Fraze jest jednoznaczna: transkrypcja w chmurze, tłumaczenie DeepL oraz funkcje promptów AI przesyłają dane na zewnątrz, gdy zostaną włączone, więc gwarancja prywatności obowiązuje tylko wtedy, gdy pozostawisz te opcjonalne funkcje wyłączone. Cena jednorazowego zakupu wynosi około 64 do 65 euro bez powtarzającej się subskrypcji, co usuwa presję corocznego odnowienia, która popycha użytkowników w stronę planów chmurowych. Zastrzeżenie dotyczące sprzętu: model Parakeet wymaga Maca z serii M, Qwen3-ASR wymaga macOS 26, a modele Medium lub Large Whisper potrzebują więcej niż 8 GB RAM. Użytkownicy Maców z procesorami Intel mogą zauważyć wyraźnie słabą wydajność.
2. Whisper.cpp - Najlepsze lekkie narzędzie CLI dla zaawansowanych użytkowników macOS i Linux
Whisper.cpp kompiluje się bezpośrednio względem warstwy GPU Metal układów Apple Silicon, co oznacza, że uruchamia model Large-v3 z prędkością dorównującą API chmurowym na MacBooku Pro M3, bez jakiejkolwiek zależności sieciowej na każdym etapie. Kompromisem jest czas konfiguracji: budujesz ze źródeł w terminalu, co przy pierwszym podejściu zajmuje od 20 do 40 minut i zakłada swobodę w posługiwaniu się narzędziami wiersza poleceń. Nie ma opcjonalnych funkcji chmurowych, które można przypadkowo włączyć, co sprawia, że ryzyko „dzwonienia do domu” jest zasadniczo zerowe. Najlepsze dla deweloperów i badaczy, którzy chcą pełnej kontroli nad modelem i są gotowi wymienić GUI na audytowalną, całkowicie lokalną ścieżkę wnioskowania.
3. Wisper - Najlepsze wieloplatformowe narzędzie do dyktowania offline dla Linux, Windows i macOS
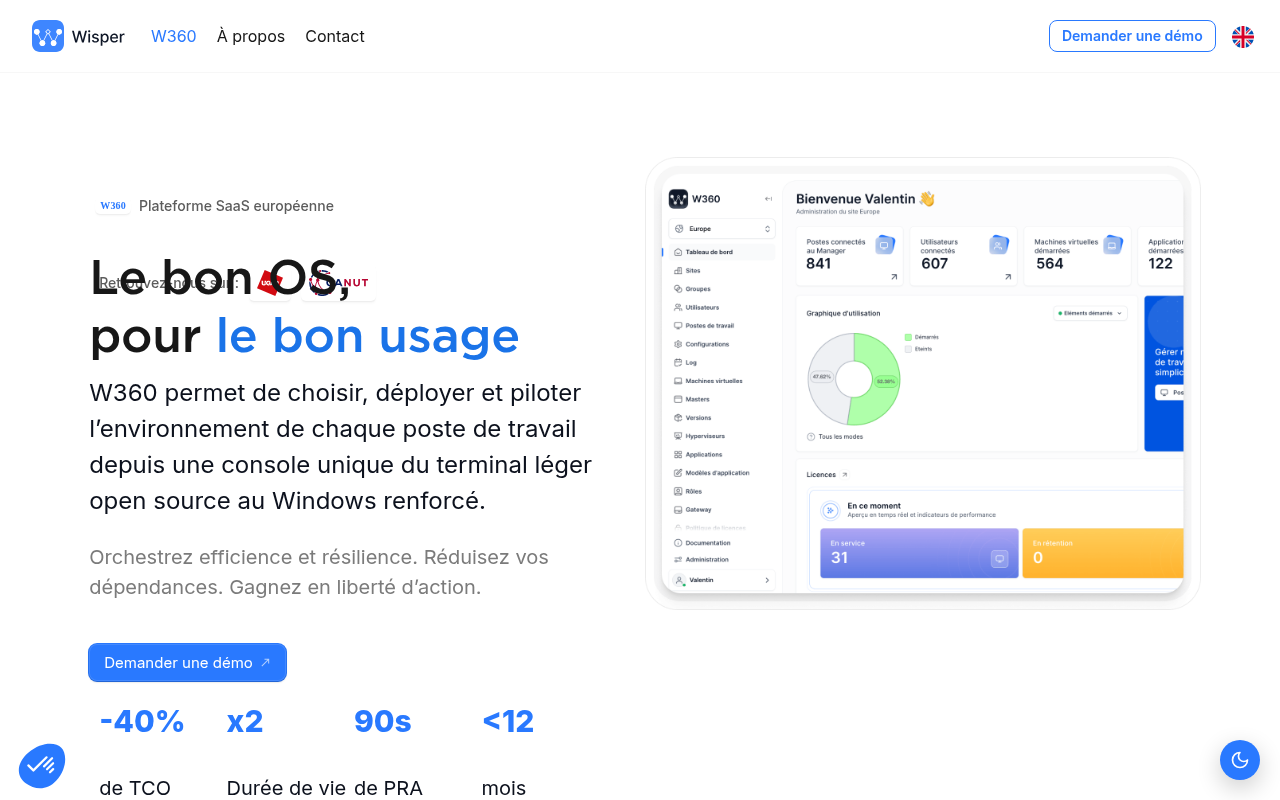
Wisper to wieloplatformowa aplikacja desktopowa, która opakowuje wnioskowanie Whisper w GUI i obsługuje Windows, macOS oraz Linux z jednego instalatora, co czyni ją najbardziej praktycznym wyborem dla zespołów pracujących na mieszanych systemach operacyjnych. Wnioskowanie lokalne działa w pełni na urządzeniu, bez ścieżki awaryjnej do chmury w standardowej konfiguracji. Kompromisem względem Faster-Whisper jest surowa prędkość: Wisper stawia dostępność ponad przepustowość, więc nie jest właściwym wyborem do wsadowego przetwarzania dużych ilości plików. Jest właściwym wyborem, gdy osoba wykonująca transkrypcję nie jest deweloperem i potrzebuje czegoś, co działa tak samo na dowolnym laptopie, który ma przed sobą.
4. Faster-Whisper (Windows/Linux) - Najlepsza akcelerowana GPU transkrypcja offline dla dużej liczby plików
Faster-Whisper reimplementuje Whisper przy użyciu CTranslate2, co zapewnia około 4 do 8 razy szybsze wnioskowanie niż oryginalna implementacja w Pythonie na równoważnym sprzęcie, przy niższym zużyciu VRAM. Ten wzrost prędkości jest powodem, dla którego użytkownicy o dużym wolumenie, pipeline'y transkrypcji i wszyscy przetwarzający godziny audio dziennie wybierają go zamiast implementacji referencyjnej. Całe wnioskowanie działa lokalnie; w bibliotece podstawowej nie ma ścieżki awaryjnej do chmury. Konfiguracja wymaga Pythona i pewnej znajomości środowisk pip, co tworzy punkt tarcia dla użytkowników nietechnicznych. Najlepszy, gdy masz GPU Nvidia, maszynę z Linux lub Windows i wystarczająco dużo nagrań, że prędkość przetwarzania jest wąskim gardłem.
5. mlx-whisper (Apple Silicon MCP Skill) - Najlepsza transkrypcja stawiająca prywatność na pierwszym miejscu dla przepływów pracy Claude Code na Macu
Mlx-whisper używa frameworka MLX firmy Apple do uruchamiania modeli Whisper natywnie na Neural Engine serii M i udostępnia tę możliwość jako umiejętność MCP, którą Claude Code może wywołać bezpośrednio. Każdy krok wnioskowania działa lokalnie; nie ma przekazania do API usługi transkrypcji. To wąskie, ale potężne dopasowanie: jeśli Twój przepływ pracy już żyje w Claude Code i potrzebujesz transkrypcji bez opuszczania tego środowiska lub kierowania audio przez usługę zewnętrzną, mlx-whisper czysto wypełnia tę lukę. To nie jest aplikacja konsumencka i wymaga konfiguracji środowiska Python, więc wykracza poza zakres użytkowników nietechnicznych.
6. Offline Privacy Transcription (aplikacja iOS/watchOS) - Najlepsza mobilna transkrypcja AI offline dla iPhone i Apple Watch
Offline Privacy Transcription działa w całości na urządzeniu na iPhone i Apple Watch, bez przesyłania na serwer na żadnym etapie. Integracja z watchOS jest rzadkością: pozwala na nagrywanie notatek głosowych na zegarku z transkrypcją, która nigdy nie opuszcza urządzenia, co ma znaczenie przy wywiadach terenowych lub szybkich notatkach prawnych, gdy wyciągnięcie telefonu jest niepraktyczne. Ograniczeniem jest rozmiar modelu: mobilne wnioskowanie na urządzeniu wykorzystuje skompresowane modele, które wymieniają część dokładności na ograniczenia pamięci telefonu lub zegarka. Przy czystym dźwięku w cichym pomieszczeniu dokładność jest wysoka. W hałaśliwym otoczeniu lub przy silnym akcencie różnica się powiększa.
7. Whisper-Standalone-Win - Najlepsza gotowa do użycia offline transkrypcja dla Windows bez Pythona
Whisper-Standalone-Win pakuje model Whisper i wszystkie jego zależności w jeden samodzielny plik wykonywalny, dzięki czemu użytkownicy Windows bez instalacji Pythona mogą uruchomić lokalną transkrypcję, klikając dwukrotnie plik. Ten projekt bez zależności jest kluczowym wyróżnikiem dla użytkowników małych firm, którzy nie mogą lub wolą nie instalować łańcuchów narzędzi deweloperskich: bez Pythona, bez menedżera pakietów, bez terminala. Ryzyko „phone-home” jest niskie: plik wykonywalny nie ma wbudowanego mechanizmu awaryjnego w chmurze. Praktycznym ograniczeniem jest obsługa GPU; karty Nvidia z obsługą CUDA znacznie przyspieszają przetwarzanie, ale transkrypcja wyłącznie na CPU na starszym sprzęcie jest wystarczająco wolna, by frustrować użytkowników z długimi nagraniami.
8. Aiko - Najlepsza aplikacja do offline transkrypcji na macOS i iOS dla prostoty i wygody App Store
Aiko uruchamia Whisper w całości na urządzeniu i jest dystrybuowana przez Mac App Store oraz iOS App Store, co oznacza, że zasady piaskownicy Apple egzekwują to, co obiecuje polityka prywatności: aplikacja nie może wykonywać dowolnych połączeń sieciowych bez wyraźnej zgody użytkownika. Piaskownica App Store jest istotnym wyróżnikiem dla czytelników objętych regulacjami, ponieważ przenosi ciężar weryfikacji z „zaufaj polityce dewelopera” na „zaufaj mechanizmowi egzekwowania Apple”. Aiko to właściwy wybór, gdy chcesz prosty interfejs przeciągnij i upuść, prawdziwe lokalne wnioskowanie i audytowalną gwarancję prywatności bez czytania dokumentacji. Ograniczeniem jest elastyczność modeli: dostajesz to, co dostarcza Aiko, a nie menu rozmiarów modeli.
9. Vosk Offline Speech Recognition - Najlepsza lekka opcja wieloplatformowa dla sprzętu o niskim poborze mocy i serwerów Linux
Najmniejsze modele Voska zaczynają się od około 50 MB i działają na sprzęcie tak ograniczonym jak Raspberry Pi, co czyni go jedynym narzędziem na tej liście, które działa w autentycznie odizolowanych (air-gapped) lub niskoprądowych środowiskach serwerowych. Obsługuje ponad 20 języków i nie wymaga GPU. Ryzyko „phone-home” jest zerowe: Vosk to biblioteka, a nie aplikacja, i nie wykonuje żadnych połączeń sieciowych.
Kompromis w dokładności jest realny: lekkie modele na sprzęcie o niskim poborze mocy generują wyniki wymagające więcej poprawek niż duży model Whisper na nowoczesnym laptopie. Dla praktyków uruchamiających pipeline'y transkrypcji na ograniczonej infrastrukturze ten kompromis jest akceptowalny. Dla prosumenckich użytkowników, którzy chcą dokładności zbliżonej do chmury na pojedynczym pliku, nie jest.
Luka w przepływie pracy po transkrypcji - Czego narzędzia offline nie obsługują
Większość prosumenckich użytkowników z tej listy dojdzie do tego samego punktu: czysty lokalny transkrypt leżący w pliku tekstowym bez oczywistego następnego kroku. Przeniesienie go do dokumentu, który ktoś inny może faktycznie przeczytać, edytować lub na jego podstawie działać, wymaga drugiego ręcznego przejścia, a ten krok kopiuj-wklej po cichu kasuje wiele czasu zaoszczędzonego przez lokalne narzędzie.
To tarcie jest jednym z najbardziej powtarzalnych punktów bólu dla osób, które polegają na transkrypcji jako części prawdziwego dnia pracy. Gdy twoim celem jest zaprzestanie ręcznego pisania notatek podczas spotkań lub uchwycenie myśli, zanim znikną, ostatnią rzeczą, jakiej potrzebujesz, jest drugi ręczny krok między transkryptem a gotowym dokumentem. Narzędzia offline nie rozwiązują tego kroku, tylko przenoszą miejsce, w którym się odbywa.
Cockatoo, narzędzie chmurowe, obsługuje ten krok inaczej. Po transkrypcji pliku transkrypcja otwiera się w edytorze przeglądarkowym, gdzie można poprawić nazwy, zmienić nazwę mówiącego raz, aby zaktualizować każdą linię, oraz wyeksportować DOCX, PDF, TXT, SRT, VTT, CSV lub JSON bez kopiowania tekstu. Cockatoo transkrybuje 36 języków, z wynikami dla poszczególnych języków na jego stronie z benchmarkami, co ma znaczenie dla użytkowników, których praca obejmuje więcej niż jeden język. W planie Pro Canvas zamienia transkrypcję w podsumowania i notatki. Ponieważ dźwięk jest przetwarzany na serwerach Cockatoo, pasuje do nagrań, które nie muszą pozostać offline.

Jeśli chodzi o koszty, porównanie warto przedstawić wprost. Narzędzia takie jak SpeechPulse mają jednorazowe ceny w okolicach $99, co stanowi istotną barierę dla indywidualnych użytkowników, szczególnie tych spoza regionów, gdzie ta cena jest standardem. Plan Free Cockatoo nic nie kosztuje i nie wymaga karty kredytowej: nieograniczone pełne transkrypcje w V4-Flash bez dziennego limitu, cotygodniowe podglądy V4-Pro oraz wszystkie formaty eksportu. Etykiety mówiących są dostępne w V4-Pro.
Canvas można wypróbować w planie Free. Pro przetwarza całe nagrania w V4-Pro, z etykietami mówiących, priorytetowym przetwarzaniem i nieograniczoną długością pliku. Aktualne ceny znajdują się na stronie z cennikiem.
Każde narzędzie z tej listy da ci transkrypcję. To, czego żadne z nich nie reklamuje na etykiecie, to jak zgrabnie radzą sobie z dźwiękiem, który nie współpracuje: silnymi akcentami, nakładającymi się mówiącymi, pomieszczeniem o złej akustyce. To luka, którą mapuje następna sekcja, wraz ze szczerymi przypadkami, w których narzędzie wspomagane chmurą jest pragmatycznym wyborem, a nie porażką prywatności.
Powiązane lektury
- Najlepsza aplikacja do transkrypcji
- Descript Vs Otter
- Fireflies Vs Otter
- Trint Vs Rev
- Happy Scribe Vs Rev
- Konkurenci Otter.AI
Gdzie dokładność transkrypcji offline wciąż sprawia trudności i co z tym zrobić
Normalizator tekstu Whisper usuwa interpunkcję, ujednolica pisownię i wygładza formy niestandardowe przed obliczeniem wyniku WER, więc błędy najprawdopodobniej pojawiające się przy dźwięku z akcentem lub szumem są częściowo wymazywane przed pomiarem, jak udokumentował Benjamin Marie w The Kaitchup w sierpniu 2023.
"Użytkownicy potrzebują transkrypcji offline do wymagających, powtarzających się zastosowań (spotkania korporacyjne, szkoła prawnicza, wykłady na uczelni, nagrania rodzinne), co oznacza, że każda awaria dokładności w tych kontekstach ma realne konsekwencje."
— co słyszymy od profesjonalistów i studentów potrzebujących transkrypcji
Gdzie duże modele Whisper faktycznie dorównują chmurze, a gdzie nie
Ten obraz z benchmarków jest jednak niepełny, ponieważ ta sama analiza benchmarków wykazała, że luki w dokładności wyraźnie się powiększają przy silnych akcentach, niestandardowych dialektach i nagraniach niskiej jakości, gdzie reprezentacja danych treningowych się przerzedza.
Podatek od poprawek, gdy luki w dokładności kosztują więcej czasu niż ręczna transkrypcja
Transkrypcja ze współczynnikiem błędów słów 10-15% na godzinnym nagraniu może oznaczać setki błędnych słów rozproszonych po pliku. Te błędy nie rozkładają się równomiernie, skupiają się wokół warunków dźwiękowych, z którymi model już ma trudności, potęgując obciążenie poprawkami. Plik 60-minutowy z utrzymującymi się błędami może łatwo pochłonąć więcej czasu na poprawki, niż zaoszczędziła transkrypcja, całkowicie niwelując korzyść wydajnościową narzędzia.
Trzy działania łagodzące i kiedy narzędzie chmurowe z kontrolą prywatności jest szczerą odpowiedzią
- Uruchom największy model, jaki twoj sprzęt może utrzymać bez przeciążania RAM.
- Wstępnie przetwórz dźwięk przed transkrypcją: znormalizuj głośność, zredukuj szum tła za pomocą narzędzia takiego jak filtr redukcji szumów Audacity i przytnij ciszę. Czystsze wejście daje wyraźnie lepsze wyjście z tego samego modelu.
- Zrób test punktowy na reprezentatywnym 5-minutowym klipie z twojego rzeczywistego typu nagrania przed zobowiązaniem się do całego pliku, aby poznać rzeczywisty wskaźnik błędów, zanim uderzy podatek od poprawek.
Gdy te kroki nadal pozostawiają wynik nieużytecznym, a nagranie może opuścić Twoje urządzenie, uczciwą odpowiedzią jest narzędzie w chmurze, które jasno mówi, gdzie trafiają Twoje dane i jak dokładne jest. Cockatoo przechowuje i przetwarza dane w USA oraz w UE (Finlandia), a jego wyniki dokładności dla poszczególnych języków, opublikowane wraz z metodą na stronie z benchmarkami, pozwalają sprawdzić wydajność dla Twojego języka, zanim się zobowiążesz. Dokładność różni się w zależności od języka i jakości nagrania, więc test na własnym typie dźwięku wciąż ma znaczenie. Większość narzędzi w tej kategorii podaje gołe twierdzenia o dokładności bez żadnych danych źródłowych, więc opisany powyżej podatek od przebiegu czyszczenia staje się widoczny dopiero po zainwestowaniu czasu w plik.
Powiązane lektury
- Alternatywy dla Turboscribe
- Alternatywy dla Trint
- Alternatywy dla Happy Scribe
- Alternatywy dla Sonix
- Trint vs Otter
Następne kroki
Jeśli Twoje wrażliwe nagrania wciąż trafiają na serwery, na które nigdy się nie zgodziłeś, droga naprzód zaczyna się od potraktowania „offline” jako kwestii architektury, a nie etykiety. Narzędzie, które uruchamia główne wnioskowanie lokalnie, ale kieruje przywracanie interpunkcji, diaryzację lub pingi licencyjne na zewnątrz, oferuje takie samo praktyczne narażenie jak hybrydowy produkt chmurowy, a dźwięk najbardziej narażony na wywołanie tej cichej eskalacji to dźwięk, który profesjonaliści najbardziej potrzebują chronić. Zacznij od naszego oprogramowania do transkrypcji.
Zasada wyboru modelu zorientowanego na sprzęt oznacza, że sięganie po największy wariant Whisper bez dopasowania go do dostępnej VRAM może całkowicie zepsuć lokalny przepływ pracy, popychając użytkowników dokładnie w stronę awaryjnego przejścia do chmury, którego próbowali uniknąć. Problem sufitu benchmarków oznacza, że publikowane wartości Word Error Rate są wygładzane przed pomiarem, więc luka w dokładności między lokalnym a chmurowym rozwiązaniem poszerza się na dźwiękach z akcentem, hałaśliwych lub technicznie gęstych, nie pojawiając się w żadnej karcie specyfikacji. Razem wskazują na testowanie na własnym reprezentatywnym dźwięku przed zobowiązaniem się do jakiegokolwiek narzędzia, offline lub innego.
Zacznij od oprogramowania do transkrypcji, które pozwala przesłać prawdziwy plik, w tym Twój najtrudniejszy dźwięk, na darmowym koncie bez karty kredytowej. Jeśli wynik jest wystarczająco czysty, by na nim działać, zweryfikowałeś narzędzie w swoich rzeczywistych warunkach, zanim cokolwiek wydałeś.
Często zadawane pytania
Czy transkrypcja offline jest rzeczywiście zgodna z HIPAA, czy nadal muszę się martwić?
HIPAA wymaga umów o przetwarzaniu danych, a w wielu przypadkach wyraźnej zgody podmiotu, zanim osobisty dźwięk zostanie przekazany zewnętrznemu procesorowi, więc architektura ma ogromne znaczenie. Narzędzie, które uruchamia pełne wnioskowanie modelu lokalnie bez żadnych wywołań sieciowych na żadnym etapie, spełnia podstawowy wymóg – dźwięk nigdy nie dociera do serwera zewnętrznego – podczas gdy narzędzia, które po cichu przechodzą do interfejsów API chmury dla trudnego dźwięku lub kierują kroki przetwarzania końcowego, takie jak diaryzacja, na zewnątrz, tworzą dokładnie to narażenie, któremu HIPAA ma zapobiegać. Cały potok musi być w pełni audytowalny na każdym etapie, nie tylko główny etap transkrypcji.
Czy transkrypcja offline rzeczywiście dobrze działa na Macach z Apple Silicon, czy jest zbyt wolna, by była praktyczna?
Apple Silicon to jedna z najlepszych platform do lokalnego wnioskowania Whisper. Whisper.cpp uruchamia pełne lokalne wnioskowanie modelu AI, wykorzystując Neural Engine Apple Silicon, i osiąga współczynniki czasu rzeczywistego znacznie poniżej 1.0 w wariantach modeli medium i large, co oznacza, że 10-minutowe nagranie kończy się w mniej niż 10 minut na nowoczesnym MacBooku. 16 GB Apple M3 MacBook Pro może bezproblemowo uruchomić Whisper Large-v3, ponieważ Apple Silicon przenosi wnioskowanie do Neural Engine.
Skąd mam wiedzieć, jaki rozmiar modelu Whisper faktycznie zainstalować na swoim laptopie?
Zacznij od sufitu swojego sprzętu: znajdź największy model, który mieści się w dostępnej pamięci RAM lub VRAM, a następnie sprawdź, czy jego dokładność spełnia Twoje potrzeby. Tiny i Base działają na standardowej pamięci RAM bez GPU, ale dają wyższe wskaźniki błędów na wszystkim poza czystym dźwiękiem jednego mówcy; Small i Medium wymagają skromnych zasobów GPU lub wydajnego CPU; Large-v3 potrzebuje co najmniej 8 GB pamięci VRAM GPU. Dla większości profesjonalnych użytkowników na wydajnym sprzęcie Medium jest uczciwym złotym środkiem; dla użytkowników, których sprzęt nie jest w stanie tego udźwignąć, a których dźwięk może opuścić urządzenie, transkrypcja w chmurze Cockatoo działa na własnych serwerach, więc jakość wyniku zależy od modelu i dźwięku, a nie od ilości pamięci RAM w laptopie.
Jeśli narzędzie deklaruje „nie wymaga internetu”, czy to oznacza, że moje audio na pewno pozostaje na moim urządzeniu?
Nie, etykieta „nie wymaga internetu” gwarantuje jedynie, że narzędzie może działać bez połączenia z siecią, a nie że nigdy nie podejmie prób wywołań sieciowych, gdy połączenie jest dostępne. Wiele narzędzi po cichu przechodzi na wywołania API w chmurze, gdy audio jest zaszumione lub z akcentem, a etapy przetwarzania końcowego, takie jak przywracanie interpunkcji, diaryzacja mówców i wykrywanie języka, są często obsługiwane po stronie serwera, nawet gdy podstawowy model akustyczny działa lokalnie. Krokiem weryfikacji jest przeprowadzenie przechwytywania pakietów podczas rzeczywistego zaszumionego nagrania i sprawdzenie, czy podczas transkrypcji występują jakiekolwiek połączenia wychodzące do punktu końcowego API.
Czy rozdzielanie mówców (diaryzacja) jest obsługiwane lokalnie, czy jest wysyłane do chmury?
Diaryzacja mówców jest jednym z etapów przetwarzania końcowego, który często jest obsługiwany po stronie serwera, nawet gdy podstawowy model akustyczny działa lokalnie; wpis wyraźnie wymienia ją obok przywracania interpunkcji i wykrywania języka jako etapy potoku, które mogą po cichu kierować dane na zewnątrz. Ponieważ gwarancja prywatności narzędzia obowiązuje tylko wtedy, gdy każdy etap potoku jest weryfikowalnie lokalny, użytkownicy obsługujący wrażliwe audio muszą audytować diaryzację jako niezależną funkcję, a nie zakładać, że obejmuje ją najwyższego poziomu odznaka „offline”.






