วิธีถอดเสียงสัมภาษณ์อย่างรวดเร็วและแม่นยำใน 2026

การถอดเสียงอาจใช้เวลา 6 ชั่วโมงต่อเสียงหนึ่งชั่วโมง การแก้ปัญหาเริ่มต้นจากการตัดสินใจหนึ่งอย่างที่คนส่วนใหญ่ข้ามไป: การเลือกรูปแบบที่เหมาะสมก่อนที่จะอัปโหลดไฟล์แรก
เสียงสัมภาษณ์ที่บันทึกไว้ทุกชั่วโมงมีต้นทุนแอบแฝงอยู่ ก่อนที่ข้อค้นพบใดจะไปถึงรายงาน คำพูดใดจะไปอยู่ในบทความ หรือลูกค้าจะได้รับบทสรุป ต้องมีใครสักคนเปลี่ยนเสียงนั้นให้เป็นข้อความที่อ่านได้ คนคนนั้นมักเป็นคนเดียวกับผู้สัมภาษณ์ ผู้จัดตารางการโทร และยังมีเดดไลน์อีกสามอย่างรออยู่ เครื่องมืออย่างแอปถอดเสียงของ Cockatoo มีอยู่เพราะคนคนนั้นไม่สามารถสูญเสียวันทำงานเต็มวันไปกับงานที่เกิดขึ้นก่อนงานจริงจะเริ่มได้ ดูแอปถอดเสียงของเราเพื่อดูว่าสิ่งนี้ทำงานอย่างไรในทางปฏิบัติ
"การถอดเสียงด้วยมือใช้เวลามากพอที่ผู้คนจะหาเครื่องมือมาทำงานนี้โดยอัตโนมัติ ซึ่งหมายความว่ามัน 'ขโมย' เวลาจำนวนมากไปจากวันของพวกเขา" — สิ่งที่เราได้ยินจากผู้ใช้เครื่องมือถอดเสียง
ตามข้อมูลจาก Tinrec Blog การถอดเสียงด้วยมือใช้เวลาพิมพ์ประมาณ 4 ถึง 6 ชั่วโมงต่อเสียงที่บันทึกไว้ทุก 1 ชั่วโมง สำหรับผู้ประสานงานปฏิบัติการที่ทำงานคนเดียวและจัดการประชุมค้นหาข้อมูลสามครั้งต่อสัปดาห์ การถอดเสียงเพียงอย่างเดียวอาจกินเวลาส่วนใหญ่ของสัปดาห์ทำงานก่อนที่การวิเคราะห์ การจัดรูปแบบ หรือการส่งมอบจะเริ่มต้น ต้นทุนคือเวลาและผลกระทบที่ทบทวีต่อทุกสิ่งในลำดับถัดไป
4 ถึง 6 ชั่วโมง ของการพิมพ์ต่อเสียงที่บันทึกไว้หนึ่งชั่วโมง
สมมติฐานทั่วไปคือคำบรรยายอัตโนมัติฟรีนั้น "ดีพอ" หากผ่านการทำความสะอาดอย่างรวดเร็วหนึ่งรอบ ในทางปฏิบัติ เครื่องมือฟรีล้มเหลวกับคำพูดที่มีสำเนียง การพูดทับกัน และการบันทึกภาคสนาม ทำให้ได้ผลลัพธ์ที่ต้องใช้เวลาการแก้ไขเกือบพอๆ กับการถอดเสียงตั้งแต่ต้น
การแก้ไขข้อผิดพลาดของคนอื่นช้ากว่าการสร้างขึ้นมาจากความเงียบ เพราะทุกบรรทัดต้องใช้วิจารณญาณ: นี่ผิดหรือแค่ฟังดูเก้ๆ กังๆ? แบบจำลองทางความคิดที่คนส่วนใหญ่มี คือการถอดเสียงเป็นการเลือกแบบสองทางระหว่างการพิมพ์ด้วยมือที่ช้าแต่แม่นยำกับการบรรยายอัตโนมัติที่เร็วแต่เละ นั้นพังทลายลงทันทีเมื่อการบันทึกมีผู้พูดสองคน มีสำเนียงที่ไม่ใช่เจ้าของภาษา หรือมีเสียงรบกวนเบื้องหลัง ก่อนที่เครื่องมือใดจะกู้ชั่วโมงเหล่านั้นคืนมาได้ มีการตัดสินใจหนึ่งอย่างที่กำหนดทุกสิ่งในลำดับถัดไป: การเลือกรูปแบบการถอดเสียงที่เหมาะสมสำหรับสัมภาษณ์เฉพาะของคุณ เลือกผิดแล้วแม้แต่ผลลัพธ์ AI ที่ดีที่สุดก็ยังต้องจัดรูปแบบใหม่หลายชั่วโมงกว่าจะใช้งานได้
ประเด็นสำคัญ
- การถอดเสียงด้วยมือของบทสัมภาษณ์หนึ่งชั่วโมงมักกินเวลาส่วนใหญ่ของวันทำงาน คอขวดไม่ใช่ทักษะหรือความอดทนอีกต่อไป แต่เป็นปัญหากระบวนการทำงานที่แก้ไขได้
- การเลือกรูปแบบการถอดเสียงผิด (คลีนเวอร์แบตัม vs. อินเทลลิเจนต์เวอร์แบตัม vs. ฟูลเวอร์แบตัม) ก่อนเริ่มคือการตัดสินใจที่มีผลกระทบมากที่สุดในกระบวนการ และทีมส่วนใหญ่ทำโดยบังเอิญ
- กระบวนการทำงาน AI ที่ตั้งค่าอย่างถูกต้อง อัปโหลด กำหนดจำนวนผู้พูด ส่งออก จะคืนบทถอดเสียงหนึ่งชั่วโมงในเวลาประมาณสามนาที ไม่ใช่สามชั่วโมง
- ที่ความแม่นยำรอบแรก 97-98% การตรวจทานบทถอดเสียง AI เป็นด่านคุณภาพ ไม่ใช่งานแก้ไข: คาดว่าจะมีข้อผิดพลาดระดับคำ 60-120 คำตลอดหนึ่งชั่วโมงเต็ม ไม่ใช่หลายร้อยคำ
- องค์ประกอบเชิงโครงสร้างห้าอย่าง (ข้อมูลเมตาส่วนหัว ป้ายผู้พูด การประทับเวลา อนุสัญญาการเขียน และการจัดรูปแบบที่สอดคล้อง) เป็นตัวกำหนดว่าบทถอดเสียงจะเป็นเครื่องมือที่ใช้งานได้หรือเป็นโปรเจกต์ทำความสะอาด
- โครงสร้างการเรียกเก็บเงินแบบสมัครสมาชิกคือการตัดสินใจเรื่องการถอดเสียงที่ผู้ซื้อส่วนใหญ่เพิกเฉย และเป็นตัวกำหนดว่าเครื่องมือจะยังคงจับต้องได้ในราคาที่เหมาะสมเมื่อใช้งานปริมาณมากหรือไม่
- Cockatoo ปิดวงจร: อัปโหลดไฟล์เสียงหรือวิดีโอใดก็ได้ กำหนดจำนวนผู้พูดเพื่อให้การเปลี่ยนชื่อผู้พูดหนึ่งคนอัปเดตทุกบรรทัด และรับบทถอดเสียงที่ใส่เครื่องหมายวรรคตอน ใช้อักษรตัวพิมพ์ใหญ่ และแก้ไขได้กลับมา พร้อมการประทับเวลาระดับคำและการทดสอบความแม่นยำที่เผยแพร่ครอบคลุม 30 ภาษาเพื่อรองรับข้อกล่าวอ้าง
รูปแบบการถอดเสียงหลักสามแบบคืออะไรและควรใช้แต่ละแบบเมื่อใด
การเลือกสไตล์การถอดเสียงผิดก่อนเริ่มต้นไม่ใช่ปัญหาเรื่องการจัดรูปแบบ สิ่งที่ทีมส่วนใหญ่รายงานคือมันเป็นการตัดสินใจครั้งแรกและสำคัญที่สุดในกระบวนการถอดเสียง เพราะความไม่สอดคล้องบังคับให้ต้องทำใหม่ทั้งหมด และการทำใหม่บนบทสัมภาษณ์ความยาว 60 นาทีอาจใช้เวลามากกว่าการทำรอบแรกเสียอีก การเลือกนี้อยู่เหนือทุกเครื่องมือ ทุกคีย์ลัด ทุกการตั้งค่าการส่งออก ทำให้ถูกต้องใน 30 วินาทีแรกของการตั้งค่า แล้วส่วนที่เหลือของกระบวนการจะดำเนินไปอย่างราบรื่น
หนึ่งในความยากลำบากที่ผู้เริ่มต้นเผชิญบ่อยที่สุดคือการไม่รู้ว่าโปรเจกต์ของตนต้องการสไตล์ใดจริงๆ บรรณาธิการพอดแคสต์เลือกแบบคำต่อคำเต็มรูปแบบเพราะความระมัดระวัง นักวิจัยเชิงคุณภาพพอใจกับบทสรุปเพราะดูเรียบร้อยกว่า และครีเอเตอร์ยูทูบเลือกโหมดผิดไปเลยเพราะเครื่องมือไม่เคยอธิบายความแตกต่าง ความไม่สอดคล้องนั้นแก้ไขได้ด้วยการเข้าใจจุดประสงค์เบื้องหลังแต่ละสไตล์ก่อนอัปโหลดไฟล์แรก
ทั้งสามสไตล์แบ่งตามจุดประสงค์ รูปแบบที่พบบ่อยคือผู้คนปฏิบัติต่อสไตล์เหล่านี้เป็นจุดบนมาตรวัดความเป็นทางการ โดยปรับแต่งผลลัพธ์ใดก็ตามที่เครื่องมือมอบให้ ในทางปฏิบัติแต่ละสไตล์ตอบคำถามเชิงวิเคราะห์ที่แตกต่างกัน และการเลือกผิดไม่เพียงสร้างงานแก้ไขเพิ่มเติมเท่านั้น แต่ยังทำให้บทถอดเสียงใช้วิเคราะห์ไม่ได้อีกด้วย
1. คำต่อคำเต็มรูปแบบ - ทุกคำเชื่อม คำพูดติดขัด และสัญญาณอวัจนภาษา ถูกบันทึกไว้

คำต่อคำเต็มรูปแบบบันทึกทุกถ้อยคำตามที่พูดจริง ทั้งคำเชื่อม คำเริ่มต้นผิดๆ การพูดซ้ำ การพูดติดขัด และสัญญาณอวัจนภาษา เช่น การหัวเราะหรือการหยุดชั่วคราว ทั่วทั้งตลาด สไตล์นี้จำเป็นเมื่อวิธีการพูดเป็นข้อมูลในตัวเอง เช่น ในการวิเคราะห์วาทกรรม การวิเคราะห์บทสนทนา หรือการดำเนินคดีทางกฎหมาย สิ่งที่ต้องแลกมาคือเวลาแก้ไข การทำคำต่อคำเต็มรูปแบบบนเสียงที่ต้องการเพียงคำต่อคำแบบเรียบเรียงจะเพิ่มงานทำความสะอาดปลายน้ำเป็นสองเท่าโดยไม่เพิ่มคุณค่าเชิงวิเคราะห์ใดๆ ดังนั้นจึงควรเก็บไว้สำหรับโปรเจกต์ที่วิธีการพูดมีความสำคัญเท่ากับสิ่งที่พูด
เมื่อเนื้อหาต้นฉบับไม่ใช่ภาษาอังกฤษ ความสำคัญของการเลือกสไตล์ยิ่งเพิ่มขึ้น การเลือกสไตล์ผิดในบทสัมภาษณ์หลายภาษาสร้างปัญหาเดียวกันคือต้องทำใหม่ซึ่งมีค่าใช้จ่ายในทุกภาษา
2. คำต่อคำแบบเรียบเรียง - เนื้อหาที่มีความหมายคงไว้ คำเชื่อมที่รบกวนตัดออก
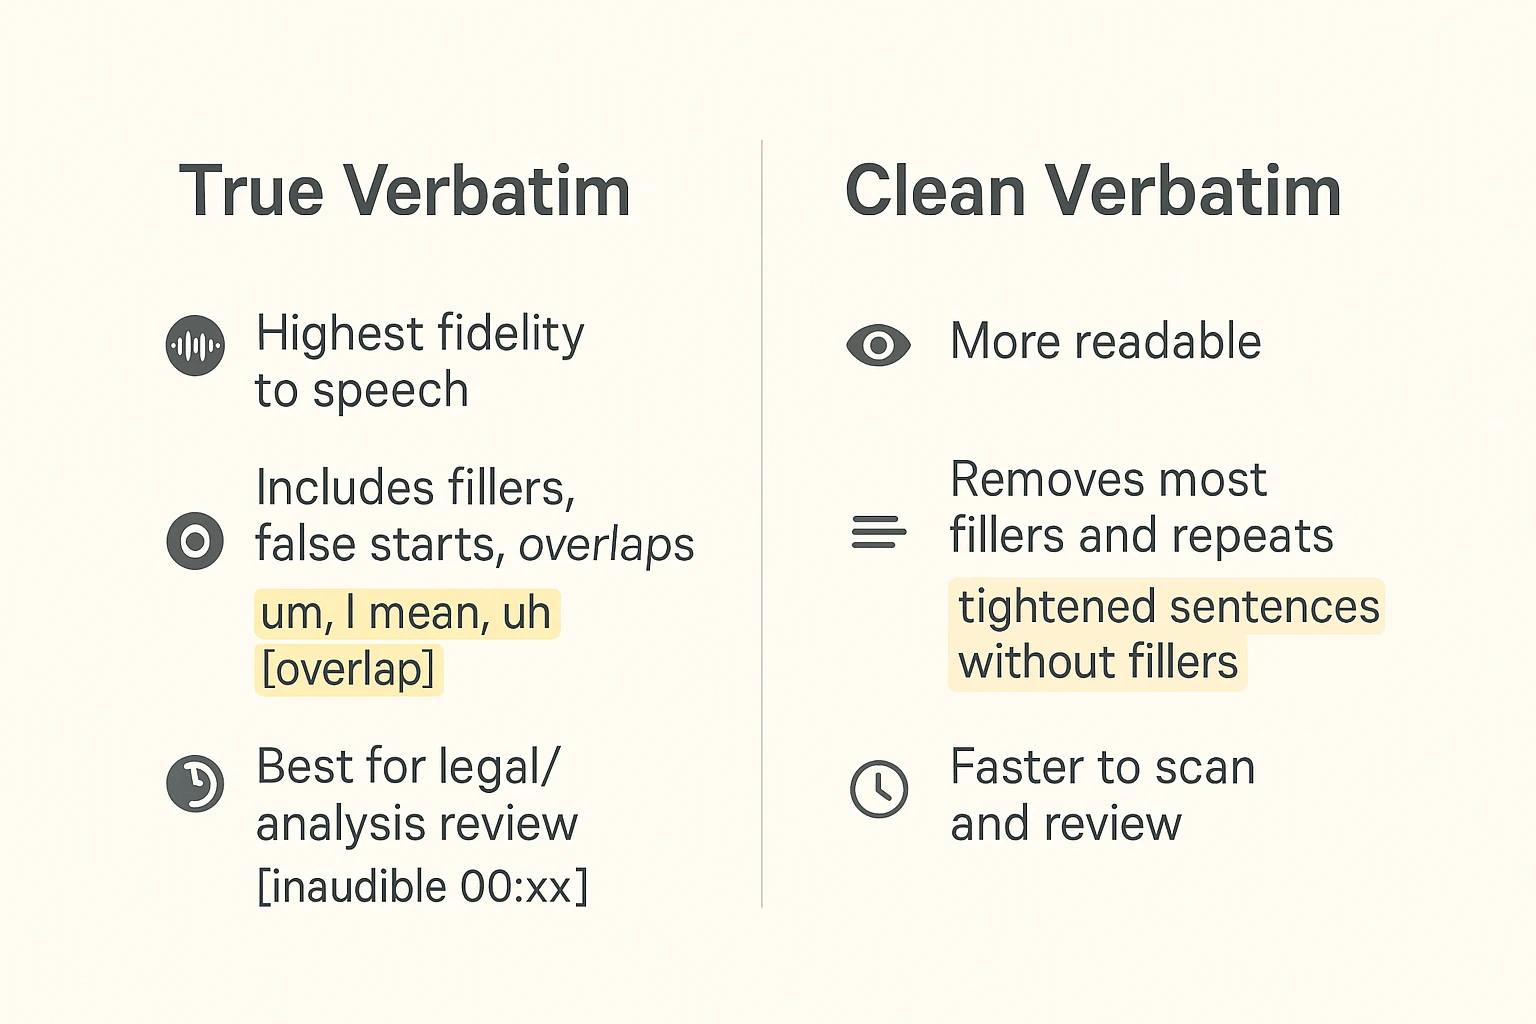
คำต่อคำแบบเรียบเรียง (หรือเรียกว่าคำต่อคำอัจฉริยะ) ตัดคำเชื่อม คำเริ่มต้นผิดๆ และการพูดตะกุกตะกักออก โดยคงทุกคำที่มีสาระไว้ครบถ้วน แนวโน้มอุตสาหกรรมที่กว้างขึ้นระบุว่าสไตล์นี้เป็นที่ต้องการสำหรับการวิเคราะห์เชิงใจความ วารสารศาสตร์ รายงานธุรกิจ และคลังวิจัยทั่วไปที่ความอ่านง่ายสำคัญกว่าการบันทึกทุกรายละเอียดของเสียง นี่คือค่าเริ่มต้นที่ถูกต้องสำหรับกรณีการใช้งานระดับโปรซูเมอร์ส่วนใหญ่: ผู้จัดการการตลาดที่ดึงคำพูดสำหรับกรณีศึกษา นักวิจัยที่เข้ารหัสหัวข้อในชุดข้อมูลเชิงคุณภาพ หรือผู้ประกอบการเดี่ยวที่เปลี่ยนการโทรกับลูกค้าเป็นเอกสารที่แบ่งปันได้
เครื่องมือถอดเสียงของ Cockatoo ใช้เครื่องหมายวรรคตอนและการใช้อักษรตัวพิมพ์ใหญ่อัตโนมัติ ผลลัพธ์คำต่อคำแบบเรียบเรียงจึงออกมามีโครงสร้างและอ่านง่ายโดยไม่ต้องจัดรูปแบบด้วยมือ สำหรับผู้ใช้ระดับฟรี ไม่ต้องใช้บัตรเครดิต สูงสุดสามไฟล์ต่อวัน ผลลัพธ์แบบเรียบเรียงอัตโนมัตินั้นลดการตัดสินใจเรื่องการตั้งค่าอีกหนึ่งขั้นออกจากกระบวนการตั้งแต่วันแรก ผู้ใช้ Pro ได้รับการถอดเสียงแบบไม่จำกัดอย่างแท้จริงในโหมดเริ่มต้นโดยไม่มีเพดานชั่วโมงรายเดือน และมีโหมดความแม่นยำสูงสุดให้ใช้เมื่อโปรเจกต์ต้องการการถอดเสียงแบบคำต่อคำเรียบเรียงที่แม่นยำที่สุดเท่าที่เป็นไปได้ โดยมีขีดจำกัดการใช้งานรายสัปดาห์แสดงใน Settings และโหมดไม่จำกัดพร้อมใช้เป็นทางเลือกสำรองเสมอ
เมื่อบทถอดเสียงที่เสร็จแล้วต้องถูกส่งต่อไปยังลูกค้า ผู้จัดพิมพ์ หรือเพื่อนร่วมงาน Cockatoo ส่งออกในรูปแบบ PDF, DOCX, TXT และ SRT โดยรองรับการส่งออกแบบกลุ่มบน Pro นั่นหมายความว่าบทถอดเสียงแบบคำต่อคำเรียบเรียงออกจากเครื่องมือในรูปแบบใดก็ตามที่กระบวนการปลายน้ำต้องการ โดยไม่มีขั้นตอนการแปลง
3. การถอดเสียงแบบสรุป - เฉพาะข้อมูลเชิงลึกหลัก ตัดส่วนนอกประเด็นออก
การถอดความแบบสรุปจะบันทึกเฉพาะข้อมูลเชิงลึกหลักและประโยคสำคัญ โดยตัดประเด็นนอกเรื่องที่ไม่เกี่ยวข้องออกทั้งหมด ไม่ว่าจะวัดด้วยมาตรฐานใด นี่คือสไตล์ที่ผลิตได้เร็วที่สุด แต่ต้องแลกมาด้วยการสูญเสียความละเอียดอ่อน และไม่เหมาะสำหรับการวิเคราะห์ใด ๆ ที่ต้องการถ้อยคำที่แน่นอนของผู้พูด ใช้งานได้ดีสำหรับการบรีฟภายในหรือบันทึกอ้างอิงฉบับเร็วที่ผู้อ่านต้องการเพียงข้อสรุป ไม่ใช่บทสนทนาทั้งหมด ข้อจำกัดที่ชัดเจนคือ หากผู้มีส่วนได้ส่วนเสียถามหาคำพูดโดยตรงในภายหลัง หรือนักวิจัยต้องการตรวจสอบธีมที่ลงรหัสไว้กับต้นฉบับ บทถอดความแบบสรุปไม่สามารถให้สิ่งนั้นได้ โครงการที่เริ่มต้นด้วยผลลัพธ์แบบสรุปและต่อมาต้องการความครอบคลุมแบบคำต่อคำจะต้องทำใหม่ทั้งหมดจากไฟล์เสียงต้นฉบับ
Cockatoo's Canvas เครื่องมือแก้ไขโน้ต AI ที่รวมอยู่ในทุกแพ็กเกจรวมถึงระดับฟรี คือที่เก็บผลลัพธ์แบบสรุปที่ใช้งานได้จริง แทนที่จะมอบบทถอดความทั้งหมดให้กับสไตล์สรุปและสูญเสียต้นฉบับ คุณสามารถถอดความแบบเต็มหรือแบบคำต่อคำที่สะอาด เก็บไฟล์นั้นไว้ในพื้นที่จัดเก็บ Cockatoo ของคุณ และใช้ Canvas เพื่อดึงและจัดระเบียบข้อมูลเชิงลึกหลักแยกต่างหาก ด้วยวิธีนี้ บทสรุปจะตอบโจทย์การบรีฟโดยไม่ทำลายบันทึกเชิงวิเคราะห์
เมื่อคุณรู้แล้วว่าโครงการของคุณต้องการสไตล์ใด คำถามถัดไปคือเครื่องมือและการตั้งค่าของคุณสามารถส่งมอบได้จริงหรือไม่โดยไม่เพิ่มความยุ่งยากกลับเข้าไปในกระบวนการ นั่นคือจุดที่ผลกำไรหรือการสูญเสียด้านเวลาส่วนใหญ่ถูกตัดสินอย่างแท้จริง
ต้องใช้เครื่องมือและการตั้งค่าใดสำหรับการถอดความด้วยมือเทียบกับการถอดความด้วยความช่วยเหลือของ AI
สำหรับการถอดความด้วยมือ การตั้งค่าที่เหมาะสมคือโปรแกรมเล่นสื่อที่มีปุ่มลัดทั่วระบบกำหนดไว้สำหรับหยุดชั่วคราว กรอกลับ และกรอไปข้างหน้า พร้อมหูฟังแบบตอบสนองเรียบที่ถ่ายทอดความถี่ของเสียงพูดโดยไม่เสริมเบสหรือทวีเบิล ปุ่มลัดสำคัญกว่าที่คนส่วนใหญ่คาดไว้: การยกมือออกจากคีย์บอร์ดเพื่อคลิกควบคุมด้วยเมาส์เพิ่มความยุ่งยากทุกครั้งที่หยุดชั่วคราว และวินาทีเหล่านั้นสะสมทบ compounding ตลอดเซสชันสี่ถึงหกชั่วโมง oTranscribe และ Express Scribe เป็นเครื่องมือสองตัวที่นักวิจัยและนักข่าวหยิบใช้บ่อยที่สุด ทั้งเพราะรองรับคีย์บอร์ดช็อตคัตโดยกำเนิด และเพราะทำงานในเบราว์เซอร์หรือสภาพแวดล้อมเดสก์ท็อปโดยไม่ต้องใช้โปรแกรมแก้ไขเสียงแยกต่างหาก
1 ชุดอุปกรณ์ถอดความด้วยมือ - โปรแกรมเล่นสื่อพร้อมปุ่มลัดทั่วระบบและหูฟังแบบตอบสนองเรียบ
ชุดอุปกรณ์ด้วยมือที่เหมาะสมคือ oTranscribe หรือ Express Scribe พร้อมปุ่มลัดทั่วระบบที่กำหนดให้หยุดชั่วคราว กรอกลับห้าวินาที และควบคุมความเร็ว จับคู่กับหูฟังแบบปิดหลังที่ถ่ายทอดเสียงพูดได้ชัดเจน การตั้งค่านี้เป็นการเลือกที่ถูกต้องเมื่อสถาบันของคุณต้องการบันทึกที่ผ่านการตรวจสอบโดยมนุษย์ หรือเมื่อคุณภาพเสียงแย่เกินไปสำหรับเครื่องมืออัตโนมัติใด ๆ การแลกเปลี่ยนที่แท้จริง: แม้แต่ชุดอุปกรณ์ที่กำหนดค่าอย่างดีก็ยังต้องแลกกับการพิมพ์จริงสี่ถึงหกชั่วโมงต่อเสียงบันทึกหนึ่งชั่วโมง
2 เวิร์กโฟลว์อัปโหลดและรับข้อความด้วยความช่วยเหลือของ AI - รวมป้ายชื่อผู้พูด การประทับเวลา และการเว้นวรรคอัตโนมัติ
อัปโหลดไฟล์ กำหนดจำนวนผู้พูด และรับบทถอดความพร้อมป้ายชื่อผู้พูด การประทับเวลาระดับคำ และการเว้นวรรคที่ใช้โดยอัตโนมัติ เวิร์กโฟลว์นี้ย่นชั่วโมงการพิมพ์ให้เหลือเพียงไม่กี่นาทีในการตรวจทาน เครื่องมือคำบรรยายอัตโนมัติฟรีล้มเหลวกับเสียงที่มีสำเนียงและการพูดทับซ้อนในลักษณะที่ต้องถอดความใหม่เกือบทั้งหมด ขณะที่เครื่องมือถอดความ AI ที่สร้างขึ้นเพื่อจุดประสงค์เฉพาะด้วยความแม่นยำสูงต้องการเพียงการแก้ไขเฉพาะจุดสำหรับคำนามเฉพาะและคำย่อ การถือว่าเครื่องมือสองระดับนี้เทียบเท่ากันทำให้ผู้คนมองข้ามการถอดความ AI ว่าไม่น่าเชื่อถือ
ความสามารถหนึ่งที่ใช้ไม่มากที่ควรกล่าวถึง: Cockatoo รองรับการนำเข้าลิงก์ ดังนั้นหากการสัมภาษณ์หรือการบันทึกเสียงของคุณอยู่ที่ URL อยู่แล้ว ไม่ว่าจะเป็นวิดีโอ YouTube ตอนพอดแคสต์ หรือไฟล์คลาวด์ที่แชร์ คุณสามารถวางลิงก์โดยตรงแทนการดาวน์โหลดและอัปโหลดไฟล์ใหม่ ซึ่งขจัดขั้นตอนที่สูญเสียเวลาเงียบ ๆ ตลอดโครงการขนาดใหญ่ อัปโหลดไฟล์เสียงหรือวิดีโอใด ๆ และรับบทถอดความที่แก้ไขได้กลับคืน พร้อมรวมสิ่งต่อไปนี้:
- การจดจำผู้พูดพร้อมจำนวนผู้พูดที่กำหนดได้; การเปลี่ยนชื่อผู้พูดจะอัปเดตทุกบรรทัด
- การประทับเวลาระดับคำ พร้อมตัวเลือกการส่งออกแบบย่อหน้า ประโยค และการสลับผู้พูด; การเว้นวรรคและตัวพิมพ์ใหญ่ใช้โดยอัตโนมัติ
- สไตล์คำต่อคำที่สะอาดโดยค่าเริ่มต้น; ไม่มีการลดสัญญาณรบกวนกับไฟล์ที่อัปโหลด
การทดสอบความแม่นยำที่เผยแพร่ครอบคลุม 30 ภาษาที่รันบนชุดทดสอบสาธารณะชุดเดียวกับที่นักวิจัยใช้เปรียบเทียบเอนจินถอดความ รวมถึงไฟล์บันทึกในโลกจริงที่มีเสียงรบกวนพื้นหลังและสำเนียง โดยมีความครอบคลุมรายภาษาบนหน้า benchmarks เพื่อให้คุณตรวจสอบความแม่นยำสำหรับภาษาที่คุณใช้ก่อนเริ่มประมวลผลเป็นชุด เมื่อไฟล์บันทึกต้องการคำบรรยายหรือซับไทเทิลที่เผยแพร่ด้วย Cockatoo การใส่คำบรรยายวิดีโอและการส่งออกซับไทเทิลจัดการเรื่องนั้นในขั้นตอนการทำงานเดียวกัน และหากมีเอกสารประกอบใด ๆ ที่ต้องอ่านหรือส่งในภาษาอื่น PDF และการแปลเอกสารรองรับ PDF, DOCX, PPTX, XLSX และรูปแบบ TXT
นอกเหนือจากการถอดความ ชั้นการสรุปด้วย AI มีความสำคัญที่สุดกับไฟล์บันทึกยาว ๆ แทนที่จะอ่านทรานสคริปต์สองชั่วโมงเพื่อหาการตัดสินใจสามข้อที่ต้องดำเนินการ คุณสามารถดึงเฉพาะสิ่งที่มีความจำเป็นต่อการตอบกลับออกมาได้จริง ซึ่งเป็นการบีบอัดเวลาที่ได้ผลจริงและทวีคูณขึ้นตลอดโครงการวิจัยที่มีการสัมภาษณ์หลายสิบครั้ง
3. Otter.ai vs Cockatoo - การเน้นบอทประชุม vs ความเรียบง่ายของการอัปโหลดไฟล์
Otter.ai ถูกออกแบบมาเพื่อกรณีการใช้งานที่มีคุณค่าจริง: การเข้าร่วมการโทรสดบน Zoom, Teams หรือ Google Meet และสร้างทรานสคริปต์แบบเรียลไทม์โดยไม่มีขั้นตอนการอัปโหลดหลังการประชุม หากความต้องการหลักของคุณคือการถอดความการประชุมในขณะที่บทสนทนายังดำเนินอยู่ สถาปัตยกรรมบอทแบบสดนั้นถือเป็นข้อได้เปรียบจริง ความไม่สอดคล้องจะปรากฏขึ้นเมื่อนักวิจัยพยายามใช้เครื่องมือที่เน้นการประชุมสดกับไฟล์การสัมภาษณ์ภาคสนามที่บันทึกไว้ล่วงหน้าซึ่งมีอยู่แล้วในรูปแบบไฟล์เสียงหรือวิดีโอ ขั้นตอนการเชิญบอทและการอนุญาตปฏิทินเพิ่มขั้นตอนที่ไม่เกี่ยวข้องเลย
เครื่องมือที่สร้างขึ้นรอบการอัปโหลดไฟล์ และการนำเข้าลิงก์สำหรับไฟล์บันทึกที่มี URL อยู่แล้ว จะคืนทรานสคริปต์ที่ติดป้ายผู้พูดในการอัปโหลดครั้งแรก โดยไม่ต้องเข้าถึงปฏิทินและไม่มีบอทให้กำหนดค่า ซึ่งเข้ากับขั้นตอนการทำงานของการสัมภาษณ์ที่บันทึกไว้ล่วงหน้าอย่างเป็นธรรมชาติ ขั้นตอนการทำงานที่เน้นการอัปโหลดไฟล์ช่วยลดเวลาก่อนได้ทรานสคริปต์แรกสำหรับการสัมภาษณ์ที่บันทึกไว้ล่วงหน้าอย่างสม่ำเสมอ เพราะสถาปัตยกรรมสอดคล้องกับงานนั้นโดยตรง
4. ตัวอักษรเล็ก ๆ ของแพ็กเกจ Unlimited - เพดานรายเดือน 720 ชั่วโมง vs ค่าเริ่มต้นที่ไม่จำกัดเชิงโครงสร้างของ Cockatoo
ปัญหาหนึ่งที่กระทบนักวิจัยและเจ้าหน้าที่ปฏิบัติการอย่างหนัก: การประมวลผลไฟล์การสัมภาษณ์ขนาดใหญ่ 50 ไฟล์หรือมากกว่านั้นช้ามากเมื่อเครื่องมือบังคับให้อัปโหลดทีละไฟล์ และจะกลายเป็นเรื่องวิกฤตเมื่อเพดานชั่วโมงรายเดือนที่ซ่อนอยู่หยุดคิวกลางโครงการในขณะที่กำหนดส่งใกล้เข้ามา แพ็กเกจ Pro ของ Cockatoo แก้ปัญหาทั้งสองข้อโดยตรง ในด้านการอัปโหลด Pro รองรับชุดไฟล์สูงสุด 20 ไฟล์ต่อครั้ง ซึ่งลดภาระต่อไฟล์ได้อย่างมีความหมายเมื่อจัดการกับคลังขนาดใหญ่
โหมดที่มีความแม่นยำสูงสุดมีขีดจำกัดการใช้งานรายสัปดาห์ที่แสดงใน Settings ดังนั้นควรตรวจสอบก่อนเริ่มประมวลผลเป็นชุดใหญ่ โหมดไม่จำกัดมาตรฐานยังคงใช้ได้เมื่อถึงขีดจำกัดนั้น Pro ยังรวมถึง Canvas, โปรแกรมแก้ไขบันทึกย่อ AI ของ Cockatoo และการส่งออกเป็น PDF, DOCX, TXT และ SRT พร้อมรองรับการส่งออกแบบกลุ่ม เพื่อให้ทรานสคริปต์ที่เสร็จแล้วย้ายเข้าซอฟต์แวร์วิเคราะห์ของคุณได้โดยตรงโดยไม่ต้องจัดรูปแบบใหม่ พื้นที่จัดเก็บคือ 2 TB ต่อบัญชี
99 USD/เดือน เมื่อชำระรายปีในช่วง Summer Sale ปัจจุบัน 97 USD/เดือน เมื่อชำระรายปี พร้อมพื้นที่จัดเก็บคลาวด์เข้ารหัส 2 TB ต่อคน หากคุณยังไม่พร้อมผูกมัด ระดับ Free ให้คุณทดสอบขั้นตอนการทำงานทั้งหมดโดยไม่ต้องใช้บัตรเครดิต พร้อมทรานสคริปต์สามรายการต่อวัน สูงสุด 30 นาทีต่อรายการ พื้นที่จัดเก็บคลาวด์เข้ารหัส 2 GB และมีรูปแบบการส่งออกทั้งหมดให้ใช้
5. เครื่องมือหลักสำหรับการถอดความการสัมภาษณ์ - จับคู่ซอฟต์แวร์ที่เหมาะสมกับวิธีการและปริมาณของคุณ
การเลือกเครื่องมือกำหนดเพดานที่ชัดเจนให้กับเวิร์กโฟลว์ของคุณก่อนที่คุณจะพิมพ์สักคำ สำหรับงานแบบแมนนวล: oTranscribe (ทำงานบนเบราว์เซอร์ ฟรี) หรือ Express Scribe (เดสก์ท็อป มีฮอตคีย์ครบครัน) พร้อมโปรแกรมเล่นมีเดียที่รองรับการปรับความเร็วการเล่น สำหรับงานที่ใช้ AI ช่วย: เครื่องมือที่เน้นการอัปโหลดไฟล์เป็นหลักพร้อมการนำเข้าลิงก์สำหรับไฟล์บันทึกเสียงจาก URL การจดจำผู้พูด เกณฑ์มาตรฐานความแม่นยำที่เผยแพร่ในหลายภาษา และการส่งออกเป็นรูปแบบที่ซอฟต์แวร์วิเคราะห์ของคุณรับได้ หากคุณถอดเสียงมากกว่าไม่กี่ไฟล์ต่อสัปดาห์ โครงสร้างของแพ็กเกจสำคัญพอๆ กับคะแนนความแม่นยำ โดยเฉพาะอย่างยิ่งว่าจะรองรับการอัปโหลดเป็นชุดหรือไม่ และป้าย "ไม่จำกัด" ยังคงใช้ได้จริงโดยไม่มีเพดานรายเดือนที่ซ่อนอยู่หรือไม่
การเลือกเครื่องมือที่เหมาะสมคือการตัดสินใจที่ทำให้ทุกอย่างหลังจากนั้นเร็วขึ้น บทถัดไปจะพาคุณผ่านเวิร์กโฟลว์ AI แบบสามขั้นตอนที่ชัดเจน ตั้งแต่การอัปโหลดไปจนถึงข้อความที่สะอาดและแก้ไขได้ เพื่อให้คุณเห็นได้อย่างแม่นยำว่าการประหยัดเวลาอยู่ตรงไหน และการตรวจทานห้านาทีหน้าตาเป็นอย่างไรในทางปฏิบัติ
วิธีถอดเสียงการสัมภาษณ์ทีละขั้นตอนโดยใช้เครื่องมือ AI
สามนาที นั่นคือเวลาที่ใช้โดยประมาณในการได้ไฟล์ถอดเสียงกลับมาจากไฟล์การสัมภาษณ์ความยาวหนึ่งชั่วโมงเมื่อตั้งค่าเวิร์กโฟลว์อย่างถูกต้อง ซึ่งเป็นความเร็วในการประมวลผลที่สะท้อนข้อได้เปรียบด้านตัวคูณเวลาจริงที่โมเดลถอดเสียงด้วย AI สมัยใหม่มีเหนือการพิมพ์ด้วยมือ จากข้อมูลของ Tinrec Blog (2026) เครื่องมือถอดเสียงด้วย AI สามารถประหยัดเวลาได้ถึง 90% ของเวลาที่เคยใช้ในการถอดเสียงบันทึกและการสัมภาษณ์ จุดที่ต้องระวังคือคนส่วนใหญ่ยังคงมองเครื่องมือเป็นเพียงนักพิมพ์ที่เร็วกว่า แล้วใช้เวลาหนึ่งชั่วโมงแก้ไขข้อผิดพลาดประเภทเดียวกันซึ่งกิจวัตรการเตรียมก่อนอัปโหลดที่ฉลาดกว่าจะป้องกันได้ทั้งหมด
90% ของเวลาถอดเสียงที่ประหยัดได้ด้วยเครื่องมือ AI
หนึ่งในจุดเจ็บปวดที่รุนแรงที่สุดในเวิร์กโฟลว์นี้คือการประชุมหรือการสัมภาษณ์แบบพบปะซึ่งมีผู้เข้าร่วมสี่ถึงหกคน เมื่อคุณต้องดำเนินบทสนทนาและพยายามบันทึกด้วยมือไปพร้อมกัน การจดบันทึกก็ย่อมได้รับผลกระทบ คุณไม่สามารถมีส่วนร่วมอย่างแข็งขันและในขณะเดียวกันก็สร้างบันทึกที่แม่นยำและระบุแหล่งที่มาข้ามเสียงครึ่งโหลได้ในเวลาเดียวกัน เครื่องมือถอดเสียงด้วย AI ส่วนใหญ่ยิ่งซ้ำเติมปัญหานี้เพราะถูกสร้างขึ้นเพื่อการประชุมเสมือนจริงบน Zoom หรือ Teams เป็นหลัก ทำให้ใครก็ตามที่บันทึกเสียงในห้องประชุม การสัมภาษณ์ภาคสนาม หรือโฟกัสกรุ๊ปไม่มีโซลูชันที่เหมาะสม Cockatoo ถูกออกแบบมาเพื่อจัดการไฟล์เสียงและวิดีโอไม่ว่าจะถูกบันทึกมาอย่างไร ดังนั้นเวิร์กโฟลว์ด้านล่างจึงใช้ได้เช่นกันไม่ว่าการบันทึกของคุณจะมาจากแล็ปท็อป เครื่องบันทึกเสียงแบบพกพา หรือโทรศัพท์ที่วางอยู่บนโต๊ะ
สามขั้นตอนที่สำคัญที่สุดเกิดขึ้นก่อนและทันทีหลังจากที่ AI ทำงาน ไม่ใช่ระหว่างการอ่านทีละบรรทัดอย่างช้าๆ ในภายหลัง
ขั้นตอนที่ 1 - ตัดความเงียบและประเมินการบันทึกของคุณก่อนอัปโหลด
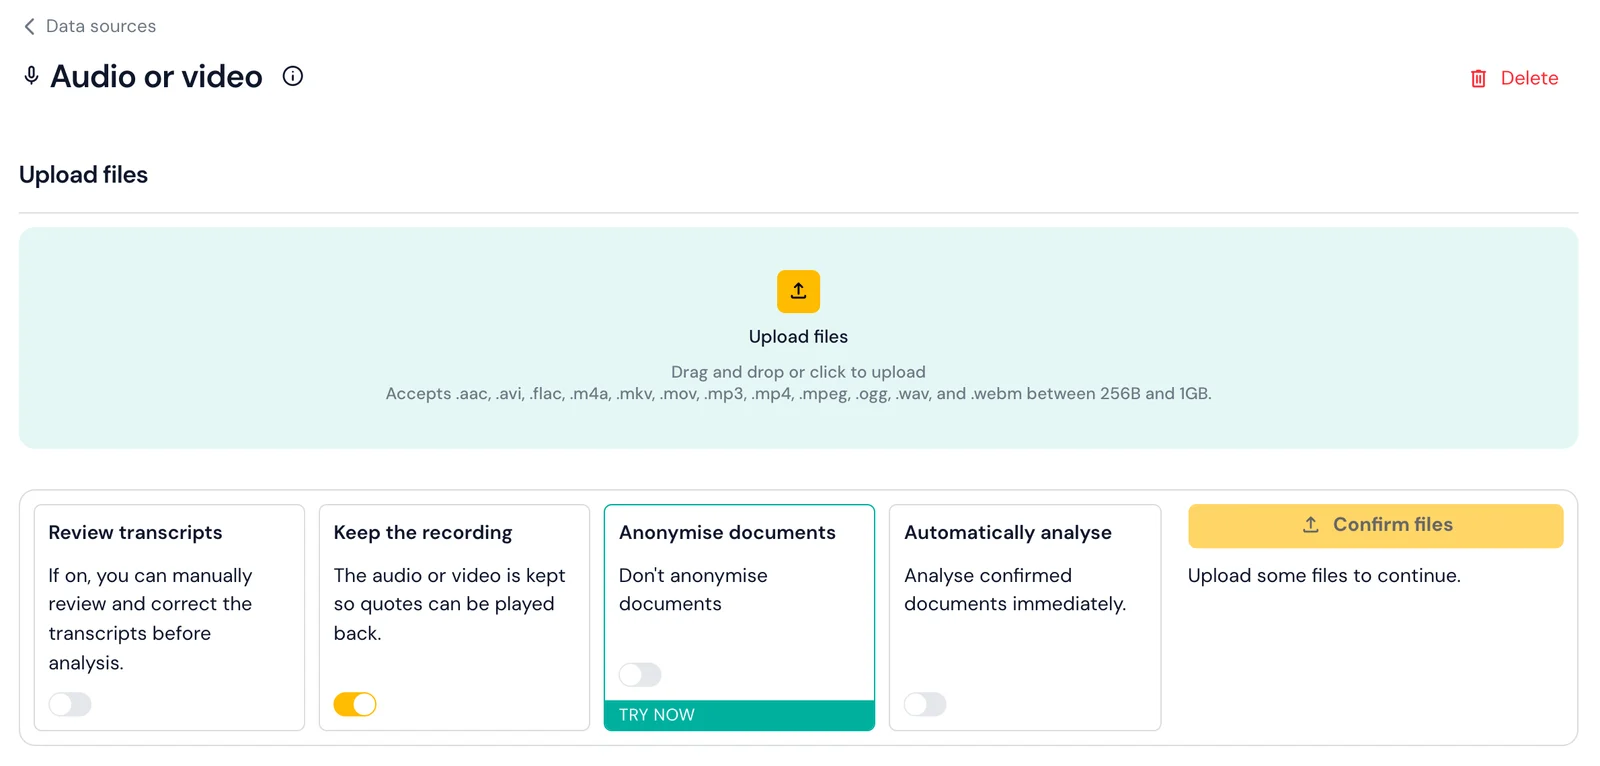
ก่อนจะแตะต้องเครื่องมือ AI ใดๆ ให้ตัดช่วงเงียบจากต้นและท้ายไฟล์ของคุณและจดบันทึกว่ามีผู้พูดที่แตกต่างกันกี่คน ขั้นตอนการเตรียมนี้ช่วยปรับปรุงความแม่นยำของการแยกผู้พูดโดยตรงเพราะโมเดลไม่ต้องเสียการประมวลผลกับความเงียบ นอกจากนี้ควรตัดสินใจล่วงหน้าว่าคุณต้องการผลลัพธ์แบบคำต่อคำที่สะอาดหรือแบบคำต่อคำเต็ม ตัวเลือกนี้กำหนดทุกการตัดสินใจในการแก้ไขหลังจากนั้น ข้อแลกเปลี่ยน: การเตรียมเพิ่ม 5-10 นาทีแต่ประหยัดเวลาในการตรวจทานได้มากกว่ามาก
ขั้นตอนที่ 2 - อัปโหลดไฟล์ของคุณและตั้งจำนวนผู้พูดให้ถูกต้อง
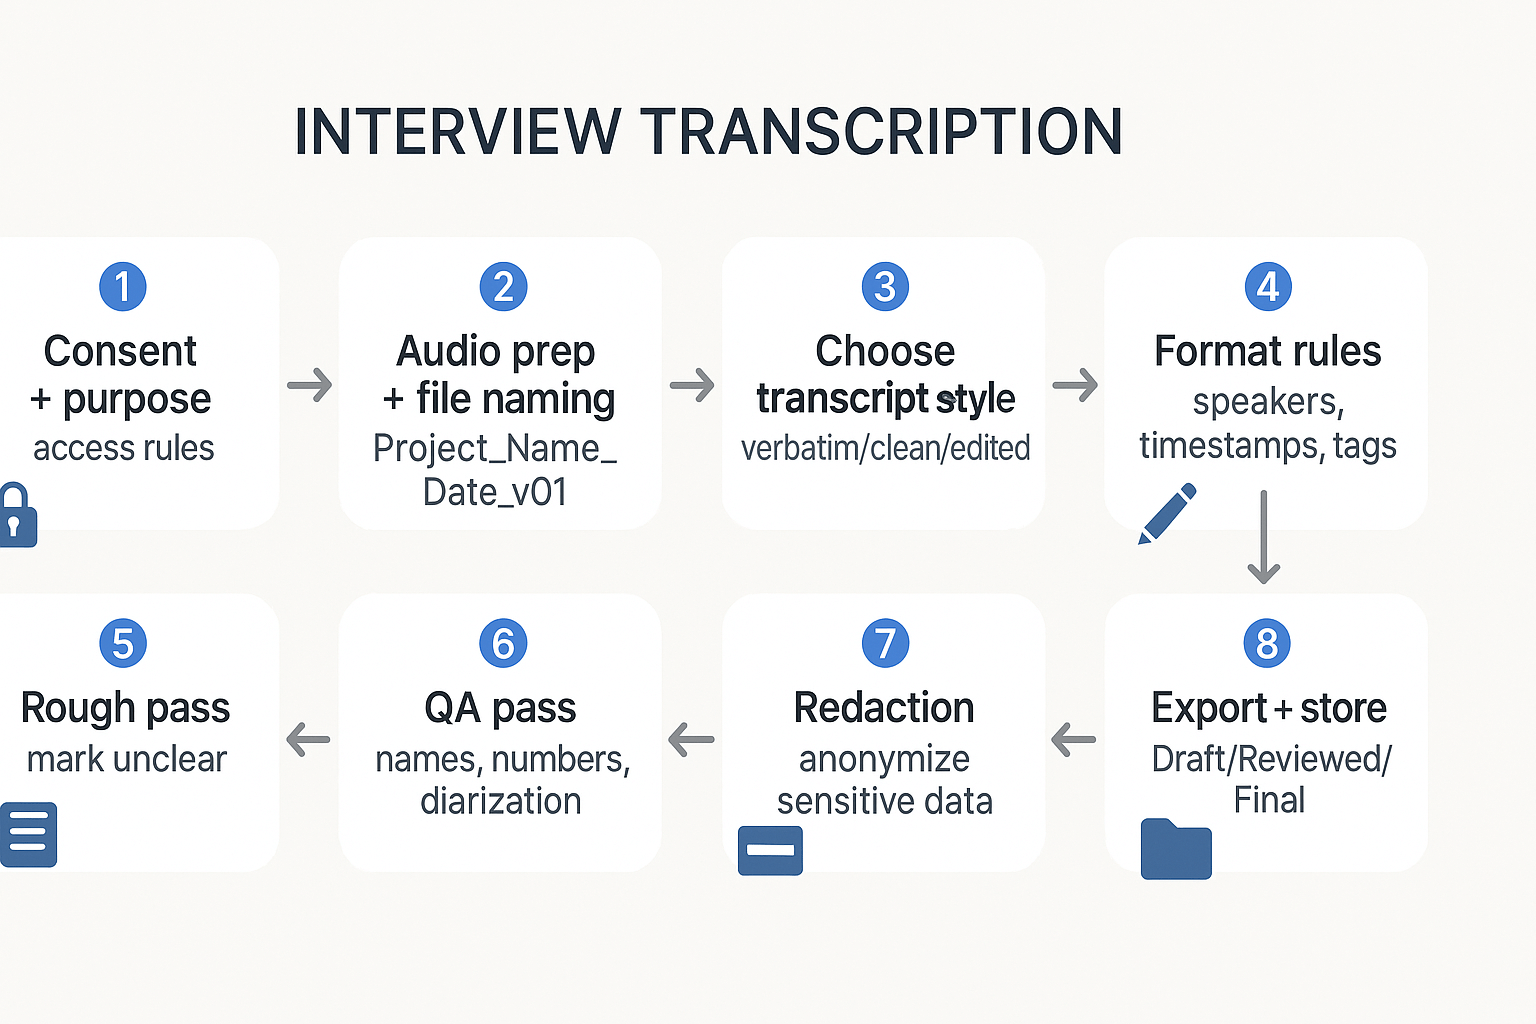
เมื่อไฟล์ของคุณพร้อมแล้ว ให้อัปโหลดไปยังเครื่องมือถอดเสียงด้วย AI ที่คุณเลือกและกำหนดจำนวนผู้พูดให้ตรงกับที่คุณจดไว้ในขั้นตอนที่ 1 การให้ตัวเลขเป้าหมายที่ถูกต้องแก่โมเดลเป็นคันโยกที่ใหญ่ที่สุดเพียงอย่างเดียวสำหรับการแยกผู้พูดที่สะอาด จากนั้นเครื่องมือส่วนใหญ่จะคืนค่าถอดเสียงรอบแรกภายในไม่กี่นาที ข้อจำกัด: หากการบันทึกของคุณมีเสียงพูดที่ทับซ้อนกันหรือการแยกไมโครโฟนที่ไม่ดี แม้แต่เครื่องมือที่ตั้งค่าอย่างถูกต้องก็จะเกิดข้อผิดพลาดในการติดป้ายที่ต้องแก้ไขด้วยมือ
ขั้นตอนที่ 3 - เปลี่ยนชื่อป้ายผู้พูดเพื่อให้ทุกบรรทัดอัปเดตอัตโนมัติ
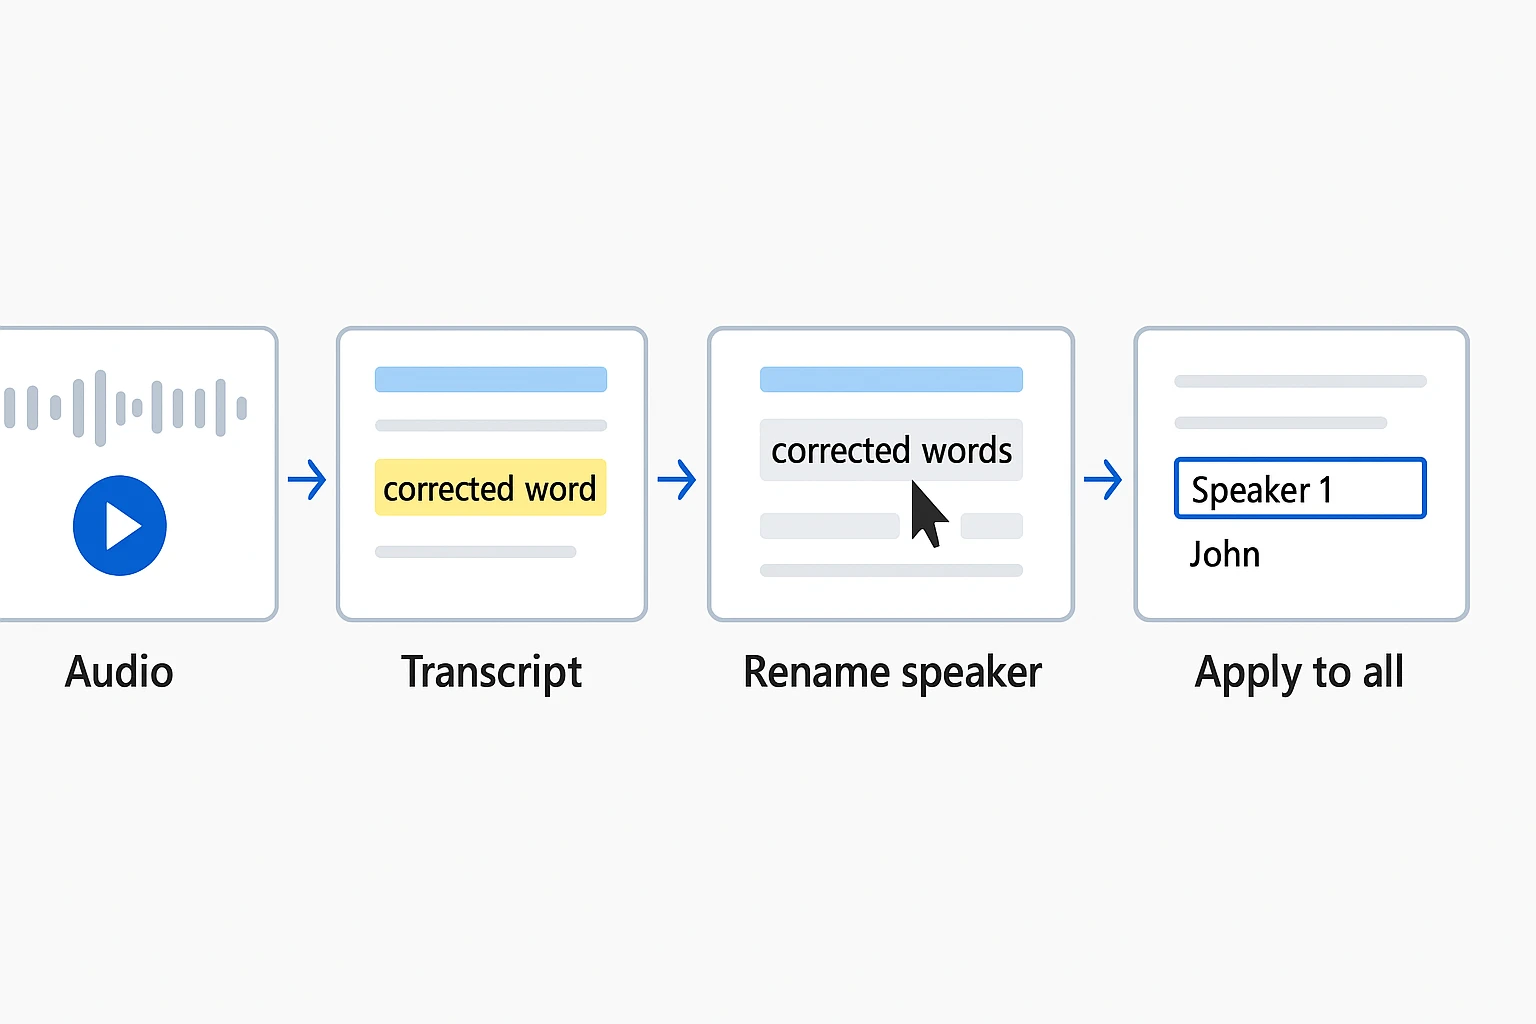
แพลตฟอร์มถอดเสียงด้วย AI ส่วนใหญ่ให้คุณเปลี่ยนชื่อป้ายกำกับผู้พูดได้ครั้งเดียว เช่น เปลี่ยน 'Speaker 1' เป็น 'Dr. Patel' และเผยแพร่การเปลี่ยนแปลงนั้นไปยังทุกอินสแตนซ์ในเอกสารทันที ทำเช่นนี้ก่อนการแก้ไขระดับบรรทัดใดๆ เพื่อหลีกเลี่ยงงานแก้ไขซ้ำซ้ำซาก จากนั้นสแกนหาโดยเฉพาะคำนามเฉพาะ คำย่อ และคำศัพท์เฉพาะทางที่โมเดลอาจได้ยินผิด ข้อแลกเปลี่ยน: การเปลี่ยนชื่อแบบกลุ่มนั้นทรงพลังแต่สามารถปิดบังบล็อกผู้พูดที่ระบุผิดได้หากยังไม่ได้ตรวจพบข้อผิดพลาดในการแยกแยะผู้พูดก่อน
ขั้นตอนที่ 4 - ตรวจสอบคำนามเฉพาะ คำย่อ และคำศัพท์ทางเทคนิคที่ AI พลาด
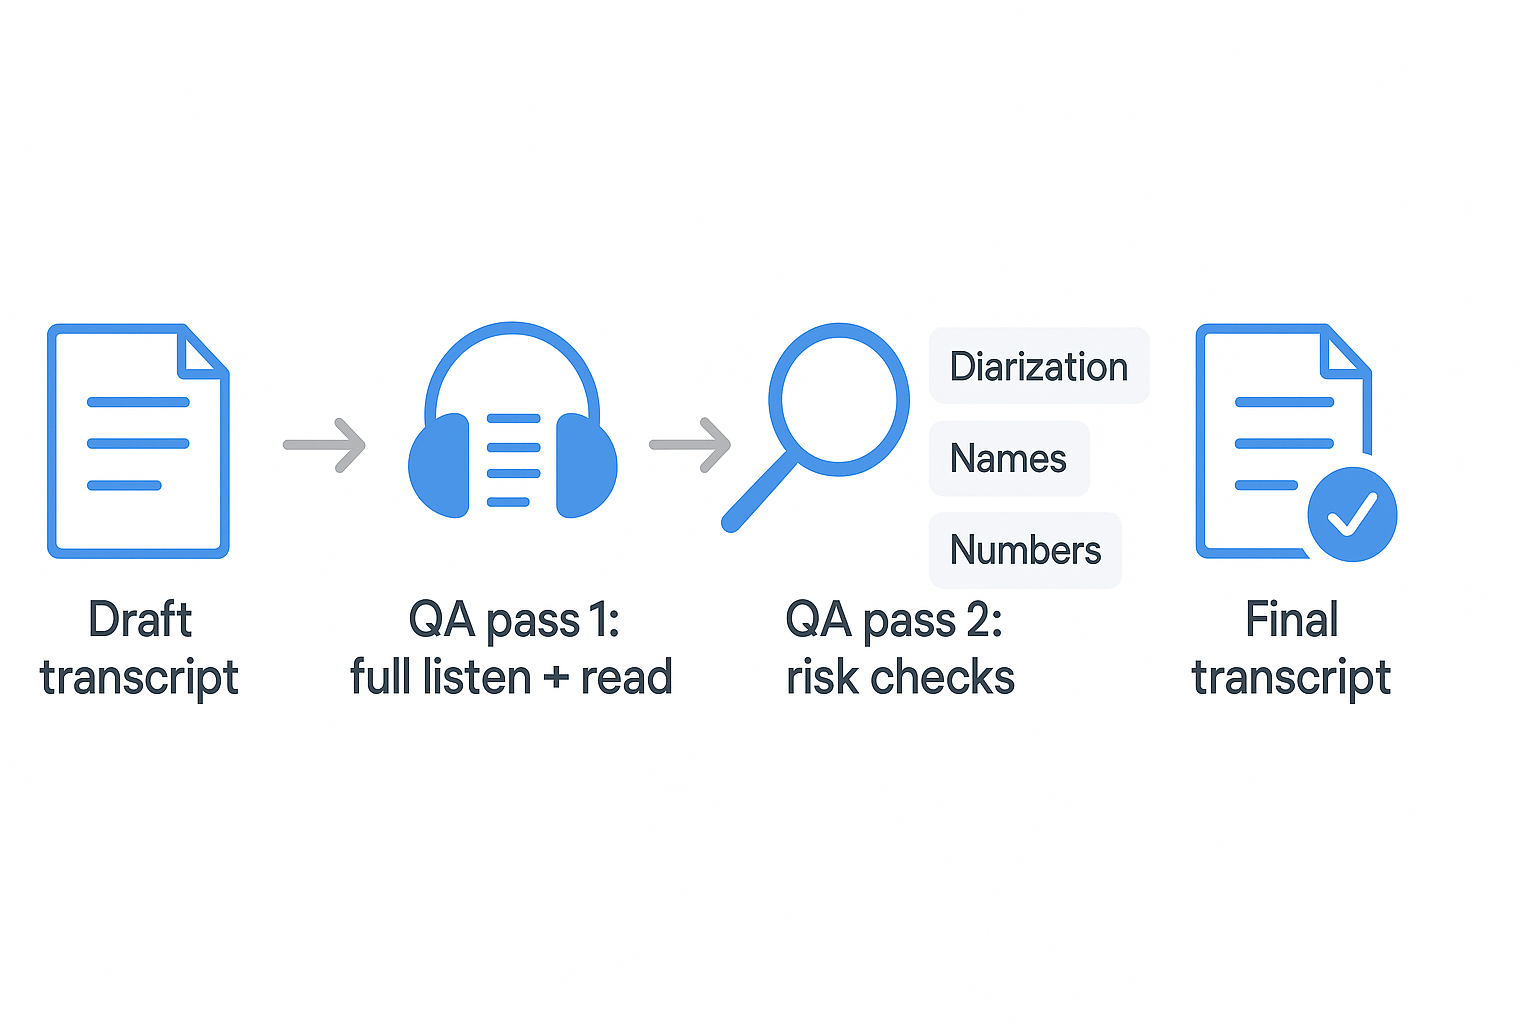
โมเดล AI เก่งเรื่องคำศัพท์ทั่วไปแต่สะดุดเป็นประจำกับศัพท์เฉพาะอุตสาหกรรม ชื่อแบรนด์ และคำย่อ หลังจากเปลี่ยนชื่อผู้พูดแล้ว ให้ทำรอบการตรวจสอบแบบเจาะจง ไม่ใช่การอ่านทั้งหมด เพื่อค้นหาคำที่ออกเสียงใกล้เคียงกับคำศัพท์ที่รู้จักในสาขาของคุณ เครื่องมือหลายตัวให้คุณเพิ่มคำศัพท์หรืออภิธานศัพท์แบบกำหนดเองก่อนประมวลผล หากเครื่องมือของคุณทำได้ ให้ใช้มัน ข้อจำกัด: อภิธานศัพท์แบบกำหนดเองช่วยได้แต่ไม่ได้กำจัดข้อผิดพลาดเมื่อคำศัพท์ฟังเหมือนคำทั่วไปในบริบท
ขั้นตอนที่ 5 - เลือก Clean Verbatim หรือ Full Verbatim ก่อนสรุปผล
Clean verbatim ลบคำฟุ่มเฟือย คำที่เริ่มผิด และการพูดซ้ำ เพื่อสร้างเอกสารที่อ่านง่าย; full verbatim บันทึกทุก 'อืม' การพูดติดอ่าง และการขัดจังหวะ สำหรับการใช้งานด้านกฎหมาย ภาษาศาสตร์ หรือการวิจัยเชิงคุณภาพ ยืนยันว่าสไตล์ใดที่การใช้งานปลายทางของคุณต้องการก่อนที่คุณจะสรุปการแก้ไข เพราะการปรับเปลี่ยนสไตล์ผิดในภายหลังจะเสียเวลาอย่างมาก เครื่องมือ AI ส่วนใหญ่มีค่าเริ่มต้นเป็น clean verbatim ข้อแลกเปลี่ยน: full verbatim นั้นตรงกับต้นฉบับมากกว่าแต่ยากต่อการอ่านและอ้างอิงอย่างมาก
ขั้นตอนที่ 6 - ส่งออกในรูปแบบที่เวิร์กโฟลว์ของคุณต้องการจริงๆ
หลังการแก้ไข ให้ส่งออกบทถอดเสียงในรูปแบบที่เวิร์กโฟลว์ปลายทางของคุณต้องการ DOCX สำหรับทีมบรรณาธิการ SRT สำหรับคำบรรยายวิดีโอ หรือ TXT ธรรมดาสำหรับไปป์ไลน์ข้อมูล การเลือกรูปแบบผิดในขั้นตอนนี้บังคับให้ต้องจัดรูปแบบใหม่ซึ่งลบการจัดตำแหน่งเวลาทิ้ง ตรวจสอบว่าเครื่องมือของคุณฝังการประทับเวลาและป้ายกำกับผู้พูดในการส่งออก ไม่ใช่แค่ในมุมมองตัวแก้ไข ข้อจำกัด: บางแพลตฟอร์มล็กรูปแบบการส่งออกบางรูปแบบไว้ในระดับที่ต้องชำระเงิน ดังนั้นตรวจสอบสิ่งนี้ก่อนตัดสินใจใช้เครื่องมือ
ขั้นตอนที่ 7 - ตรวจสอบความแม่นยำขั้นสุดท้ายเทียบกับเสียงต้นฉบับ
ขั้นตอนสุดท้ายคือการสุ่มตรวจ ไม่ใช่การฟังซ้ำทั้งหมด: กระโดดไปยังการประทับเวลาแบบสุ่มห้าหรือหกจุด เล่น 20-30 วินาทีในแต่ละจุด และยืนยันว่าข้อความตรงกัน สิ่งนี้จับข้อผิดพลาดเชิงระบบ เช่น วลีที่เกิดซ้ำซึ่งได้ยินผิด การกำหนดผู้พูดที่ผิดอย่างสม่ำเสมอ ซึ่งการแก้ไขทีละบรรทัดพลาดไป นอกจากนี้ยังให้มาตรฐานคุณภาพที่ป้องกันได้หากบทถอดเสียงจะถูกเผยแพร่หรือส่งอย่างเป็นทางการ ข้อแลกเปลี่ยน: การข้ามขั้นตอนนี้น่าดึงดูดเมื่อผลลัพธ์ AI ดูเรียบร้อย แต่ความลื่นไหลผิวเผินมักซ่อนข้อผิดพลาดการแทนที่ซ้ำๆ ไว้
การอ่านที่เกี่ยวข้อง
- วิธีถอดเสียงวิดีโอ YouTube
- ซอฟต์แวร์ถอดเสียงที่ดีที่สุดสำหรับการวิจัยเชิงคุณภาพ
- เครื่องมือ AI ถอดเสียงและสรุปการประชุม
- แอปถอดเสียงบรรยายที่ดีที่สุด
- แอปถอดเสียงที่ดีที่สุดสำหรับ iPhone
- ซอฟต์แวร์คำบรรยายปิดที่ดีที่สุด
- การถอดเสียงการวิจัยเชิงคุณภาพ
- การถอดเสียงทางธุรกิจ
- ซอฟต์แวร์ถอดเสียงวิดีโออัตโนมัติ
- การถอดเสียงการวิจัยตลาด
- ซอฟต์แวร์ถอดเสียงพอดแคสต์
- ซอฟต์แวร์ถอดเสียงทางการแพทย์ที่ดีที่สุด
- การถอดเสียงด้วย AI ของ Zoom
- ซอฟต์แวร์ถอดเสียงที่ดีที่สุดสำหรับบทสัมภาษณ์
องค์ประกอบการจัดรูปแบบมาตรฐานใดที่ทำให้บทถอดเสียงบทสัมภาษณ์ดูเป็นมืออาชีพ
บทถอดเสียงบทสัมภาษณ์ระดับมืออาชีพมีองค์ประกอบเชิงโครงสร้างห้าประการ ทำให้ทั้งห้าข้อถูกต้องแล้วเอกสารจะกลายเป็นเครื่องมือที่เร่งงานทุกอย่างที่ตามมา พลาดแม้เพียงข้อเดียวแล้วคุณจะต้องจ่ายแพงในภายหลัง โดยปกติระหว่างการวิเคราะห์ เมื่อการแก้ไขโครงสร้างเสียเวลามากกว่าการสร้างให้ถูกต้องตั้งแต่แรก
1. บล็อกข้อมูลเมตาส่วนหัว - วันที่สัมภาษณ์ ผู้เข้าร่วม ชื่อโครงการ และชื่อไฟล์

ส่วนหัวคือบัตรประจำตัวของบทถอดความ ส่วนหัวที่สมบูรณ์ประกอบด้วยวันที่สัมภาษณ์ ชื่อและบทบาทของผู้เข้าร่วมแต่ละคน ชื่อโครงการ และชื่อไฟล์ต้นฉบับ สิ่งนี้สำคัญเกินกว่าการวิจัยทางวิชาการ: ในบริบททางกฎหมาย ศาลได้ตัดออกหรือโต้แย้งบทถอดความคำให้การซึ่งไม่มีข้อมูลเมตาของเอกสารพื้นฐานหรือไม่สอดคล้องกัน เพราะความสามารถในการตรวจสอบย้อนกลับส่งผลต่อความน่าเชื่อถือ กำหนดมันครั้งเดียวที่ด้านบน แล้วผู้อ่านทุกคนที่เปิดไฟล์จะรู้แน่ชัดว่ากำลังถืออะไรอยู่
2. ป้ายชื่อผู้พูดตัวหนาพร้อมเครื่องหมายทวิภาค - ใช้อย่างสม่ำเสมอตั้งแต่หน้าแรกจนถึงหน้าสุดท้าย
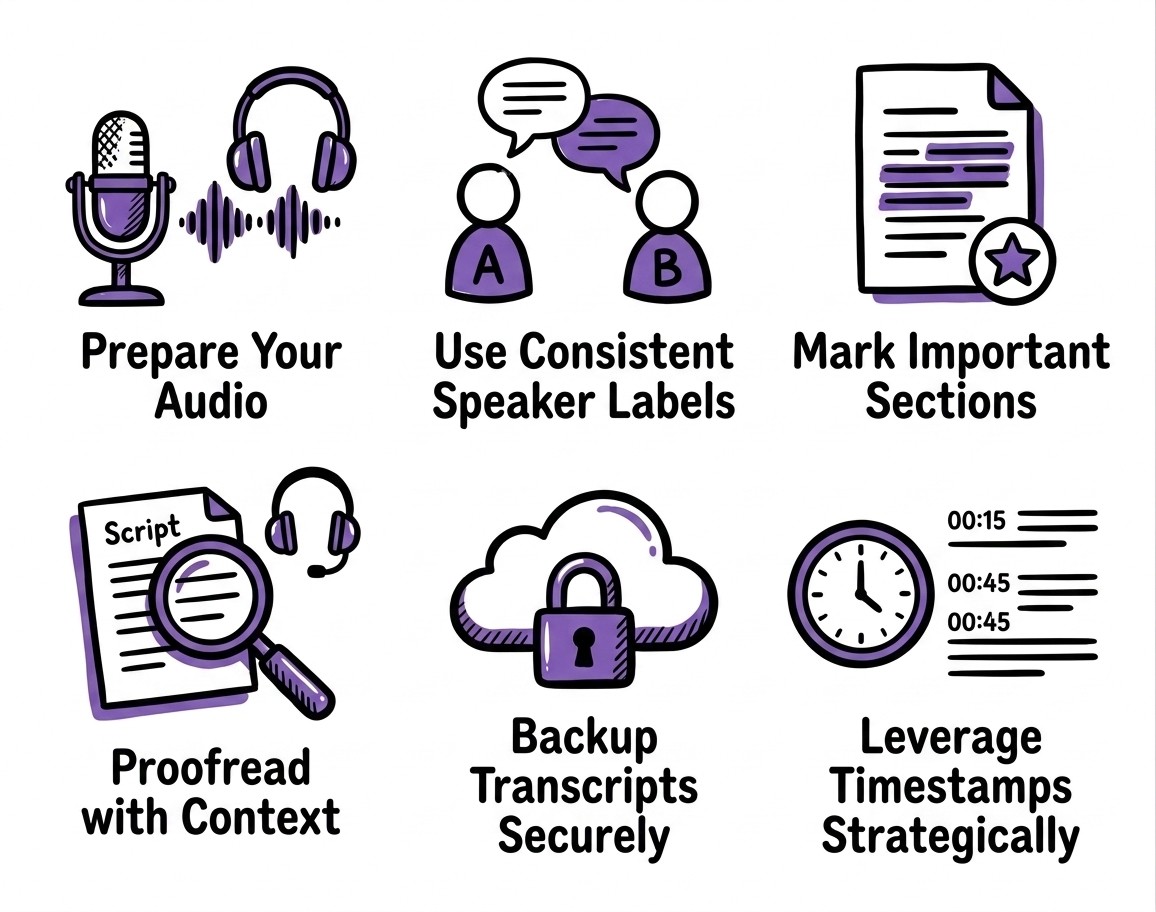
ป้ายชื่อผู้พูดเป็นองค์ประกอบการจัดรูปแบบเดียวที่บทถอดความส่วนใหญ่ทำผิด ป้ายอย่าง "INTERVIEWER:" หรือ "P1:" ต้องปรากฏที่จุดเริ่มต้นของทุกเทิร์น ตัวหนา ในรูปแบบเดียวกันตั้งแต่หน้าแรกจนถึงบรรทัดสุดท้าย การติดป้ายที่ไม่สม่ำเสมอ ซึ่ง "Int." กลายเป็น "I" กลายเป็น "Interviewer" ทั่วเอกสารเดียวกัน บังคับให้ผู้อ่านต้องถอดรหัสบทถอดความแทนที่จะอ่านมัน ความฝืดนี้ทวีคูณอย่างรุนแรงเมื่อเอกสารถูกส่งไปยังเพื่อนร่วมงานหรือผู้ตรวจสอบทางกฎหมายที่ไม่ได้อยู่ในห้อง
3. การประทับเวลาเป็นประจำทุกเทิร์นของผู้พูดเพื่อการนำทางเสียงที่แม่นยำ
การประทับเวลาที่ทุกเทิร์นของผู้พูด ในรูปแบบ [00:14:32] ช่วยให้ผู้อ่านกระโดดไปยังช่วงเวลาหนึ่งในการบันทึกต้นฉบับได้โดยตรงโดยไม่ต้องเลื่อนผ่านเสียง แนวปฏิบัติในอุตสาหกรรมของนักวิจัยเชิงคุณภาพถือว่าสิ่งนี้เป็นมาตรฐานมากกว่าทางเลือก และเหตุผลก็เป็นเชิงปฏิบัติ: การประทับเวลาเปลี่ยนบทถอดความจากเอกสารแบบพึ่งตนเองเป็นดัชนีที่นำทางได้ของการบันทึก หากไม่มีมัน การตรวจสอบคำพูดหมายถึงการเล่นไฟล์ทั้งหมดซ้ำ
4. โครงสร้างพร้อมสำหรับการเข้ารหัสโดยใช้เทิร์นของผู้พูดเป็นขอบเขตหน่วยธรรมชาติสำหรับการวิจัยเชิงคุณภาพ
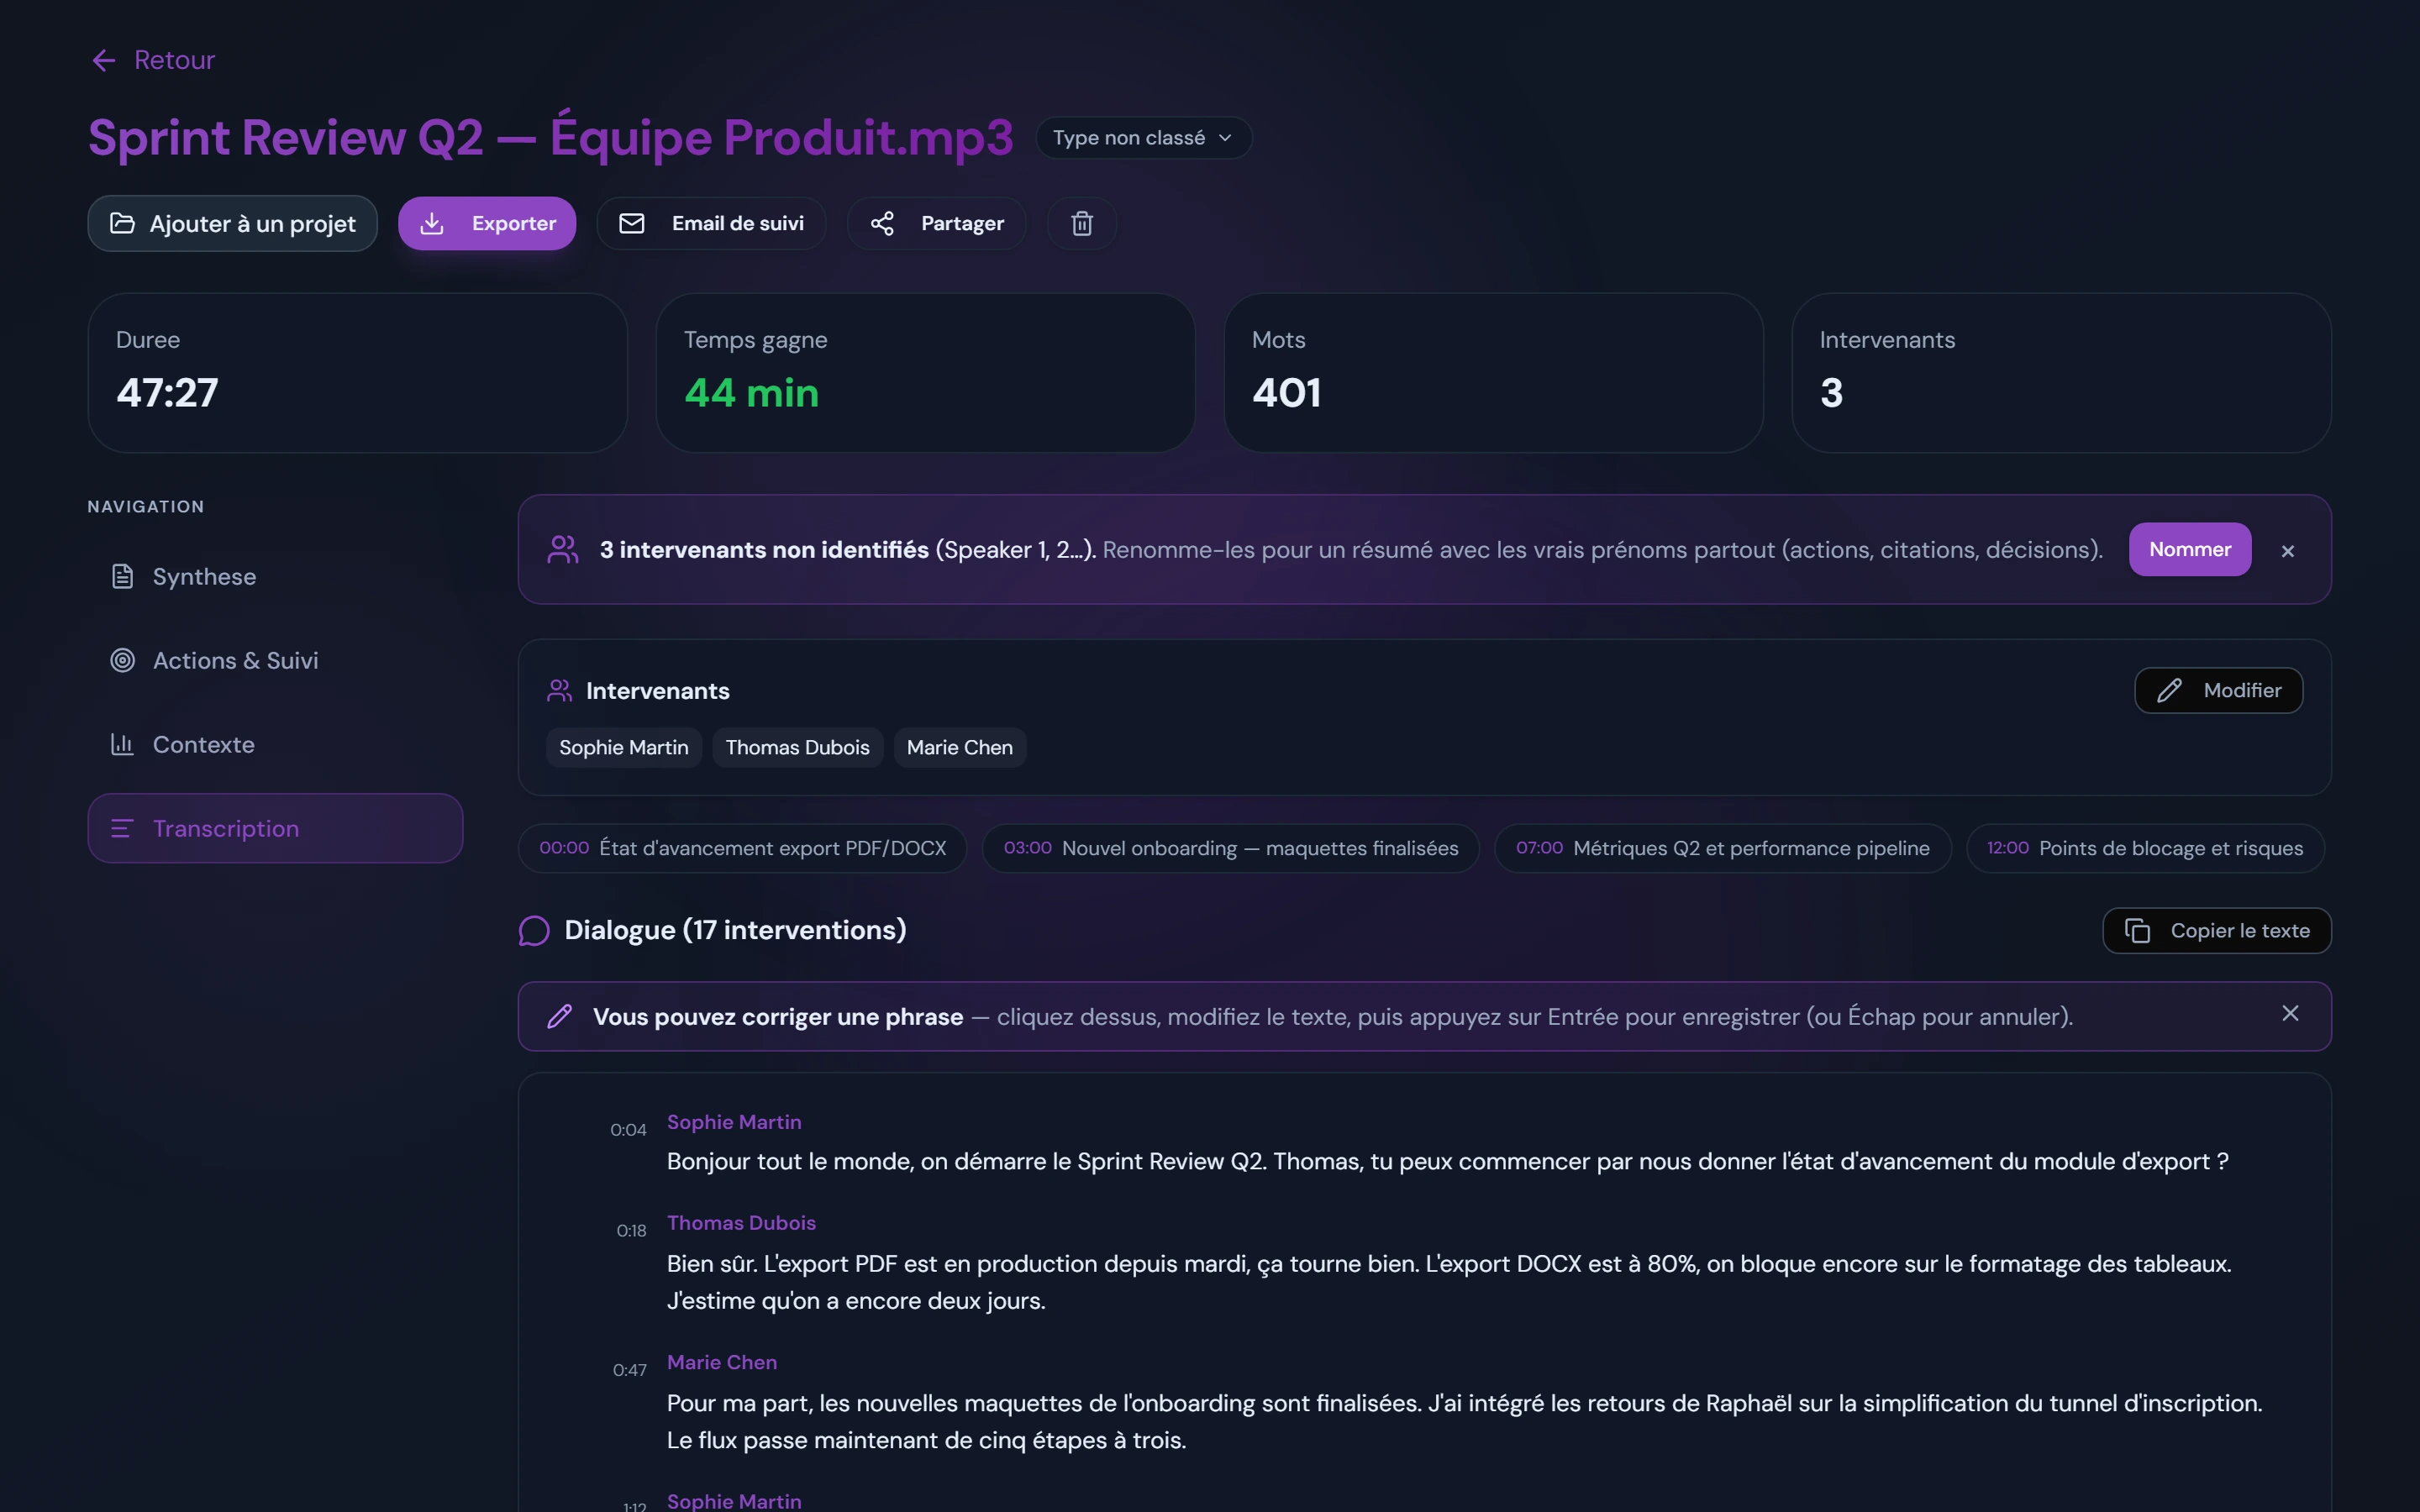
นักวิจัยเชิงคุณภาพที่ใช้เครื่องมืออย่าง NVivo หรือ ATLAS.ti นำเข้าบทถอดความและเข้ารหัสตามส่วน ทั้งสองแพลตฟอร์มถือว่าเทิร์นของผู้พูดเป็นขอบเขตหน่วยธรรมชาติ ดังนั้นบทถอดความที่แต่ละเทิร์นเป็นบล็อกที่แยกจากกันและติดป้ายจะนำเข้าได้อย่างสะอาดและเข้ารหัสได้โดยไม่ต้องปรับโครงสร้างด้วยมือ กำแพงข้อความต่อเนื่อง หรือบทถอดความที่ผู้พูดสองคนใช้ร่วมย่อหน้าเดียว จะทำลายขั้นตอนการทำงานนั้นทันที แอปถอดความด้วยเสียงที่ส่งออกการประทับเวลาระดับคำและป้ายชื่อผู้พูดทุกเทิร์นจะให้ไฟล์ที่ส่งออกไปยังสภาพแวดล้อมการเข้ารหัสได้โดยตรง โดยไม่มีขั้นตอนการจัดรูปแบบใหม่ระหว่างนั้น
5. การประกาศรูปแบบคำต่อคำเต็มรูปแบบเทียบกับคำต่อคำแบบสะอาด - กำหนดครั้งเดียวในส่วนหัวและปฏิบัติตามตลอด
การประกาศรูปแบบบอกผู้อ่านทุกคนว่าจะตีความข้อความอย่างไร คำต่อคำเต็มรูปแบบบันทึกทุกคำเติม ทุกการพูดซ้ำ และทุกการเริ่มต้นผิด คำต่อคำแบบสะอาดลบสิ่งเหล่านั้นออกในขณะที่เก็บเนื้อหาที่มีความหมายทั้งหมดไว้ ไม่มีอันใดผิด การเลือกรูปแบบผิดสำหรับวัตถุประสงค์ต่างหากที่ผิด ประกาศรูปแบบในส่วนหัว ("Transcription style: clean verbatim") และใช้มันโดยไม่มีข้อยกเว้นตลอดเอกสาร บทถอดความที่สลับรูปแบบกลางการสัมภาษณ์ คำต่อคำในครึ่งแรกและแก้ไขในครึ่งหลัง สร้างปัญหาความน่าเชื่อถือที่แทบจะเป็นไปไม่ได้เลยที่จะตรวจจับได้โดยไม่ต้องฟังเสียงซ้ำ
ห้าองค์ประกอบเหล่านี้ให้โครงกระดูกแบบมืออาชีพแก่บทถอดความของคุณ แต่แม้โครงสร้างที่สะอาดที่สุดก็ไม่สามารถบอกผู้อ่านได้ว่าต้องทำอย่างไรเมื่อผู้พูดพูดค้างไว้ เสียงสองเสียงทับซ้อนกัน หรือชื่อที่ต้องปิดบัง ณ จุดนั้นอนุสัญญาการใช้สัญกรณ์เข้ามามีบทบาท และมันคุ้มค่าที่จะทำให้ถูกต้องก่อนที่คุณจะแบ่งปันแม้แต่บรรทัดเดียวกับใครก็ตาม
ควรใช้อนุสัญญาการใช้สัญกรณ์อะไรสำหรับเสียงที่ฟังไม่ได้ การขัดจังหวะ สัญญาณที่ไม่ใช่คำพูด และข้อมูลที่เป็นความลับ
อนุสัญญาการใช้สัญกรณ์สี่ประการคือทั้งหมดที่บทถอดความแบบมืออาชีพต้องการเพื่อให้พึ่งตนเองได้ ข้ามแม้แต่ข้อเดียว แล้วนักวิเคราะห์ ทนายความ หรือบรรณาธิการทุกคนที่อ่านไฟล์จะหยุดและเอื้อมไปหยิบการบันทึกต้นฉบับในที่สุด ซึ่งลบล้างเวลาที่บทถอดความควรจะประหยัดได้
1. [inaudible] - ตัวแทนแบบอินไลน์สำหรับเสียงที่ไม่สามารถถอดความได้
วาง [inaudible] ไว้ที่ตำแหน่งคำที่เสียงขาดหายไปจริง ๆ ไม่ใช่ไว้ท้ายประโยค ความแม่นยำของตำแหน่งเป็นสิ่งสำคัญ ผู้อ่านที่กำลังมองหาข้อความเฉพาะเจาะจงต้องรู้ว่ามีคำหายไปสามคำหรือสามสิบคำ แนวปฏิบัติในอุตสาหกรรมถือว่าการมีเครื่องหมาย [inaudible] มากกว่าสี่หรือห้าครั้งต่อเสียงหนึ่งชั่วโมงเป็นสัญญาณว่าคุณภาพการบันทึกคือปัญหา ไม่ใช่การถอดความ เมื่อตรวจทานบทถอดเสียงของคุณ ให้มองหาเครื่องมือที่ตัวแก้ไขเน้นหรือแยกแยะส่วนที่มีความเชื่อมั่นต่ำให้เห็นชัดเจนทันทีหลังการประมวลผล ซึ่งช่วยให้คุณวาง [inaudible] ไว้ที่ตำแหน่งคำที่แม่นยำแทนที่จะต้องไล่ฟังเสียงเพื่อหาช่วงที่ขาดหาย
2. เครื่องหมายยัติภังค์ยาว (Em-Dash) - สัญลักษณ์สำหรับคำพูดที่ถูกขัดจังหวะหรือถูกตัดขาด

เครื่องหมายยัติภังค์ยาวที่วางไว้ทันทีหลังพยางค์สุดท้ายที่ได้ยิน โดยไม่มีช่องว่างนำหน้า เป็นสัญญาณว่าผู้พูดถูกขัดจังหวะหรือขัดจังหวะตนเองกลางประโยค นี่คือธรรมเนียมมาตรฐานเมื่อเรียนรู้วิธีถอดความบทสัมภาษณ์เพื่อวัตถุประสงค์ทางวิชาการหรือทางวารสารศาสตร์ ช่วยรักษาไดนามิกตามธรรมชาติของการสนทนาสำหรับนักวิเคราะห์วาทกรรม ข้อแลกเปลี่ยนคืออาจสับสนกับเครื่องหมายยัติภังค์ยาวที่ใช้สำหรับข้อความแทรกในวงเล็บ ดังนั้นความสม่ำเสมอตลอดทั้งบทถอดเสียงจึงเป็นสิ่งจำเป็น
3. [laughs], [pause], [crosstalk] - ป้ายในวงเล็บสำหรับสัญญาณอวัจนภาษาที่เกี่ยวข้องกับความหมาย
กฎตรงนี้คือเฉพาะที่เกี่ยวข้องกับความหมายเท่านั้น เสียงถอนหายใจที่เปลี่ยนโทนอารมณ์ของคำตอบควรอยู่ในบทถอดเสียง ส่วนเสียงเก้าอี้ครูดไม่ควร ใช้วงเล็บเหลี่ยมและคำอธิบายตรง ๆ: [laughs], [long pause], [crosstalk] crosstalk สำคัญเป็นพิเศษในการบันทึกที่มีผู้พูดหลายคนซึ่งมีสองเสียงทับซ้อนกัน เพราะมันบอกนักวิเคราะห์ว่าทำไมการผลัดกันพูดครั้งถัดไปอาจไม่สมบูรณ์ แทนที่จะปล่อยให้มีช่องว่างที่อธิบายไม่ได้
4. [hidden] หรือ [redacted] - เครื่องหมายในวงเล็บสำหรับข้อมูลที่เป็นความลับหรืออ่อนไหว
[hidden] และ [redacted] ใช้เพื่อวัตถุประสงค์ที่แตกต่างกัน ใช้ [hidden] สำหรับข้อมูลที่ผู้เข้าร่วมขอให้ไม่บันทึกเป็นทางการระหว่างการสัมภาษณ์ ใช้ [redacted] สำหรับข้อมูลที่ถูกลบออกภายหลังเพื่อให้เป็นไปตามข้อผูกพันด้านการคุ้มครองข้อมูล เช่น ชื่อ รายละเอียดการติดต่อ หรือข้อมูลสุขภาพที่อยู่ภายใต้ข้อกำหนด GDPR หรือ HIPAA การกำหนดมาตรฐานเครื่องหมายตั้งแต่บทถอดเสียงแรก แทนที่จะคิดคำย่อขึ้นมาเองกลางโครงการ ทำให้ผู้อ่านปลายทางทุกคนเข้าใจอย่างชัดเจนว่าอะไรถูกลบออกและเพราะเหตุใด
เมื่อกำหนดธรรมเนียมทั้งสี่นี้ไว้แล้ว บทถอดเสียงของคุณก็สมบูรณ์ในเชิงโครงสร้าง ทุกช่องว่าง การขัดจังหวะ สัญญาณอวัจนภาษา และการเปิดเผยข้อมูลที่อ่อนไหวได้รับการจัดการโดยไม่ต้องกลับไปฟังไฟล์เสียงแม้แต่ครั้งเดียว สิ่งที่เหลือคือการตรวจสอบคุณภาพอย่างรวดเร็วซึ่งแยกผลลัพธ์ AI ฉบับร่างแรกออกจากเอกสารที่คุณจะส่งให้ลูกค้าหรือส่งตีพิมพ์ในวารสาร และกระบวนการตรวจทานนั้นเร็วกว่าที่คนส่วนใหญ่คาดไว้
กระบวนการตรวจทานและแก้ไขที่รักษาความแม่นยำของบทถอดเสียงไม่ให้ตกหล่น
มันคือด่านคุณภาพ เครื่องมือถอดความด้วย AI ให้ความแม่นยำถึง 97.7% ซึ่งหมายความว่าการบันทึกหนึ่งชั่วโมงมีข้อผิดพลาดระดับคำประมาณ 60-120 คำทั่วทั้งไฟล์ ไม่ใช่หลายร้อยคำ ด้วย Cockatoo บทถอดเสียงนั้นกลับมาในการอัปโหลดครั้งแรก ไม่ต้องตั้งค่า ไม่ต้องใช้บัตรเครดิตในระดับฟรี ดังนั้นการตรวจทานจึงเริ่มได้ทันทีที่ไฟล์มาถึง
ฟังเสียงให้จบหนึ่งรอบที่ความเร็ว 1.5x แล้วหยุด
เปิดการตรวจทานบทถอดเสียงที่ความเร็ว 1.5x พร้อมกับอ่านตามในข้อความ
จุดที่ AI ถอดความยังพลาดในคำศัพท์เทคนิค คำย่อ และคำนามเฉพาะ
คำนามเฉพาะ คำย่อ และคำศัพท์เทคนิคคือจุดที่ AI ถอดความรวมข้อผิดพลาดที่เหลืออยู่ และนี่คือภาระการแก้ไขที่ผู้เริ่มต้นรู้สึกได้ชัดเจนที่สุด
บทถอดเสียงที่ผ่านการตรวจทานอย่างเรียบร้อยปลดล็อกอะไรได้จริงในขั้นถัดไป
เนื่องจาก Cockatoo ส่งออกไปยัง PDF และ DOCX ทรานสคริปต์ที่เสร็จแล้วจึงเข้าไปในไฟล์ Word หรือ PDF ที่คนอื่นสามารถเปิด แทรกคำอธิบาย และแก้ไขได้ทันที โดยไม่ต้องคัดลอกวางจากอินเทอร์เฟซเว็บและไม่มีขั้นตอนจัดรูปแบบใหม่ งานวิจัยในอุตสาหกรรมระบุไว้อย่างชัดเจนว่า ทรานสคริปต์ที่สร้างโดย AI และผ่านการตรวจทานแล้วช่วยให้วิเคราะห์ได้เร็วขึ้น อ้างอิงได้แม่นยำ และจัดทำเอกสารที่แชร์ได้ ซึ่งย่อกระบวนการที่เคยใช้เวลาหลายชั่วโมงด้วยมือให้เหลือเพียงการแก้ไขรอบเดียวอย่างเบาแรง
เหตุใดการเลือกแบบสมัครสมาชิกจึงเป็นการตัดสินใจเรื่องการถอดเสียงที่คู่มือส่วนใหญ่ละเลย
โครงสร้างการสมัครสมาชิกเป็นตัวกำหนดว่าแอปถอดเสียงจะยังคุ้มค่าเมื่อใช้งานปริมาณมากหรือไม่ แต่ผู้ซื้อส่วนใหญ่กลับใช้เวลาในการศึกษาข้อมูลไปกับการเปรียบเทียบความแม่นยำและรูปแบบการส่งออก โดยไม่สนใจรูปแบบการคิดค่าบริการเลย การมองข้ามจุดนี้จะกลายเป็นค่าใช้จ่ายสูงเมื่อปริมาณการใช้งานเพิ่มขึ้น
เกณฑ์มาตรฐาน $120 ต่อชั่วโมง เทียบกับเครื่องมือถอดเสียงด้วย AI
บริการถอดเสียงโดยมนุษย์มีค่าใช้จ่ายประมาณ $120 ต่อชั่วโมงเสียงในอัตราวิชาชีพมาตรฐาน ซึ่งทำให้เครื่องมือ AI แบบบริการตนเองทุกตัวดูเหมือนเป็นตัวเลือกที่ชนะอย่างชัดเจนในแวบแรก แต่เกณฑ์มาตรฐานนี้ปิดบังการคำนวณที่สำคัญกว่ามาก นั่นคือ เมื่อคุณถอดเสียงด้วยตัวเอง การบันทึกเสียงหนึ่งชั่วโมงจะใช้เวลาทำงานของคุณสี่ถึงหกชั่วโมง แม้ในอัตรารายชั่วโมงของพนักงานระดับความรู้ปานกลาง ต้นทุนแรงงานที่มองไม่เห็นนี้ก็ยังสูงกว่าราคาสมัครสมาชิก AI ส่วนใหญ่
รูปแบบการคิดค่าบริการเองก็เพิ่มชั้นของต้นทุนที่ซ่อนอยู่ชั้นที่สองซึ่งควรพิจารณาก่อนผูกมัดกับแพลตฟอร์มใด ๆ แผนบางแบบที่โฆษณาว่าถอดเสียงได้ไม่จำกัดกลับมีเพดานการใช้งานที่บังคับใช้อย่างเงียบ ๆ ในตั้งค่าบัญชี นักวิจัยที่ประมวลผลไฟล์บันทึกเป็นชุดจะค้นพบเพดานนี้ก็ต่อเมื่อกระบวนการทำงานสะดุดกลางโปรเจกต์ นั่นคือกับดักต้นทุนการถอดเสียงด้วย AI ที่แท้จริง เพดานที่ไม่คาดคิดซึ่งเปลี่ยนเครื่องมือแบบเหมาจ่ายให้กลายเป็นมิเตอร์รายชั่วโมงในจังหวะที่แย่ที่สุด
เหตุใดผู้ประกอบการรายเดี่ยวจึงถูกตัดออกจากตัวเลือกด้วยระดับองค์กรก่อนที่จะตัดสินใจซื้อด้วยซ้ำ
สำหรับผู้ประสานงานปฏิบัติการรายเดี่ยวหรือนักวิจัยอิสระ แผนที่ใช้งานได้จริงที่สุดคือแผนที่ใช้ได้กับคนคนเดียวโดยไม่มีสายอนุมัติและไม่มีจำนวนที่นั่งขั้นต่ำที่ต้องทำตาม แผน Pro ของ Cockatoo เป็นการซื้อแบบบริการตนเองสำหรับหนึ่งที่นั่ง สมัคร อัปโหลด และรับทรานสคริปต์ ไฟล์บันทึกมีอยู่จริง กำหนดส่งเป็นเรื่องจริง และสิ่งเดียวที่ขวางอยู่ระหว่างสองสิ่งนั้นควรเป็นการอัปโหลด
รายเดือนเทียบรายปี: การตัดสินใจเรื่องการเรียกเก็บเงินที่เปลี่ยนเศรษฐศาสตร์ของการถอดเสียงปริมาณมาก
สำหรับผู้ที่ประมวลผลไฟล์บันทึกอย่างต่อเนื่อง รอบการเรียกเก็บเงินเป็นการตัดสินใจเรื่องตัวเลขจริง ทั่วทั้งอุตสาหกรรม SaaS แผนรายปีมักมีส่วนลดที่มีนัยสำคัญเมื่อเทียบกับการจ่ายรายเดือน ดังนั้นนักวิจัยที่ประมวลผลการสัมภาษณ์ในปริมาณสม่ำเสมอจึงสามารถคืนทุนจากข้อผูกมัดล่วงหน้าได้ภายในไม่กี่รอบการเรียกเก็บเงิน ข้อแลกเปลี่ยนที่ตรงไปตรงมา: การเรียกเก็บเงินรายปีไม่เหมาะสมหากปริมาณงานของคุณเป็นไปตามฤดูกาลจริง ๆ ซึ่งในกรณีนั้นการผูกมัดรายเดือนจะรักษาความยืดหยุ่นในการลดขนาดลงได้โดยไม่มีค่าปรับ
แผน Pro ของ Cockatoo ไม่มีเพดานชั่วโมงรายเดือน และเป็นการซื้อแบบบริการตนเองสำหรับหนึ่งที่นั่งโดยไม่มีจำนวนที่นั่งขั้นต่ำของระดับทีมมากั้นระหว่างไฟล์บันทึกกับทรานสคริปต์ เมื่อตัดสินใจเรื่องราคาเสร็จแล้ว สิ่งเดียวที่เหลือคือการอัปโหลด
ขั้นตอนถัดไป
หากไฟล์บันทึกการสัมภาษณ์ของคุณยังคงไม่ได้ประมวลผลเพราะการถอดเสียงดูเหมือนงานทั้งวัน เส้นทางข้างหน้าจะเริ่มต้นจากการตระหนักว่าหมวดหมู่นี้ได้ก้าวไปไกลจริง ๆ เครื่องมือ AI ที่สร้างขึ้นมาเพื่อจุดประสงค์นี้ด้วยความแม่นยำ 97-98% จะเหลือการแก้ไขระดับคำเพียงประมาณ 60-120 คำในไฟล์หนึ่งชั่วโมง ไม่ใช่กำแพงข้อผิดพลาดที่ทำให้คำบรรยายอัตโนมัติฟรีกลายเป็นตัวกินเวลา นั่นคือการตรวจแบบเจาะจง ไม่ใช่การพิมพ์ใหม่ เริ่มต้นด้วยแอปถอดเสียงของเรา
การกำหนดจำนวนผู้พูดที่ถูกต้องก่อนอัปโหลดคือการกระทำที่มีผลสูงสุดในกระบวนการทำงานทั้งหมด เพราะข้อผิดพลาดในการแยกแยะผู้พูดจะทบเป็นคำพูดที่ผิดเพี้ยนซึ่งมีต้นทุนในการแก้ไขสูงกว่าการป้องกันมาก และต้นทุนที่แท้จริงของการข้าม AI ไปเลยไม่ใช่ศูนย์ เมื่อการถอดเสียงด้วยมือใช้เวลาสี่ถึงหกชั่วโมงของพนักงานระดับความรู้ต่อชั่วโมงที่บันทึก ทางเลือกระหว่าง AI กับการถอดเสียงด้วยตัวเองจึงเป็นต้นทุนที่รู้อยู่แล้วเทียบกับต้นทุนที่มองไม่เห็น และต้นทุนที่มองไม่เห็นนั้นแทบจะแพ้เสมอ เมื่อรวมกันแล้ว ข้อเท็จจริงสองประการนี้นำไปสู่ข้อสรุปเชิงปฏิบัติข้อเดียว: อัปโหลดไฟล์ ระบุจำนวนผู้พูด และปล่อยให้รอบการตรวจทานเป็นแบบผ่าตัดเจาะจงแทนที่จะ exhaustive
เริ่มต้นกับ Cockatoo บนแพ็กเกจฟรี ไม่ต้องใช้บัตรเครดิต และรันเวิร์กโฟลว์สามขั้นตอนเต็มรูปแบบกับไฟล์จริงได้วันนี้
คำถามที่พบบ่อย
ฉันควรใช้การถอดความแบบคำต่อคำ (verbatim) หรือแบบคลีนเวอร์แบติม (clean verbatim) สำหรับการสัมภาษณ์งานวิจัยของฉัน?
ขึ้นอยู่กับว่าคุณกำลังวิเคราะห์อะไร การถอดความแบบคำต่อคำเต็มรูปแบบ ซึ่งเก็บทุกคำเติม เสียงติดขัด และสัญญาณที่ไม่ใช่คำพูด จำเป็นเฉพาะเมื่อวิธีการพูดเป็นข้อมูลในตัวเอง เช่น ในการวิเคราะห์วาทกรรมหรือกระบวนพิจารณาทางกฎหมาย สำหรับการวิเคราะห์เชิงธีม งานข่าว หรือการวิจัยทางธุรกิจที่ความอ่านง่ายสำคัญกว่าการเก็บทุกรายละเอียดของเสียง การถอดความแบบคลีนเวอร์แบติมคือค่าตั้งต้นที่เหมาะสมสำหรับโครงการส่วนใหญ่
ฉันจะมั่นใจได้อย่างไรว่าสไตล์การถอดความของฉันตรงกับวิธีการวิเคราะห์ของฉันจริงๆ?
เลือกสไตล์ของคุณก่อนอัปโหลดหรือพิมพ์แม้แต่คำเดียว เพราะความไม่สอดคล้องจะบังคับให้ต้องทำใหม่ทั้งหมด ซึ่งอาจใช้เวลามากกว่าการถอดความรอบแรกเสียอีก แต่ละสไตล์ตอบคำถามเชิงวิเคราะห์ที่แตกต่างกัน: แบบคำต่อคำเต็มรูปแบบสำหรับการวิเคราะห์รูปแบบการพูด แบบคลีนเวอร์แบติมสำหรับการเข้ารหัสเชิงธีมและการดึงคำพูด และแบบสรุปสำหรับการบรรยายสรุปภายในเท่านั้นที่ไม่จำเป็นต้องใช้ถ้อยคำที่แน่นอน หากมีโอกาสที่ผู้มีส่วนได้ส่วนเสียจะขอคำพูดโดยตรงในภายหลัง หรือคุณจะต้องตรวจสอบธีมที่เข้ารหัสไว้ อย่าเริ่มต้นด้วยผลลัพธ์แบบสรุป
การถอดความการสัมภาษณ์หนึ่งชั่วโมงใช้เวลาจริงเท่าไรหากฉันทำด้วยตัวเอง?
การถอดความด้วยมือใช้เวลาพิมพ์ประมาณ 4 ถึง 6 ชั่วโมงต่อเสียงที่บันทึกไว้ทุกๆ 1 ชั่วโมง สำหรับคนที่ต้องจัดการสายดิสคัฟเวอรีสามครั้งต่อสัปดาห์ นั่นหมายความว่าการถอดความเพียงอย่างเดียวอาจกินเวลาส่วนใหญ่ของสัปดาห์ทำงานก่อนที่จะเริ่มการวิเคราะห์ การจัดรูปแบบ หรือการส่งมอบใดๆ
ทำไมเครื่องมือคำบรรยายอัตโนมัติฟรีจึงสร้าง transcript ที่ยุ่งเหยิงจนยังต้องแก้ไขหนัก?
เครื่องมือคำบรรยายอัตโนมัติฟรีล้มเหลวกับคำพูดที่มีสำเนียง การพูดทับซ้อน และการบันทึกภาคสนาม ให้ผลลัพธ์ที่ต้องใช้เวลาแก้ไขเกือบเท่ากับการถอดความตั้งแต่ต้น การแก้ไขข้อผิดพลาดของคนอื่นช้ากว่าการเริ่มใหม่ เพราะทุกบรรทัดต้องตัดสินใจว่าข้อความเป็นข้อผิดพลาดหรือแค่ไม่ราบรื่น
ฉันสามารถเก็บ transcript ฉบับเต็มไว้และยังได้บทสรุปสำหรับแชร์กับผู้มีส่วนได้ส่วนเสียได้ไหม?
ได้ บทความแนะนำให้ทำการถอดความแบบคำต่อคำเต็มรูปแบบหรือคลีนเวอร์แบติมก่อนและเก็บไฟล์นั้นไว้ จากนั้นใช้เครื่องมืออย่างตัวแก้ไขโน้ต AI Canvas ของ Cockatoo เพื่อดึงและจัดระเบียบข้อมูลเชิงลึกหลักแยกต่างหาก ด้วยวิธีนี้บทสรุปจะตอบโจทย์การบรรยายสรุปโดยไม่ทำลายบันทึกเชิงวิเคราะห์ที่คุณจะต้องใช้หากมีคนขอคำพูดโดยตรงหรือการตรวจสอบธีมที่เข้ารหัสไว้ในภายหลัง