Transkripsjonsnøyaktighetsrater villeder deg i 2026
Leverandører publiserer nøyaktighetstall uten å oppgi hva de har målt. Her er hva WER faktisk beregner, hvorfor benchmarker på ren lyd smigrer alle verktøy, og hva det tallet koster deg på et ekte opptak.
Den vanlige antakelsen er at hvis et verktøy annonserer en høy nøyaktighetsgrad, bør utdataene være pålitelige nok til å brukes med bare mindre redigeringer; det tallet er et meningsfullt kvalitetssignal. Leverandørers nøyaktighetspåstander er overalt. Ingen av dem forteller deg hva tallet faktisk målte, eller om den målingen har noe med opptaket ditt å gjøre.
Kjerneproblemet er definisjonsmessig. Den samme metrikken, målt under ulike forhold, gir helt forskjellige resultater, og ingen regel krever at leverandører oppgir hvilke forhold de brukte.
Se vår transkripsjonsprogramvare for hvordan dette fungerer i praksis.
Word Error Rate (WER) er den standardmetrikken som ligger bak hvert nøyaktighetstall i transkripsjonsbransjen. I følge Association for Computational Linguistics' 2018 e-WER-artikkel beregnes WER ved å telle substitusjoner, slettinger og innsettinger i forhold til det totale antallet ord i en referansetranskripsjon. Moderne AI-systemer kan oppnå 2 til 5 prosent WER på ren lyd av studiekvalitet, noe som tilsvarer 95 til 98 prosent nøyaktighet. Haken ligger i «ren lyd av studiekvalitet»: én taler, nær mikrofon, lav bakgrunnsstøy, kontrollert miljø. De fleste som transkriberer et ekte intervju, en klientsamtale eller et innspilt møte, jobber ikke under slike forhold.
Den samme ACL-forskningen gjør det klart at WER krever en referansetranskripsjon, og leverandørene velger hvilken lyd som produserer den transkripsjonen. En leverandør kan kjøre modellen sin mot et rent studioopptak med én taler, rapportere 2 prosent WER og publisere «98% nøyaktig» på hjemmesiden sin. Det tallet er ikke usant.
Det måler noe som ikke har noe med det støyende konferanserommet ditt eller intervjuobjektets regionale aksent å gjøre. To leverandører kan begge hevde høy nøyaktighet mens verktøyene deres presterer helt forskjellig på ekte lyd, fordi de benchmarket mot helt forskjellige forhold. Det er ingen plikt til å oppgi lydtype, talerprofil, støynivå eller domene.
Ingen bransjeomfattende standard styrer hvordan transkripsjonsnøyaktighet skal måles eller rapporteres. Fordi WER beregnes mot en valgt referanse under valgte forhold, kan et enkelt tall rapportert uten metodeopplysning ikke meningsfullt tolkes som et kvalitetssignal for bruk i virkeligheten. Det eneste tallet som er verdt å stole på, er et som er benchmarket på ekte lyd, publisert per språk, slik at du kan sjekke det mot din egen opptakstype før du forplikter deg.
Viktige punkter
- «99% nøyaktig» er en markedsføringspåstand, ikke en måling; leverandører oppgir nesten aldri hvilket lydmateriale de har testet på, noe som gjør tallet umulig å verifisere eller stole på.
- Word Error Rate beregnes som standard på ren, studiokvalitets-innspilt tale, noe som betyr at hver leverandørs hovedtall er målt under forhold som ikke ligner et reelt intervju, møte eller feltoptak.
- Aksenter, bakgrunnsstøy, flere talere og domenespesifikt vokabular er ikke unntakstilfeller, de er den vanlige virkeligheten for de fleste transkriberingsoppdrag, og det er nettopp dette leverandørenes referansemålinger utelater.
- Nøyaktighetskrav er ikke én enkelt terskel: en 95% som fungerer fint for et personlig talenotat, ville være katastrofalt utilstrekkelig for juridisk, medisinsk eller samsvarsrelatert transkribering.
- AI-transkribering av ren lyd med én taler nærmer seg nå menneskelig nøyaktighet, men gapet øker kraftig i det lydkvaliteten forringes, og det er da valget mellom AI og menneske faktisk betyr noe.
- Den nøyaktighetsforbedringen som gir mest effekt, skjer før du trykker på opptak: mikrofonplassering og romakustikk gir enhver transkriberingsmotor et bedre signal å jobbe med enn etterbehandling noen gang kan.
- Den eneste referansemålingen som er verdt å stole på, oppgir testsettet, spesifiserer språk og aksent, og lar deg gjenta den på ditt eget lydmateriale; enhver påstand som ikke oppfyller dette kravet, bør ignoreres.
- Cockatoo lar deg kjøre den virkelige testen selv: last opp din egen lyd eller video, få AI-transkribering raskt tilbake, og verifiser nøyaktigheten mot opptakene du faktisk trenger å behandle, ingen salgssamtale, ingen tilrettelagt demofil.
Hvordan Word Error Rate beregnes, og hvorfor referansemålinger på ren lyd smigrer enhver leverandør
Det tallet kommer direkte fra Word Error Rate-formelen, og når du først ser regnestykket, blir gapet mellom leverandørens hovedtall og din faktiske transkripsjon umulig å overse.
WER-formelen forklart - hva substitusjoner, slettinger og innsettinger faktisk koster deg
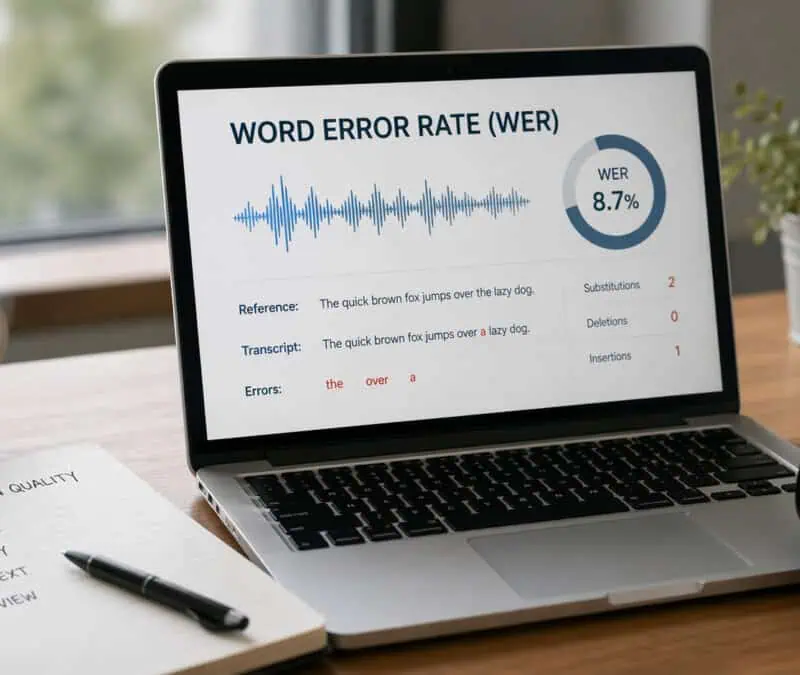
Word Error Rate beregnes som (S + D + I) / N, der S teller erstattede ord, D teller slettede ord, I teller innsatte ord, og N er totalt antall ord i referansetranskripsjonen. Hver feiltype vektes likt i formelen, så et utelatt ord koster nøyaktig like mye som et feil ord.
En 5% WER betyr ikke én ryddig feil hvert 20 ord. Det betyr fem feil et sted innenfor hvert 100 ord, som hoper seg opp rundt aksentpreget tale, overlappende stemmer og domenespesifikke termer, og disse grupperingene havner gjerne nettopp der meningen er mest konsentrert.
Hvorfor moderne AI oppnår 2 til 5 prosent WER på ren lyd, og hvordan det opptaket faktisk høres ut
Moderne talegjenkjenningssystemer oppnår WER helt nede på 2 til 5% på ren lyd i studiekvalitet, referansemålinger som krever opptak med én taler, lav støy og nær mikrofon. Disse tallene kommer fra datasett som LibriSpeech: én taler, profesjonell mikrofon, ingen bakgrunnsstøy, ingen avbrytelser, ingen aksentvariasjon, ingen kodeveksling. Som Allmaz' ordliste om Word Error Rate bemerker, er de fleste generelle motorer ikke trent på virkelige samtalemønstre, noe som betyr at hovedtall hentet fra ren lyd i samme domene ikke forutsier ytelsen på opptakene de fleste brukere faktisk produserer.
95 prosent nøyaktig betyr allerede 25 feil ord per 500-ords transkripsjon, før virkelig lyd gjør det verre
25
Feil ord i en 500-ords transkripsjon ved 95% nøyaktighet
En møtetranskripsjon på 500 ord inneholder omtrent 25 feil ved 95% nøyaktighet, nok til å navngi en klient feil, forvrenge et tall eller miste en viktig oppgave helt. På faktiske opptak med bakgrunnsstøy, aksenter eller flere talere faller nøyaktigheten rutinemessig ned i området 85 til 92%. Ved 85% inneholder den samme transkripsjonen 75 feil: ikke en transkripsjon du redigerer, men en du skriver om.
En korreksjonsskala av den størrelsen krever en arbeidsflyt bygget rundt enkel eksport og overlevering. Cockatoos DOCX- og PDF-eksporter finnes nettopp for dette formålet; den som tok opp møtet, trenger ikke være den som rydder opp i transkripsjonen. Gratis kontoer får ubegrensede transkripsjoner i full lengde i V4-Flash, uten daglig grense, og i alle eksportformater: DOCX, PDF, TXT, SRT, VTT, CSV og JSON.
Faktorene som faktisk ødelegger transkripsjonsnøyaktigheten på ekte opptak
Ekte opptak bryter ned transkripsjonsverktøy på måter leverandørenes referansemålinger aldri avdekker. Forholdene som blåser opp feilraten er ikke sjeldne unntakstilfeller; de er den vanlige virkeligheten for alle som transkriberer et intervju, et samtalekopptak eller en paneltdiskjon. Å forstå hvilke variabler som utløser nøyaktighetssvikt er forskjellen mellom å laste opp en fil med trygghet og å bruke to timer på å rette en transkripsjon som kom tilbake som nærmest vås.
1. Bakgrunnsstøy, romklang og dårlig mikrofonplassering - De fire opptaksvariablene referansemålinger aldri tester
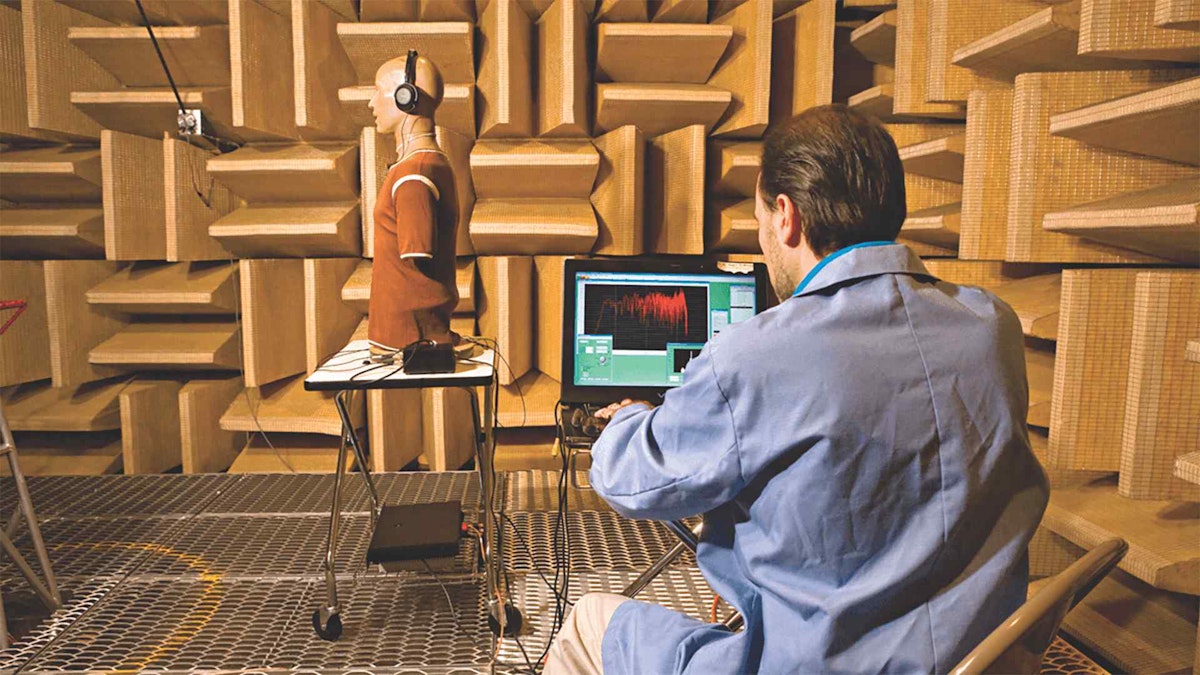
Signal-til-støy-forholdet er den enkeltfaktoren som sterkest forutsier transkripsjonsnøyaktighet, og det faller raskt. Forskning publisert i Speech Communication viser at ordfeilraten kan stige fra under 5% på ren lyd til over 30% når signal-til-støy-forholdet faller under 10 dB, et nivå som beskriver et vanlig kontor med en aircondition som går, eller en telefonsamtale tatt på et kjøkken. Romklang forsterker dette ytterligere: reflektert lyd smører konsonantene sammen, og modellen mottar to kopier av hvert fonem på litt ulike tidspunkter, noe som forårsaker slettingfeil som ingen mengde etterbehandling kan rette helt opp.
Mikrofonplassering er variabelen folk flest undervurderer. En laptopmikrofon som tar opp en taler to meter unna i et ubehandlet rom, er en grunnleggende annen signalklasse enn de nærmikrofon-, ekkofrie inndataene referansemålingene bruker.
Det er her valg av modus betyr noe i praksis. Cockatoo har to transkripsjonsmoduser. V4-Flash transkriberer i opptil 120x reell tid og er gratis og ubegrenset. V4-Pro er den mest nøyaktige modusen, kjører i omtrent 20x reell tid og legger til talermerker. Gratis kontoer får ukentlige V4-Pro-forhåndsvisninger, slik at du kan sammenligne begge modusene på et opptak gjort i ditt eget rom før du bestemmer hva lyden din trenger.
Pro kjører hele opptak i V4-Pro, med høyere bruksgrenser og prioritert behandling. Gjeldende planer finnes på prissiden.
2. Ikke-innfødte aksenter og regionale dialektvariasjoner - Hvorfor substitusjonsfeil skyter i været utenfor korpus med majoritetsaksent

Transkripsjonsnøyaktighet på engelsk talt av ikke-innfødte skiller seg vesentlig fra det tallet som står i overskriften. Bransjeforskning fant at fem ledende ASR-systemer produserte feilrater for svarte amerikanske engelsktalere som var dobbelt så høye som for hvite amerikanske engelsktalere, og aksentrelaterte forskjeller for ikke-innfødte er enda større. Feilmønsteret er substitusjonsfeil: ord som høres plausible ut i konteksten, men er feil, slik at de overlever en overfladisk lesing og stille ødelegger protokollen.
Bransjeforskning fant at fem ledende ASR-systemer produserte feilrater for svarte amerikanske engelsktalere som var dobbelt så høye som for hvite amerikanske engelsktalere, og aksentrelaterte forskjeller for ikke-innfødte er enda større.
Et intervju tatt opp på en kafé med to ikke-innfødte engelsktalere vil vanligvis gi en nøyaktighet i høy 70-årene fra et verktøy som annonserer 99%. Gapet er en strukturell konsekvens av treningskorpus som er vektet mot studioinnspilt tale med majoritetsaksent. Cockatoo transkriberer 36 språk, og feilratene per språk V4-Pro, både på FLEURS og på virkelige opptak, er publisert på referansesiden, det rette stedet å sjekke språket ditt før du setter i gang med et spesialopptak.
Når du først har en nøyaktig transkripsjon, er neste friksjonspunkt å få den inn i et format en kollega faktisk kan åpne og redigere. Cockatoo eksporterer til PDF og DOCX direkte, slik at en transkripsjon lander som en Word- eller PDF-fil som noen andre kan redigere uten noe konverteringstrinn – en detalj som høres ubetydelig ut helt til du har forsøkt å hente en ren tekstfil inn i et formatert dokument under en tidsfrist.
3. Speaker Diarization Error Rate (DER) - Det skjulte nøyaktighetslaget som leverandører nesten aldri publiserer
Diarization Error Rate (DER) måler hvor nøyaktig et system tildeler hvert ord til riktig taler. Den beregnes som summen av tapt tale, falske alarmer og talerforvirring, delt på total referansetaletid. Bransjereferanser på flertaler-møteopptak fra kilder som NIST Rich Transcription-evalueringene viser DER-tall på 15-30% på overlappende eller telefontolkvalitetslyd, noe som betyr at i et panel med fire personer kan opptil tre av ti ord bli tildelt feil taler.
Leverandører publiserer nesten aldri DER sammen med WER. Resultatet er at en transkripsjon kan se nøyaktig ut på ordnivå mens den er strukturelt ubrukelig: setninger deles midt i tanken på tvers av feil talere, handlingspunkter tilskrives feil person, og en oppryddingsbyrde som forskere innen kvalitative intervjuarbeid konsekvent beskriver som verre enn å skrive om fra bunnen av.
4. Ikke-lineært sammenbrudd i lydkvalitet - Hvorfor nøyaktighet ikke forringes jevnt, og hvorfor noen filer trenger full omskriving
Nøyaktighet glir ikke jevnt nedover når forholdene blir dårligere. Den holder seg, så bryter den sammen.
Forskning på ASR-robusthet viser en terskeleffekt: modeller opprettholder nær-referansenøyaktighet til signalforringelse krysser et kritisk punkt, hvor den akustiske modellen mister fotfestet og feilraten spikker skarpt i stedet for å klatre proporsjonalt med den tilførte støyen. Den praktiske konsekvensen er at en fil som høres «litt røff» ut for et menneskelig øre, kan ligge akkurat forbi denne terskelen og gi en transkripsjon som trenger full omskriving i stedet for lett redigering. De fleste som transkriberer alene, oppdager dette først etter at de allerede har lastet opp, ventet og åpnet resultatet.
Cockatoos Pro-plan støtter ubegrenset fillengde, så filer på flere timer går opp i sin helhet. Last opp hvilken som helst lyd- eller videofil og få en redigerbar transkripsjon tilbake. På V4-Pro oppdages talere automatisk, og å gi en taler nytt navn i editoren oppdaterer hver linje.

Transkripsjoner kommer med tidsstempler på ordnivå og automatisk tegnsetting. Nøyaktighetsbevis finnes på den publiserte referansesiden (FLEURS per språk og virkelige resultater for 36 språk, med metoden) i stedet for en bare prosentandel.
Ubegrenset fillengde betyr noe her fordi lengre opptak, som statistisk sett er mer tilbøyelige til å inneholde variable akustiske forhold gjennom hele, er filene som mest sannsynlig treffer det ikke-lineære sammenbruddspunktet underveis. Å kunne laste opp uten å avkorte filen betyr at modellen ser hele konteksten i stedet for en klippet versjon som kan starte eller slutte midt i en setning.
5. Overlappende tale og krysslyd - Hvordan samtidige stemmer ødelegger signalintegriteten ved kilden

Når to talere snakker samtidig, er problemet ikke en programvarebegrensning. Det er et fysikkproblem. Mikrofonen mottar en enkelt blandet bølgeform, og ingen modell kan perfekt separere to stemmer som opptar samme frekvensrom i samme øyeblikk. Et panelopptak med fire overlappende stemmer hvor diarisering deler setninger midt i tanken på tvers av feil talere, feiler fordi signalintegriteten ble ødelagt ved kilden.
Krysslyd i samtalopptak og videokonferanser er spesielt skadelig fordi kompresjonskodeker som brukes i disse flytene forringer de overlappende segmentene ytterligere, og etterlater modellen med et allerede forringet inndata før nøyaktighetsfaktorer som påvirker transkripsjonen i det hele tatt kommer inn i bildet.
For videoopptak med overlappende tale er det nedstrøms behovet ofte en publisert teksting eller undertekstfil snarere enn en transkripsjon for redigering. Cockatoo eksporterer undertekstfiler i SRT og VTT på alle abonnementer, sammen med DOCX, PDF, TXT, CSV og JSON, og bulk-eksport følger med Pro, slik at den korrigerte utdataen kan leveres direkte til videoen uten at en separat konvertering er nødvendig.
6. Domenespesifikt vokabular og teknisk sjargong - Det leksikalske gapet som blåser opp ordfeilraten på spesialistopptak
Generelle ASR-modeller er optimalisert for hverdagsvokabular og strever med medisinsk, juridisk, vitenskapelig eller bransjespesifikk terminologi. Når en taler bruker domenejargong, erstatter modellen det med det nærmeste fonetisk like vanlige ordet, noe som produserer feil som er vanskeligere å oppdage ved gjennomgang fordi de leses som plausible. For fagfolk som transkriberer spesialistinnhold, er dette leksikalske gapet en konsistent og underrapportert driver for tap av transkripsjonsnøyaktighet som WER-scorer på ren lyd fullstendig tilslører.
Hvordan god transkripsjonsnøyaktighet faktisk ser ut på tvers av ulike brukstilfeller
Nøyaktighetskrav er ikke én enkelt terskel. Terskelen som gjør et personlig talenotat fullt brukbart, ville fått en compliance-ansvarlig sparket. Nøyaktighetsnivået et transkripsjonsverktøy faktisk må levere, skalerer med hvor katastrofalt ett enkelt feil ord kan forplante seg nedstrøms, så leverandørens hovedtall er aktivt misvisende for enkelte brukere.
En undervurdert felle: standardmål for ordfeilrate kan lyve ved å utelate. Et verktøy som stille dropper kryssprat, og hopper over overlappende talere i stedet for å forsøke å transkribere dem, vil oppnå en lavere WER enn et verktøy som prøver og av og til roter til disse utvekslingene. Det første verktøyet ser mer nøyaktig ut på papiret mens det leverer mindre av ditt faktiske møte.
1. 80-90% nøyaktighet - Den akseptable nedre grensen for uformelle notater og personlig diktering
Uformelle notater og personlig diktering tåler 80-90% nøyaktighet fordi kostnaden ved et mistet ord er lav og korrigeringen er rask. En handleliste med to forvrengte elementer er en mindre irritasjon. Utøvere som bruker tale-til-tekst for personlig kunnskapsadministrasjon, finner konsekvent at det å rette noen få feil per avsnitt ikke sletter tiden spart på innfanging. Den reelle begrensningen her er kognitiv belastning, ikke presisjon.
Selv på dette nivået er det et subtilt pålitelighetsproblem som snubler mange brukere: en innledende periode med høy ytelse etterfulgt av et uforklarlig fall i nøyaktighet. Når det skjer, er instinktet å anta at lydkvaliteten endret seg, mens den egentlige årsaken ofte er at modusen eller behandlingsbanen skiftet. Cockatoo sin benchmarks-side publiserer feilrater per språk for V4-Pro, med metoden, slik at du kan sjekke hvordan språket ditt presterer før du forplikter deg til en arbeidsflyt, i stedet for å oppdage misforholdet etter fallet.
2. 95%+ nøyaktighet - Minimumsstandarden for forretningsmøter, podkaster og medieteksting
Forretningsmøter, podkasttranskripsjoner og videoteksting ligger på et annet nivå. En ordfeilrate på 4% høres liten ut helt til den forvrenger navnet til en klient, dropper et budsjettall eller feiltilordner en oppgave til feil person. Et markedsføringsteam som tekster sosiale videoer kan tåle en WER på 4%; et team som produserer en opplæringsvideo for compliance, kan ikke. På dette nivået er egennavn og tall de første ofrene for redusert nøyaktighet, og det er nettopp ordene som driver beslutninger.
Korreksjonsarbeidsflyten betyr like mye som den innledende nøyaktigheten. I Cockatoo sin nettleserredigering fanger du feilleste navn og retter taleretiketter uten å behandle filen på nytt, og å gi nytt navn til en taler oppdaterer hver linje. For møteopptak inkluderer Pro også Canvas for sammendrag. I stedet for å lese gjennom en hel time på nytt for å verifisere hver oppgave, kan du arbeide fra et sammendrag av det som faktisk må handles på, og deretter gå inn i transkripsjonen bare for de målrettede korrigeringene. Denne to-trinns arbeidsflyten holder forretningsnivåets nøyaktighet oppnåelig uten å betale en menneskelig transkribent for hver fil.
3. 99%+ nøyaktighet - den ufravikelige terskelen for juridisk, medisinsk og samsvarsrelatert transkribering
Juridisk, medisinsk og samsvarsrelatert transkribering krever 99%+ nøyaktighet uten meningsfulle unntak. Et enkelt ombyttet eller feilhørt ord kan endre betydningen, føre til erstatningsansvar eller gjøre at en transkripsjon ikke består en regulatorisk revisjon. Bransjeforskning sier det klart: et enkelt unøyaktig ord kan endre betydningen av en diagnose, behandlingsplan eller medisininstruks. På dette nivået kan de fleste AI-verktøy ikke garantere terskelen på virkelig lyd, og gapet mellom en leverandørs overskriftstall og faktisk ytelse i felt er der erstatningsansvaret ligger.

Problemet med WER-måling er tydeligst her. Hvis et verktøy stille utelater en spesialists kryssprat under en diskusjon med flere klinikere, kan den resulterende transkripsjonen få god poengsum på feilrate mens den mangler klinisk viktig innhold helt, et verre utfall enn en transkripsjon som forsøkte passasjen og flagget usikkerhet. Å vite hvordan et verktøy håndterer overlappende tale, ikke bare dens samlede nøyaktighetspoengsum, er avgjørende før man stoler på det på opptak med høy risiko.
4. Menneskelig transkribering ved 99%+: Referansen AI må måles mot
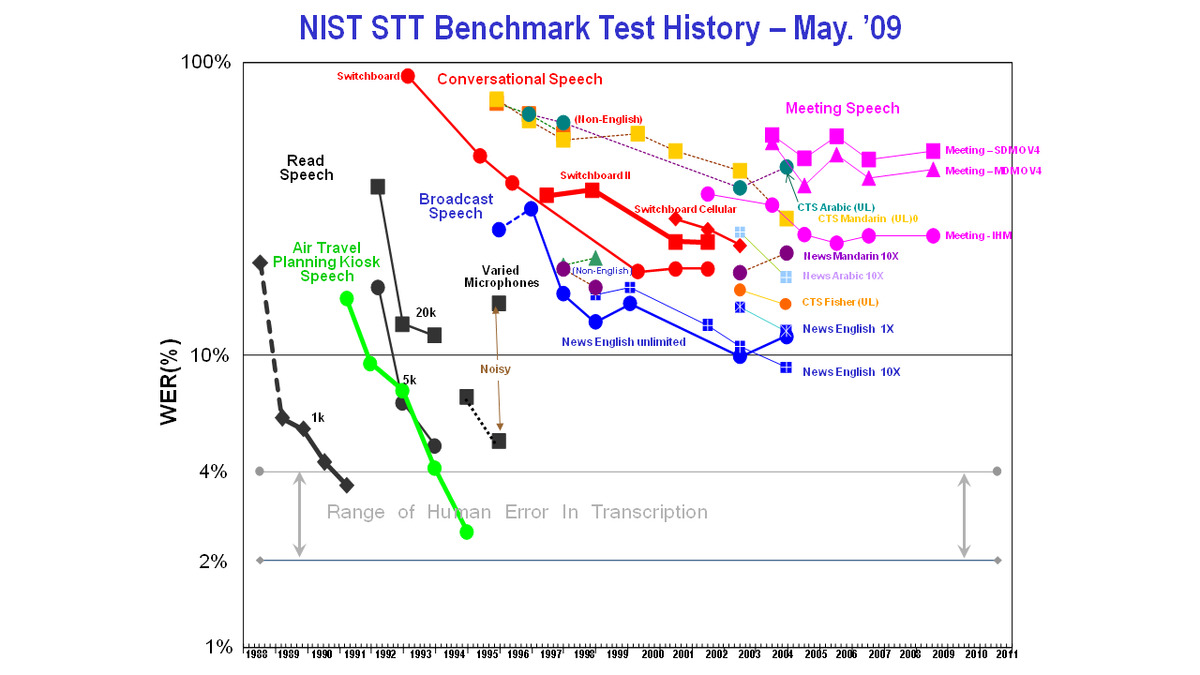
Dyktige menneskelige transkribenter oppnår konsekvent 99%+ nøyaktighet fordi de lytter på nytt, utleder kontekst og tilpasser seg aksenter på måter en statistisk modell ikke kan. Det er referansen AI måles mot, og på ren studiolyd har gapet blitt betydelig mindre. På aksentpreget, støyende eller flertaleropptak utvides gapet på måter brukere ikke kan forutse på forhånd. Menneskelig transkribering er det riktige valget når opptaket virkelig har høy risiko og lydforholdene er dårlige; det er overkill for et førstedrafts sammendrag av et forretningsmøte.
Det praktiske spørsmålet for de fleste prosumere og små bedrifter er om verktøyet de vurderer, er benchmarket på lyd som ligner deres faktiske opptak. Cockatoo adresserer mellomlaget direkte: AI-utdata fungerer umiddelbart for uformelle notater og møteutkast, og nettleserredigereren håndterer korreksjonsrunden for forretningsnivået, og får navn, tall og taleretiketter riktig uten en menneskelig transkribent på hver fil. På Pro betyr Canvas-sammendrag at lange opptak kan kondenseres til det som faktisk trenger handling, slik at korreksjonsrunden er avgrenset og rask i stedet for åpen.
Brukere kan verifisere hele denne arbeidsflyten mot sine egne filer på Free-planen, med ubegrensede fullengde transkripsjoner, ingen daglig grense og ingen kredittkort påkrevd, pluss ukentlige V4-Pro-forhåndsvisninger, før de forplikter seg til et betalt nivå. Pro kjører hele opptak i V4-Pro, med taleretiketter og ubegrenset fillengde, og legger til Canvas-sammendrag, noe som gjør det praktisk å kjøre flertimersopptak gjennom samme arbeidsflyt i skala.
Å kjenne terskelen din er bare halve ligningen. Det vanskeligere spørsmålet er om noe AI-verktøy, inkludert de som oppgir 99% på hjemmesiden sin, faktisk klarer den terskelen på den aksentpregede, støyende, domenespesifikke lyden som ligger i opptaksmappen din. Det er nettopp det neste avsnitt måler.
Relatert lesing
- Beste transkriberingsprogramvare
- Turboscribe-priser
- Lokal AI-transkribering
- Hvordan transkribere en video
- Flerspråklig transkribering
- Offline AI-transkribering
Hvordan AI-transkriberingsnøyaktighet sammenlignes med menneskelig transkribering på lyden du faktisk har
Valget mellom AI og menneskelig transkribering ser ut som en kvalitetsdebatt, men det er egentlig en forhold-debatt.
På ren lyd matcher AI nesten menneskelige transkribenter
Ifølge VexaScribes benchmark-analyse matcher eller overgår topp AI-motorer den gjennomsnittlige menneskelige transkribenten ved omtrent 4-5% WER på rene engelske enkeltaleropptak. Et 60-minutters intervju som returnerer ved 3% WER tar omtrent 15 minutter å gjennomgå, og ytelsesforskjellen mellom de beste og dårligste store AI-motorene ligger på omtrent 3-5 WER-poeng.
En undervurdert implikasjon: på rent videomateriale, en forelesning, en produktdemo, et innspilt webinar, er AI-nøyaktigheten ofte høy nok til at Cockatoo kan gjøre transkripsjonen om til SRT- eller VTT-tekstfiler på sekunder, klare for en rask gjennomgang før publisering.
Gapet øker på lyd fra virkeligheten fordi mennesker utleder mens AI gjetter
På opptak fra virkeligheten endrer bildet seg. VexaScribe sin analyse fant at på møter, telefonsamtaler og tale med aksent ligger AI 2-5% WER bak dyktige menneskelige transkribenter. En AI-modell mønstermatchar mot treningsdata, og når lyden faller utenfor denne fordelingen, synker nøyaktigheten brått og uforutsigbart, mens menneskelige transkribenter utleder mening fra kontekst. Menneskelig produksjon av en transkripsjon gjør den ikke nøyaktig; den gjør den forfattet, med all den selektive oppmerksomheten og utledningen det innebærer.
Korrigeringstid er den skjulte kostnaden som visker ut AIs hastighetsfordel på vanskelig lyd
Et 60-minutters intervju med to ikke-morsmålstalere og hørbar bakgrunnsstøy kan komme tilbake fra AI med 14% WER.
Cockatoo sin Canvas, som følger med Pro, er laget for akkurat dette: i stedet for å linjeredigere en lang transkripsjon ord for ord, bruker du den til å oppsummere opptaket ned til det som faktisk trenger å handles på.
Slik forbedrer du transkripsjonsnøyaktigheten før du laster opp en eneste fil
Et opptak gjort i et støyende rom gir enhver transkripsjonsmotor et problem den ikke kan løse fullt ut. Verktøyet mottar det mikrofonen fanget opp; det kan ikke rekonstruere taleinformasjon som aldri ble rent innspilt i utgangspunktet. Derfor er den enkeltforbedringen med høyest effekt som er tilgjengelig for enhver bruker, en beslutning om maskinvare og miljø tatt før opptak, ikke en programvareinnstilling som slås på ved opplasting.
De fleste antar at løsningen er et bedre verktøy. Den egentlige løsningen er bedre kildelyd. Her er seks konkrete trinn som monner.
1. Oppgrader mikrofonen før du rører en eneste programvareinnstilling
Journal of Electrical and Electronic Engineering bekrefter at kardioidmikrofoner overgår rundstrålende design i støyende omgivelser ved å dempe lyd som kommer fra sidene og baksiden, og bevare talesignalet foran. En $50 USB-kondensatormikrofon rettet direkte mot taleren gir enhver transkripsjonsmotor et renere signal enn en laptopmikrofon noen gang kan. Å bruke penger på et høyere abonnementsnivå mens du spiller inn med innebygd maskinvare optimaliserer feil ende av prosessen.
2. Spill inn i et stille rom for å eliminere den største nøyaktighetsdreperen
Et klimaanlegg, en gate utenfor eller en vifte som går, akkumuleres til feil gjennom et helt opptak. Lukk dører, slå av alt som surrer, og spill inn borte fra vinduer. Jo stillere rommet er, jo mer taleinformasjon fanger mikrofonen opp, og jo mindre må motoren gjette.
3. Demp varsler og sett enheter på stille før hver innspillingsøkt
Varsellyder er korte, men påvirkningen er uforholdsmessig stor. En enkelt varsellyd som overlapper et talt ord kan ødelegge det ordet fullstendig, fordi motoren mister sitt konfidensanker akkurat i det øyeblikket, og ordene rundt lider ofte også. Sett telefoner på stille, lukk nettleserfaner som spiller av lyd automatisk, og deaktiver systemsounds på alle datamaskiner i rommet før du trykker på opptak. Dette koster tretti sekunder med oppsett og sparer rutinemessig minutter med korrigering.
4. Unngå telefonhøyttalere og innebygde laptopmikrofoner for ethvert seriøst opptak
Telefonlyd behandlet gjennom en smalbåndskodek fanger opp et komprimert frekvensområde som fjerner akustisk detalj motoren er avhengig av for å skille liknende ord. Innebygde laptopmikrofoner har samme problem: de er rundstrålende og plassert langt fra talerens munn, så de fanger opp rommet like lett som stemmen. Begge er akseptable for uformelle notater der mindre feil har liten betydning. For ethvert opptak der navn, tall eller beslutninger betyr noe, er ingen av dem en pålitelig opptaksenhet.
5. Sett nøyaktighetsforventninger før du godtar feltinnspillinger eller lyd fra telefonsamtaler
Hvis noen sender deg en innspilling de har gjort på en telefon på en travel kafé, er nøyaktighetstaket allerede satt før du laster den opp. Ingen motor, og ingen mengde justeringer etter opplasting, gjenoppretter taleinformasjon som aldri ble fanget opp rent. Før du godtar en fil fra en klient eller kollega, still ett spørsmål: ble den spilt inn nær taleren i et stille rom? Hvis svaret er nei, flagg det med en gang. Å rette opp en dårlig transkripsjon tar langt lengre tid enn å justere forventningene før arbeidet begynner.
6. Revider eldre og arkiverte innspillinger for kvalitet før du forplikter deg til transkribering
Eldre innspillinger bærer artefakter, båndsus, kodekstøy, båndbreddekomprimering, som moderne AI-motorer håndterer annerledes enn menneskelige transkriberere. Et menneske lytter på nytt og utleder fra kontekst; en motor gir sitt beste statistiske gjett og går videre, så feil samler seg stille rundt forringede partier. Før du laster opp en arkivfil, spill av tretti sekunder og lytt etter sus, klipping eller ekko. Hvis avspillingen høres røff ut for øret ditt, vil den lese verre i transkripsjonen. Å spille inn et kort segment på nytt der det er mulig, eller flagge de forringede delene før opplasting, koster minutter og sparer en full omskriving.
Det eneste nøyaktighetstallet som er verdt å stole på, er ett du kan verifisere selv
Word Error Rate-prosenter som publiseres av leverandører, måles vanligvis mot ren, studiospilt inn engelsk tale, forhold som har lite til felles med den forringede, flerspråklige eller domenespesifikke lyden de fleste organisasjoner faktisk jobber med. Meningsfulle benchmarks navngir testsettet, spesifiserer språk- og aksentfordelingen og bryter ned ytelsen etter lydkvalitetsnivå i stedet for å presse alt sammen til ett optimistisk gjennomsnitt.
"Brukere kan ikke uavhengig verifisere «40% bedre nøyaktighet» eller «mye bedre nøyaktighet»-påstandene som TranscribeX kommer med; det finnes ingen benchmark, testfil eller metodikk som noen kan gjenskape selv."
— det vi hører fra brukere av transkriberingsprogramvare
Google FLEURS-benchmarken dekker ekte innspilt tale på tvers av 102 språk under standardiserte forhold, noe som gjør den til en reproduserbar ekstern referanse enhver bruker kan krysssjekke. FLEURS publiserer språkspesifikke evalueringssplitt, så en ordfeilrate per språk på FLEURS er en verifiserbar påstand, ikke et tall leverandøren har valgt under gunstige forhold.
En modell som presterer godt på engelsk med majoritetsaksent, kan gi betydelig høyere feilrater på indonesisk, assamesisk eller fransk uten at overskriftstallet beveger seg i det hele tatt. Reviderbar nøyaktighet krever tre ting sammen: en navngitt benchmark (FLEURS kvalifiserer), nedbryting per språk i stedet for et samlet tall, og testlyd som gjenspeiler virkelige innspillingsforhold.
Hvorfor avveiningen mellom nøyaktighet og overkommelighet er et teknologiproblem, ikke en fysikklov
Toppmoderne dyp læring, konstruert for hastighet og nøyaktighet, gjør høy nøyaktighet overkommelig uansett volum.
Cockatoo publiserer resultater per språk for sin V4-Pro-modus på tvers av alle 36 språk den transkriberer. De er målt på FLEURS og på et internt, menneskelig merket sett med virkelige innspillinger, scoret som WER (CER for kinesisk, japansk, khmer og thai) med OpenAI Whisper sin åpen kildekode-tekstnormalisering. Gapet denne artikkelen beskriver, vises også i disse tallene. På engelske FLEURS-klipp er V4-Pro sin ordfeilrate 3.9%. På virkelige engelske innspillinger er den 10.4% til 10.9%. V4-Pro har den laveste feilraten av de testede leverandørene i 25 av 36 språk på FLEURS, men ikke på alle språk: på engelsk FLEURS scoret AssemblyAI sin Universal-3.5 Pro lavere. Resultatene, metoden og et notat om at det virkelige settet er en in-sample-sjekk, finnes på benchmarks-siden. Nøyaktighet varierer etter språk og innspillingskvalitet.
Hvordan kjøre en femminutters verifiseringstest før du abonnerer på noe
Tell feil mot det som faktisk ble sagt. En leverandørs benchmark på FLEURS forteller deg gulvet; ditt eget klipp forteller deg virkeligheten. En ekstern benchmark pluss en prøve på en ekte fil fjerner til sammen den informasjonsasymmetrien som en leverandørs egenrapporterte tall etterlater på plass.
Relatert lesing
- Beste transkripsjonsapp
- Descript Vs Otter
- Fireflies Vs Otter
- Trint Vs Rev
- Happy Scribe Vs Rev
- Otter.AI-konkurrenter
Neste steg
Hvis opptakene dine stadig kommer tilbake med transkripsjoner som tar lengre tid å rette enn å skrive inn på nytt, begynner veien videre med å innse at det fremhevede nøyaktighetstallet aldri ble målt på lyd som din. Start med vår transkripsjonsprogramvare.
Lydkvalitetens innvirkning på nøyaktigheten overgår enhver forskjell mellom motorer, og gapet mellom de beste og dårligste AI-verktøyene på virkelige opptak krymper til 3 til 5 WER-poeng, en margin som opptaksforhold alene kan svinge med en større margin. Det betyr at å velge et "mer nøyaktig" verktøy uten først å teste det på dine egne filer er å optimere feil variabel. Samtidig har en leverandør som publiserer resultater per språk på et standardisert eksternt datasett og lar deg teste på din egen lyd før du betaler, strukturelt fjernet den informasjonsasymmetrien som gjør nøyaktighetspåstander uverifiserbare av design.
Disse to betingelsene sammen, ekstern benchmark pluss prøve på ekte fil, er den eneste kombinasjonen som lar deg revidere påstanden i stedet for å stole på den. Sammen peker de mot ett åpenbart neste steg: kjør din egen lyd gjennom et verktøy som publiserer begge.
Start med transkripsjonsprogramvare som publiserer FLEURS-benchmarks per språk og ikke krever kredittkort for å teste. Last opp et ekte klipp fra dine egne opptak, sammenlign resultatet med de publiserte tallene for språket ditt, og du har det eneste nøyaktighetstallet som noen gang overføres til produksjonsforhold.
Ofte stilte spørsmål
Hva betyr egentlig en nøyaktighetsgrad på 95% for transkripsjonen min i praksis?
En nøyaktighetsgrad på 95% betyr omtrent 25 feil i hver transkripsjon på 500 ord, nok til å feilnavngi en klient, forvrenge et tall eller miste et viktig handlingspunkt helt. På virkelige opptak med bakgrunnsstøy, aksenter eller flere talere faller nøyaktigheten rutinemessig ytterligere, ned i området 85 til 92%, der den samme transkripsjonen kan inneholde 75 feil og trenge en full omskriving i stedet for lett redigering.
Hvorfor annonserer leverandører 98% eller 99% nøyaktighet når transkripsjonene mine kommer tilbake fulle av feil?
Leverandører benchmarker verktøyene sine mot ren lyd av studiekvalitet med én taler, datasett som LibriSpeech med profesjonelle mikrofoner, ingen bakgrunnsstøy og ingen aksentvariasjon, og er ikke pålagt å opplyse om disse testforholdene. Intervjuet ditt, samtalopptaket eller møteopptaket ditt samsvarer nesten helt sikkert ikke med disse forholdene, så det fremhevede tallet ble rett og slett ikke målt på lyd som din.
Hvor ille blir egentlig overlappende tale for transkripsjonsverktøy?
Når to talere snakker samtidig, fanger mikrofonen en enkelt blandet bølgeform som ingen modell kan separere perfekt, fordi stemmene opptar samme frekvensrom samtidig; det er et fysikkproblem, ikke et programvareproblem. I tillegg til ordfeilene dette forårsaker, viser bransjebenchmarks på flertaler-møteopptak diariseringsfeilrater på 15-30% på overlappende lyd eller telefonkvalitetslyd, noe som betyr at opptil tre ord av ti kan bli tilordnet feil taler i et panel på fire personer.
Er ordfeilrate det samme som nøyaktighetsprosenten som vises på en leverandørs hjemmeside?
Ja, nøyaktighetsprosenten er bare WER invertert. WER beregnes som (Substitusjoner + Slettinger + Innsettinger) delt på totalt ordantall i en referansetranskripsjon, så en WER på 5% blir en påstått nøyaktighet på 95%. Hver feiltype teller likt i formelen, noe som betyr at en sletting som fjerner ordet "ikke" fra "ikke fortsett" koster det samme som en triviell stavefeil, og feilene klynger seg rundt de vanskeligste øyeblikkene, aksentert tale, overlappende stemmer og domenespesifikke termer, i stedet for å spre seg jevnt utover transkripsjonen.
Må opptaket mitt bli virkelig dårlig før nøyaktigheten kollapser, eller glir den gradvis?
Nøyaktighet glir ikke jevnt nedover, den holder seg nær referansenivåer og bryter deretter brått sammen når signalforringelse krysser en kritisk terskel. Forskning på ASR-robusthet viser at denne terskeleffekten betyr at en fil som bare høres "litt røff" ut for et menneskelig øre, allerede kan ha passert punktet der feilraten øker dramatisk, og returnerer en transkripsjon som trenger full omskriving i stedet for lett redigering.






