วิธีถอดเสียงวิดีโออย่างรวดเร็วด้วย AI
คำบรรยายอัตโนมัติดูเหมือนฟรีจนกว่าคุณจะต้องใช้เวลาหนึ่งชั่วโมงในการแก้ไข นี่คือเหตุผลว่าทำไมทรานสคริปต์ AI ที่สร้างขึ้นโดยเฉพาะจึงเอาชนะคำบรรยายของ YouTube ได้ในด้านความแม่นยำ ความเร็ว และต้นทุนเวลารวมในทุกครั้ง
การถอดเสียงวิดีโอหมายถึงการแปลงทุกคำพูดในการบันทึกเป็นไฟล์ข้อความ รูปแบบของไฟล์นั้นมีความสำคัญทันที ไฟล์ TXT เป็นข้อความธรรมดา มีประโยชน์สำหรับการวางลงในเอกสารหรือป้อนเข้าสู่เครื่องมืออื่น
ไฟล์ SRT จับคู่แต่ละบรรทัดของบทสนทนากับการประทับเวลา เพื่อให้แพลตฟอร์มวิดีโอรู้ว่าควรแสดงเมื่อใด ไฟล์ VTT ทำหน้าที่เดียวกันแต่เป็นไปตามมาตรฐานที่แตกต่างเล็กน้อยซึ่งใช้โดยเครื่องเล่นเว็บ การเลือกรูปแบบผิดเมื่อจบเซสชันการแก้ไขที่ยาวนานหมายถึงต้องเริ่มขั้นตอนการส่งออกใหม่ทั้งหมด การทำให้ถูกต้องตั้งแต่การอัปโหลดครั้งแรกช่วยประหยัดงานซ้ำนั้นได้ทั้งหมด
คำบรรยายในตัวของ YouTube รวมถึงฟีเจอร์คำบรรยายอัตโนมัติของ YouTube ได้รับการฝึกฝนหลักจากคำพูดที่สะอาดและมีคุณภาพระดับสตูดิโอ ทันทีที่การบันทึกมีสำเนียงของผู้ที่ไม่ใช่เจ้าของภาษา ผู้ที่พูดเร็ว หรือคำศัพท์เฉพาะอุตสาหกรรม ความแม่นยำจะลดลงอย่างรวดเร็ว จากงานวิจัยการวัดประสิทธิภาพ 2026 ของ Gladia โมเดลที่ฝึกฝนจากเสียงมาตรฐานจะจัดการคำพูดที่มีสำเนียง ผู้ที่พูดเร็ว และคำศัพท์เฉพาะด้านได้ผิดพลาดอย่างเป็นระบบ ชื่อผลิตภัณฑ์กลายเป็นวลีที่ไร้ความหมาย คำพ้องเสียงถูกสลับอย่างเงียบ ๆ และเครื่องหมายวรรคตอนหายไป เปลี่ยนประโยคพูดที่ชัดเจนให้กลายเป็นประโยคยาวที่ไม่มีเครื่องหมายวรรคตอน
การแก้ไขคำบรรยายอัตโนมัติที่ผิดเพี้ยนมักใช้เวลานานกว่าการพิมพ์การบันทึกใหม่ตั้งแต่ต้น การบันทึกความยาว 30 นาทีที่มีความหนาแน่นของสำเนียงปานกลางหรือคำศัพท์ทางเทคนิคสามารถสร้างเวลาการแก้ไขทีละบรรทัดได้มากกว่า 60 นาทีอย่างง่ายดาย ในอัตราค่าจ้างฟรีแลนซ์สำหรับการแก้ไขทั่วไป เซสชันนั้นมีต้นทุนเป็นตัวเงินจริงแม้จะไม่มีการออกใบแจ้งหนี้ Cockatoo ส่งคืนทรานสคริปต์ที่มีเครื่องหมายวรรคตอนและประทับเวลาได้ภายในไม่กี่วินาที มักจะก่อนที่คุณจะเลื่อนดูคำบรรยายอัตโนมัติที่ผิดเพี้ยนในช่วงสองสามนาทีแรกเสร็จด้วยซ้ำ
ประเด็นสำคัญ
-
คำบรรยายอัตโนมัติดูเหมือนฟรีจนกว่าคุณจะใช้เวลาหนึ่งชั่วโมงแก้ไขทุกคำที่ได้ยินผิด เวลาทำความสะอาดนั้นคือราคาจริง และแทบไม่เคยปรากฏในประมาณการของใครเลย
-
เครื่องมือถอดเสียง AI ทำความแม่นยำได้ 90-95% กับคำพูดมาตรฐานก่อนที่คุณจะแตะต้องคำใด ๆ งานแก้ไขจึงเป็นการสแกนแบบเจาะจง ไม่ใช่การเขียนใหม่
-
รูปแบบไฟล์ที่คุณส่งออกมีความสำคัญพอ ๆ กับทรานสคริปต์เอง การเลือกผิดจะสร้างงานรอบที่สองที่ยกเลิกเวลาที่ AI เพิ่งประหยัดไปอย่างเงียบ ๆ
-
คำกล่าวอ้างลอย ๆ ว่า '98% แม่นยำ' บนหน้าค่าบริการไม่ได้บอกอะไรคุณเลย: ไม่ได้บอกว่าภาษาใด สำเนียงอะไร หรือเสียงเป็นการบันทึกในสตูดิโอที่สะอาดหรือการโทรศัพท์
-
คำบรรยายในตัวของ YouTube มีปัญหาเรื่องสำเนียง คำศัพท์ทางเทคนิค และคำพูดที่ทับซ้อนกัน พวกมันเป็นงานแก้ไขชิ้นที่สอง ไม่ใช่ทรานสคริปต์ที่เสร็จสมบูรณ์
-
Cockatoo ปิดช่องว่างนั้น: อัปโหลดไฟล์วิดีโอใด ๆ หรือวางลิงก์ แล้วรับทรานสคริปต์ที่แก้ไขได้พร้อมการประทับเวลากลับมา ใน V4-Pro ผู้พูดถูกติดป้ายกำกับโดยอัตโนมัติ และการเปลี่ยนชื่อคนหนึ่งจะอัปเดตทุกบรรทัด ความแม่นยำเผยแพร่แยกตามภาษาบน FLEURS ทั่ว 36 ภาษา ไม่ใช่เป็นเปอร์เซ็นต์ลอย ๆ
สามวิธีหลักในการถอดเสียงวิดีโอคืออะไร
การเลือกวิธีถอดเสียงที่เหมาะสมขึ้นอยู่กับการเข้าใจว่าวิธีแต่ละวิธีมีต้นทุนจริงในด้านเวลา เงิน และความพยายามอย่างไร มีสามวิธีในการเปลี่ยนวิดีโอที่บันทึกไว้ให้เป็นข้อความที่ใช้งานได้:
-
พิมพ์เอง
-
อัปโหลดไปยังเครื่องมือถอดเสียง AI โดยเฉพาะ
-
ส่งไปยังบริการถอดเสียงโดยมนุษย์มืออาชีพ
แต่ละวิธีได้ผล คำถามจริงคือแต่ละวิธีมีต้นทุนกับคุณเท่าใด และต้นทุนที่ทำให้ผู้คนประหลาดใจที่สุดนั้นแทบจะไม่ใช่ใบแจ้งหนี้เลย
1 การถอดเสียงอัตโนมัติด้วย AI - เส้นทางที่เร็วที่สุดจากวิดีโอสู่ข้อความที่ใช้งานได้

เครื่องมือถอดเสียง AI เป็นวิธีที่เร็วที่สุดในสามวิธี โดยส่งคืนฉบับร่างที่ใช้งานได้ภายในไม่กี่นาทีแทนที่จะเป็นชั่วโมง จากการวิเคราะห์ 2024 ของ Brass Transcripts เครื่องมือ AI ให้ความแม่นยำ 90-95%กับเสียงที่สะอาด ซึ่งหมายความว่าการบันทึกหนึ่งชั่วโมงจะกลับมาพร้อมข้อผิดพลาดไม่กี่จุดต่อหน้าแทนที่จะเป็นกำแพงข้อความที่ผิดเพี้ยน
90-95%
ความแม่นยำของ AI กับเสียงที่สะอาด
โหมดความล้มเหลวมีความเฉพาะเจาะจง ความแม่นยำลดลงเมื่อมีสำเนียงหนัก มีผู้พูดพูดทับกัน และมีศัพท์เฉพาะทางในอุตสาหกรรมที่หนาแน่น ช่องว่างนั้นมีอยู่จริง แต่เวลาตัดต่อที่เหลืออยู่ยังคงสั้นกว่าทางเลือกอื่นใด ซึ่งเป็นตัวชี้วัดที่สำคัญสำหรับผู้ใช้คนเดียวที่มีกำหนดส่ง
Cockatoo ปิดช่องว่างนั้นในแบบที่ควรค่าแก่การระบุให้ชัดเจน อัปโหลดไฟล์แรกของคุณ ทั้งไฟล์เสียงหรือวิดีโอ แล้ว transcript จะกลับมาภายในไม่กี่นาที โดยไม่ต้องตั้งค่าและไม่ต้องใช้บัตรเครดิต เวลาประทับ เครื่องหมายวรรคตอน และใน V4-Pro การจดจำผู้พูด หมายความว่าร่างที่ได้กลับมามีโครงสร้างเรียบร้อยแล้ว การแก้ไขใช้เวลาเป็นนาที ไม่ใช่ชั่วโมง เมื่อเป้าหมายคือวิดีโอที่เผยแพร่ได้หรือแชร์ภายใน การส่งออกคำบรรยาย ของ Cockatoo เปลี่ยน transcript เดียวกันนั้นให้เป็นคำบรรยายที่พร้อมเผยแพร่โดยไม่ต้องใช้เครื่องมือแยกหรือขั้นตอนเวิร์กโฟลว์เพิ่มเติม
สำหรับทีมหรืองานใด ๆ ที่ทำงานกับเนื้อหาต่างภาษา transcript ที่เสร็จแล้วยังสามารถแปลได้ภายใน Cockatoo เส้นทางจากไฟล์บันทึกดิบไปสู่ไฟล์แปลที่มีคำบรรยายจึงอยู่ในเวิร์กโฟลว์เดียวแทนที่จะเป็นสาม
2. การถอดความด้วยตนเองโดยใช้เครื่องเล่นมีเดีย - ควบคุมได้มากที่สุด ใช้เวลามากที่สุด
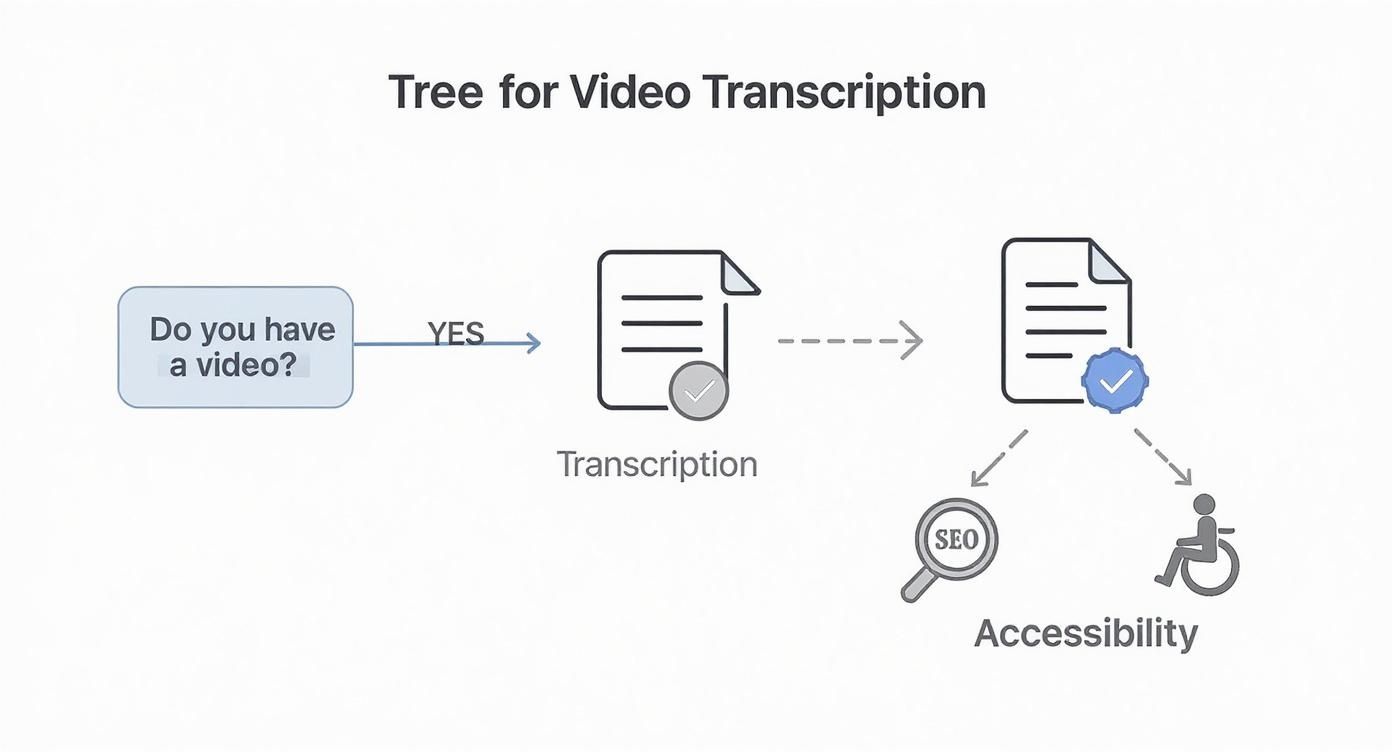
การถอดความด้วยตนเองเป็นไปตามวงจรฟัง-หยุด-พิมพ์-ย้อนกลับ โดยทั่วไปประมวลผลเสียงครั้งละ 5-10 วินาทีก่อนหยุดเพื่อตามให้ทัน การควบคุมนั้นสมบูรณ์ ต้นทุนเวลานั้นโหดร้าย
เวลาถอดความด้วยตนเองโดยเฉลี่ยนั้น เกินเวลาจริงไปมาก เสียงที่บันทึกไว้หนึ่งชั่วโมงอาจกินเวลาทำงานเกือบทั้งวัน เครื่องมืออย่าง Express Scribe (ซึ่งรองรับการควบคุมด้วยแป้นเหยียบและความเร็วเล่นแบบปรับได้) และ OTranscribe (ตัวเลือกฟรีบนเบราว์เซอร์พร้อมคีย์ลัดสำหรับหยุดและย้อนกลับ) ช่วยลดความฝืดได้เล็กน้อย แต่ไม่ได้แก้คณิตศาสตร์ที่เป็นรากฐาน คนส่วนใหญ่ที่เริ่มด้วย OTranscribe จะเปลี่ยนไปใช้เครื่องมือ AI ทันทีที่เห็นว่าไฟล์แรกใช้เวลานานเท่าไร
3. บริการถอดความด้วยมนุษย์ระดับมืออาชีพ - ความแม่นยำสูงสุดแลกกับเวลารอและใบเรียกเก็บเงิน

บริการถอดความด้วยมนุษย์มอบความแม่นยำสูงสุด ด้วยผลลัพธ์ระดับมืออาชีพที่ 96% หรือสูงกว่า ระยะเวลาดำเนินการอยู่ที่ 24-48 ชั่วโมงสำหรับคำสั่งซื้อมาตรฐาน พร้อมตัวเลือกแบบเร่งด่วนในราคาพรีเมียม
โหมดความล้มเหลวตรงนี้คือต้นทุนและการเข้าถึง บริการอย่าง GoTranscript คิดค่าบริการตามนาทีของเสียง และค่าธรรมเนียมต่อนาทีนั้นเพิ่มขึ้นอย่างรวดเร็ว ไฟล์บันทึกความยาว 90 นาทีที่ตอนแรกดู manageable กลายเป็นรายการที่ต้องอนุมัติงบประมาณ ซึ่งคนเพียงคนเดียวที่ดูแลการถอดความให้ทีมเล็ก ๆ แทบไม่เคยมี ความแม่นยำยอดเยี่ยม การได้รับการอนุมัติให้ใช้คืออุปสรรค
ในบรรดาสามวิธีนี้ การถอดความด้วย AI ชนะในตัวชี้วัดที่สำคัญสำหรับผู้ใช้คนเดียวที่มีกำหนดส่ง นั่นคือเวลารวมจากวิดีโอดิบไปสู่ transcript ที่คุณส่งต่อให้คนอื่นได้ แผนฟรีของ Cockatoo ไม่ต้องใช้บัตรเครดิต ไม่ต้องตั้งค่า ไม่มีขีดจำกัดรายวัน ให้คุณทดสอบกับไฟล์ของคุณเองได้ในอีกไม่กี่นาทีข้างหน้า บทถัดไปจะพาคุณผ่านวิธีการอย่างละเอียด ห้าขั้นตอน อัปโหลดหนึ่งครั้ง และมีร่างที่ใช้งานได้รออยู่อีกด้านหนึ่ง
วิธีถอดความวิดีโออย่างรวดเร็วด้วย AI ในห้าขั้นตอน
กระบวนการห้าขั้นตอนนั้นตรงไปตรงมา แต่การตัดสินใจสองหรือสามอย่างที่ทำก่อนคลิก "process" เป็นตัวกำหนดว่าต้องทำงานแก้ไขมากแค่ไหนที่ตกลงบนโต๊ะคุณในภายหลัง การข้ามสิ่งเหล่านี้ไม่ได้ประหยัดเวลา แต่ย้ายต้นทุนไปยังขั้นตอนแก้ไขด้วยตนเองที่ไม่มีเครื่องมือใดทำให้เป็นอัตโนมัติได้ทั้งหมด
ขั้นตอน 1 - อัปโหลดไฟล์วิดีโอของคุณไปยังเครื่องมือถอดความ AI
เริ่มต้นด้วยการลากและวางไฟล์วิดีโอของคุณลงในเครื่องมือถอดความ หรือใช้ตัวเลือกไฟล์เพื่อเรียกดูในเครื่อง Cockatoo ยังรองรับลิงก์ YouTube, Vimeo หรือ SoundCloud หรือลิงก์สาธารณะไปยังไฟล์เสียงหรือวิดีโอ ดังนั้นคุณจึงไม่จำเป็นต้องมีไฟล์อยู่ในคอมพิวเตอร์เสมอไป ขั้นตอนนี้คือจุดที่ความเข้ากันได้ของรูปแบบสำคัญที่สุด ตรวจสอบให้แน่ใจว่าเครื่องมือรองรับประเภทไฟล์ของคุณก่อนผูกพันกับเวิร์กโฟลว์ โดยเฉพาะสำหรับการบันทึกแบบยาว
ขั้นตอน 2 - เลือกภาษาและกำหนดค่าโหมดการถอดความ
เมื่ออัปโหลดไฟล์แล้ว ให้เลือกภาษาพูดและตั้งค่าโหมดถอดเสียงที่มีให้ใช้ เช่น โหมดเร็วหรือโหมดแม่นยำสูงสุด ใน Cockatoo นั่นคือ V4-Flash หรือ V4-Pro หากวิดีโอของคุณมีผู้พูดหลายคน ให้เลือกโหมดที่ติดป้ายชื่อผู้พูด ใน Cockatoo V4-Pro จะตรวจจับผู้พูดโดยอัตโนมัติ การตั้งค่าคอนฟิกูเรชันนี้ให้ถูกต้องก่อนเริ่มประมวลผลช่วยประหยัดเวลาในการแก้ไขได้มาก เนื่องจากการรันงานใหม่ต้องเสียทั้งเวลาและเครดิต
ขั้นตอนที่ 3 - ให้ AI ประมวลผลและใช้การรู้จำผู้พูดโดยอัตโนมัติ
เมื่อยืนยันการตั้งค่าแล้ว การประมวลผลจะเริ่มขึ้นทันที AI จะกำหนดป้ายชื่อผู้พูดตามการแยกแยะเสียง และเครื่องมือส่วนใหญ่ให้คุณเปลี่ยนชื่อผู้พูดได้ครั้งเดียว โดยชื่อนั้นจะถูกนำไปใช้กับทุกบรรทัดในบทถอดเสียงโดยอัตโนมัติ ความสามารถในการเปลี่ยนชื่อแบบกลุ่มนี้เป็นสิ่งที่ประหยัดเวลาที่สุดในการถอดเสียงที่มีผู้พูดหลายคน ข้อจำกัดหลักคือความแม่นยำในบันทึกที่มีการพูดทับซ้อนกันหรือเสียงที่ฟังคล้ายกัน ซึ่งอาจต้องแก้ไขด้วยตนเอง
ขั้นตอนที่ 4 - ตรวจสอบผลลัพธ์ที่ใช้การประทับเวลาและการจัดรูปแบบแล้ว
เครื่องมือถอดเสียงด้วย AI จะใช้การประทับเวลา เครื่องหมายวรรคตอน และการใช้อักษรตัวพิมพ์ใหญ่ตามค่าเริ่มต้น ดังนั้นผลลัพธ์ดิบจึงมีโครงสร้างและสามารถนำทางได้แล้ว ผู้ตรวจสอบสามารถใช้การประทับเวลาเพื่อกระโดดไปยังช่วงเวลานั้นในเสียง ทำให้การตรวจสอบข้อผิดพลาดรวดเร็ว ข้อแลกเปลี่ยนคือคำพูดที่มีสำเนียงหนักหรือศัพท์เฉพาะทางอาจยังต้องตรวจด้วยตนเอง ควรเผื่อเวลาไว้สำหรับการตรวจสอบอย่างน้อยแบบเบาก่อนถือว่าผลลัพธ์เป็นฉบับสมบูรณ์
ขั้นตอนที่ 5 - ส่งออกในรูปแบบที่คุณต้องการและคาดหวังผลลัพธ์ภายในไม่กี่นาที ไม่ใช่หลายชั่วโมง
เมื่อตรวจสอบแล้ว ให้ส่งออกบทถอดเสียงเป็นรูปแบบบล็อกย่อหน้า ทีละประโยค หรือตามรอบผู้พูด ขึ้นอยู่กับการใช้งานปลายทางของคุณ คำบรรยาย โพสต์บล็อก หรือบันทึกการประชุมแต่ละอย่างต้องการโครงสร้างที่แตกต่างกัน เครื่องมือ AI ให้ผลลัพธ์ภายในไม่กี่วินาทีถึงไม่กี่นาทีขึ้นอยู่กับความยาวไฟล์ เทียบกับการถอดเสียงด้วยมือที่ต้องใช้เวลาสี่ถึงหกชั่วโมงต่อเสียงหนึ่งชั่วโมง ข้อจำกัดเดียวคือตัวเลือกการส่งออกแตกต่างกันมากระหว่างเครื่องมือ ดังนั้นควรตรวจสอบความพร้อมใช้งานก่อนเลือกแพลตฟอร์ม
รูปแบบไฟล์วิดีโอและเสียงใดบ้างที่รองรับสำหรับการถอดเสียง
MP4 และ MOV ครองเวิร์กโฟลว์การบันทึกในโลกจริง และเครื่องมือถอดเสียงด้วย AI ส่วนใหญ่รับไฟล์เหล่านี้โดยไม่ต้องแปลงใด ๆ คำถามเรื่องรูปแบบที่คนส่วนใหญ่กังวลนั้นเป็นคำถามที่ผิดประเด็น อุปสรรคที่แท้จริงคือขีดจำกัดขนาดไฟล์และความยาว และสิ่งเหล่านี้แทบไม่เคยระบุไว้ในที่ที่เห็นชัดเจน
1. Cockatoo Pro - ไม่มีขีดจำกัดความยาวไฟล์สำหรับการบันทึกหลายชั่วโมง

แพ็กเกจฟรีของ Cockatoo มอบบทถอดเสียงเต็มความยาวแบบไม่จำกัดใน V4-Flash โดยไม่มีขีดจำกัดรายวัน ดังนั้นบทสัมภาษณ์สั้น ๆ และบันทึกเสียงจะไม่พบโควตา Cockatoo Pro รองรับความยาวไฟล์ไม่จำกัดและประมวลผลการบันทึกทั้งหมดใน V4-Pro ซึ่งเป็นโหมดแม่นยำสูงสุด ด้วยความเร็วประมาณ 20 เท่าของเวลาจริง อัปโหลด MP4, MOV, MP3, M4A, WAV และไฟล์เสียงและวิดีโอทั่วไปอื่น ๆ และส่งออกบทถอดเสียงเป็นคำบรรยาย SRT หรือ VTT พร้อมกับ DOCX, PDF, TXT, CSV และ JSON
คำถามเรื่องรูปแบบหนึ่งที่ตารางด้านบนตอบไม่ได้: จะเป็นอย่างไรหากวิดีโอของคุณไม่ใช่ไฟล์บนฮาร์ดไดรฟ์เลย แต่เป็นลิงก์ YouTube? นั่นเป็นเส้นทางการอัปโหลดที่แตกต่างออกไปโดยสิ้นเชิง และหัวข้อถัดไปจะพาคุณผ่านทีละขั้นตอนเพื่อให้คุณไม่ต้องดาวน์โหลดอะไรก่อน
2. MP4 และ MOV - รูปแบบวิดีโอที่พบบ่อยที่สุดสำหรับการถอดเสียง
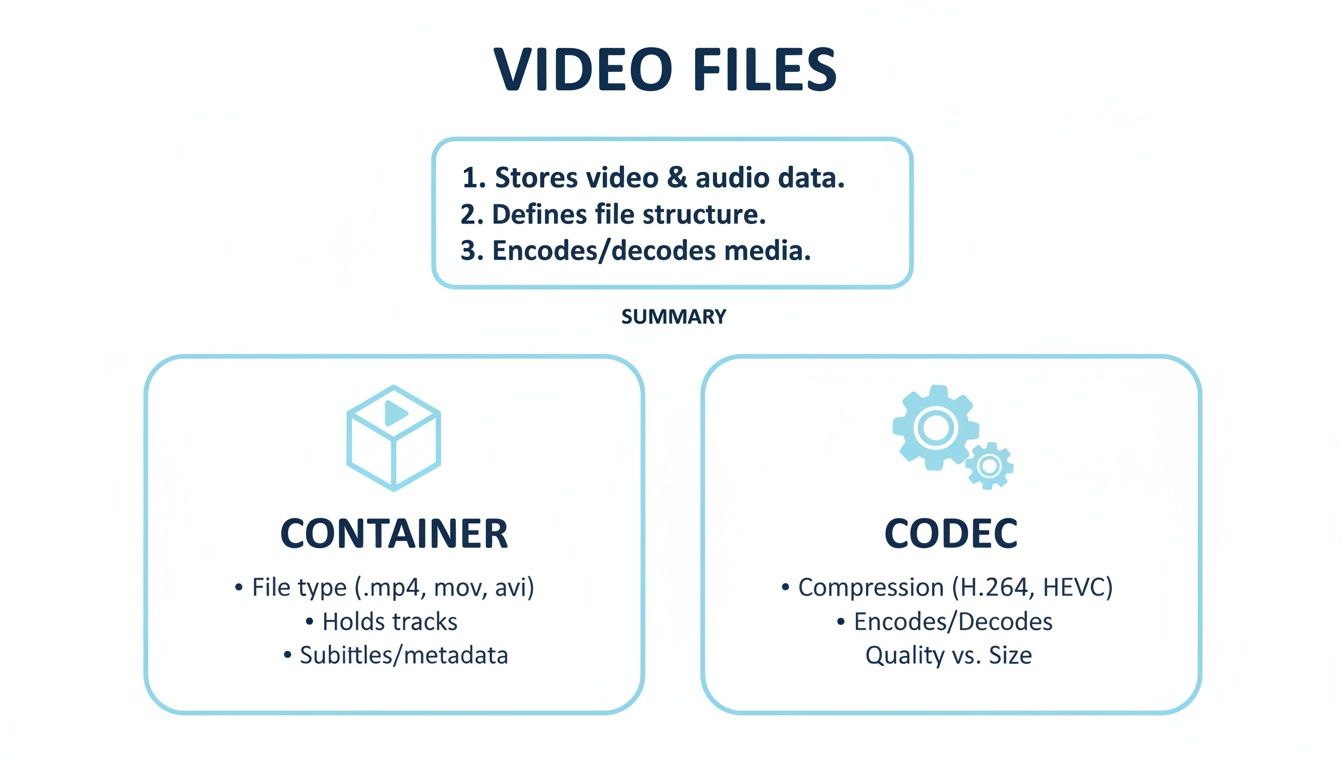
MP4 เข้ากันได้กับอุปกรณ์และแพลตฟอร์มแทบทุกชนิด ดังนั้นผู้ใช้ส่วนใหญ่จึงมีไฟล์นี้อยู่บนฮาร์ดไดรฟ์แล้ว MOV เป็นรูปแบบดั้งเดิมของ Apple ที่สร้างโดย iPhone ทุกรุ่นและการส่งออกจาก Final Cut Pro ทั้งสองรูปแบบอัปโหลดตรงเข้าเครื่องมือถอดเสียงด้วย AI โดยไม่ต้องแปลง เครื่องมือคำบรรยายของ CapCut และฟีเจอร์ Speech to Text ของ Adobe Premiere Pro ต่างรองรับ MP4 และ MOV โดยตรง ซึ่งสะท้อนถึงฉันทามติกว้าง ๆ ของอุตสาหกรรมต่อคอนเทนเนอร์ทั้งสองนี้
3. MKV และ AVI - รูปแบบวิดีโอแบบเดิมและแบบคอนเทนเนอร์เปิดที่ยังใช้งานได้
MKV และ AVI เป็นรูปแบบคอนเทนเนอร์แบบเปิดที่ถูกสร้างขึ้นเพื่อบรรจุแทร็กเสียง วิดีโอ และคำบรรยายหลายแทร็ก ดังนั้นจึงเป็นที่นิยมสำหรับการบันทึกความยาวนานเช่น เว็บบินาร์และการบรรยายหลายชั่วโมง การอัปโหลดทำได้โดยไม่มีปัญหาในเครื่องมือที่รองรับ ข้อแลกเปลี่ยนในทางปฏิบัติ: ไฟล์ MKV ความยาวสามชั่วโมงอาจมีขนาดหลายกิกะไบต์ และเครื่องมือที่มีการจำกัดขนาดไฟล์แบบตายตัวจะปฏิเสธไฟล์นั้นอย่างเงียบ ๆ แทนที่จะเตือนคุณล่วงหน้า
4. MP3 และ WAV - รูปแบบเสียงมาตรฐานสำหรับการถอดความ
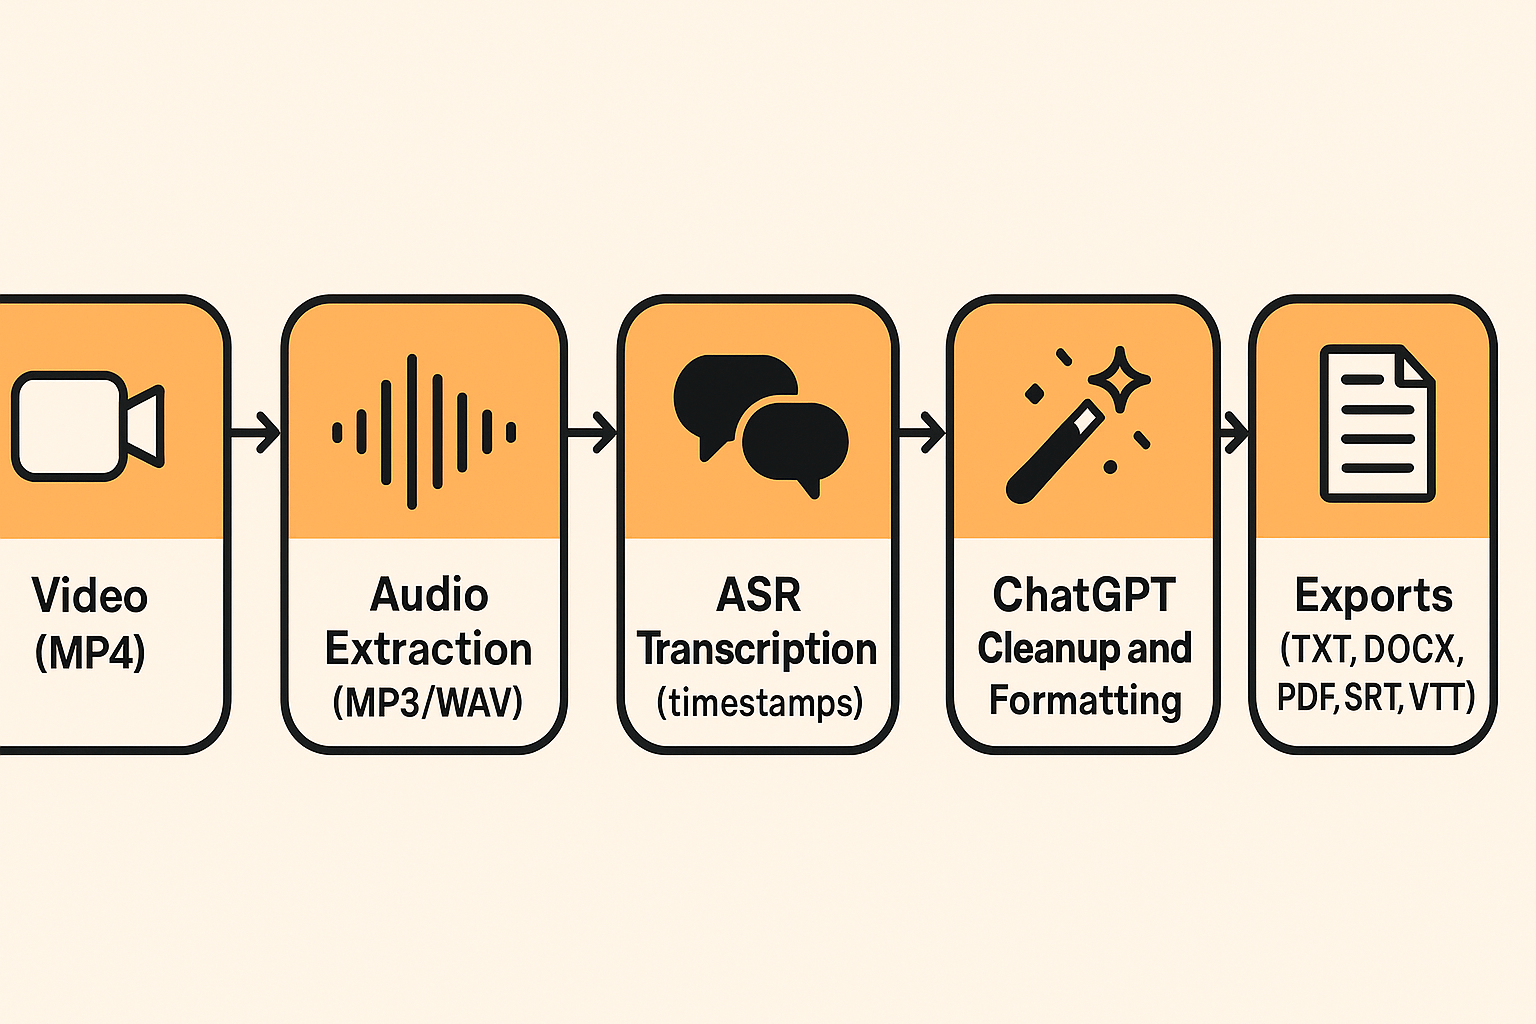
MP3 และ WAV เป็นรูปแบบเสียงพื้นฐานที่เครื่องมือถอดความทุกรองรับ ไฟล์ MP3 ถูกบีบอัด ดังนั้นการบันทึกความยาวหนึ่งชั่วโมงจึงยังมีขนาดเล็กและอัปโหลดได้เร็ว ไฟล์ WAV ไม่ถูกบีบอัด ซึ่งหมายความว่ามีความเที่ยงตรงสูงกว่าแต่มีขนาดไฟล์ใหญ่กว่า ทั้งสองแบบใช้งานได้โดยไม่ต้องแปลง หากเครื่องมือของคุณกำหนดขีดจำกัดความยาว 30 นาที ขนาดที่ใหญ่กว่าของ WAV ทำให้ถึงขีดจำกัดเร็วขึ้นในทางปฏิบัติ
5. M4A และ FLAC - รูปแบบเสียงคุณภาพสูงจากอุปกรณ์ Apple และ DAW
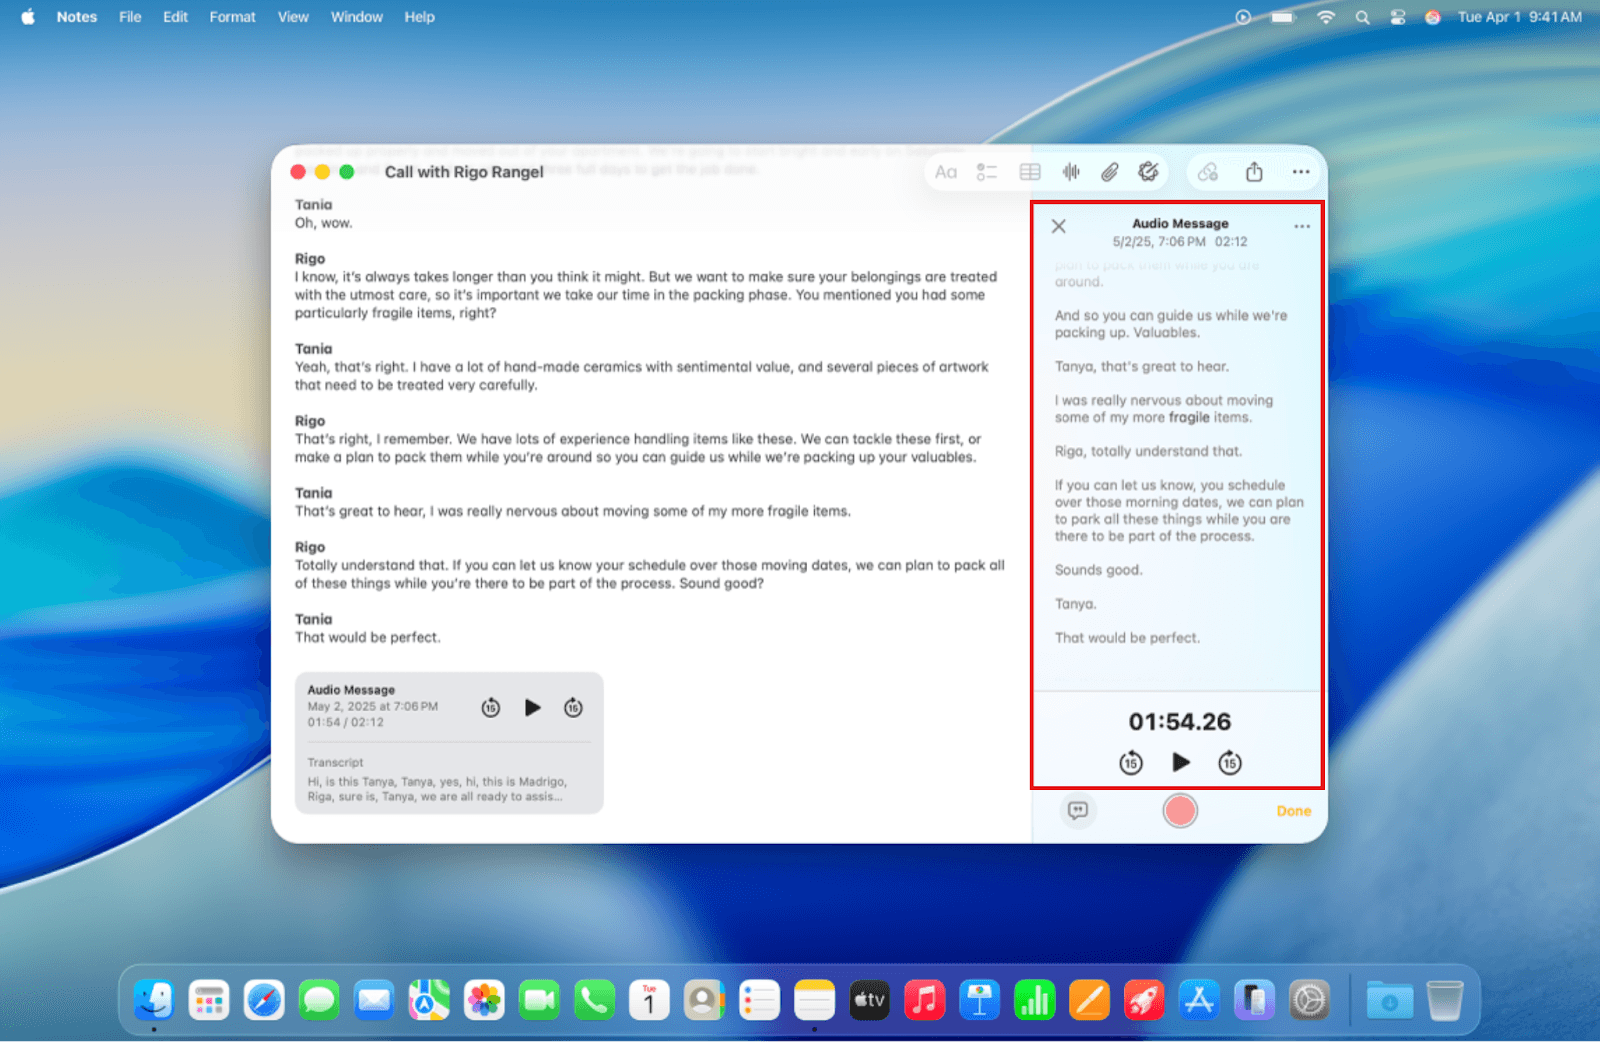
M4A เป็นรูปแบบเริ่มต้นสำหรับบันทึกเสียงด้วย iPhone และการบันทึกจากอุปกรณ์ Apple ส่วนใหญ่ ดังนั้นจึงเป็นหนึ่งในรูปแบบที่พบบ่อยที่สุดที่ผู้คนนำมาถอดความโดยไม่รู้ตัว FLAC เป็นแบบไม่สูญเสียข้อมูลและมีขนาดใหญ่กว่า MP3 อย่างมีนัยสำคัญเมื่อมีความยาวเท่ากัน ทำให้เป็นรูปแบบที่มีแนวโน้มสูงสุดที่จะพบกับการอัปโหลดหมดเวลาบนเครื่องมือที่ไม่มีระบบแยกเสียงในเบราว์เซอร์ ทั้งสองแบบได้รับการยอมรับโดยเครื่องมือถอดความด้วย AI ชั้นนำโดยไม่ต้องแปลงล่วงหน้า
บทความที่เกี่ยวข้อง
- ซอฟต์แวร์ถอดความที่ดีที่สุด
- ราคา Turboscribe
- การถอดความด้วย AI ในเครื่อง
- การถอดความหลายภาษา
- การถอดความด้วย AI แบบออฟไลน์
วิธีถอดความวิดีโอ YouTube โดยไม่ต้องดาวน์โหลดก่อน
คำบรรยายอัตโนมัติของ YouTube ดูเหมือนจะเป็นทางลัดที่สมเหตุสมผล แต่สิ่งที่ทีมส่วนใหญ่รายงานยืนยันว่าพวกเขาประสบปัญหาเกี่ยวกับสำเนียง คำศัพท์ทางเทคนิค และการพูดทับซ้อนกัน ทำให้กลายเป็นงานแก้ไขรอบสองแทนที่จะเป็นบทถอดความที่เสร็จสมบูรณ์
"การถอดความวิดีโอ YouTube โดยไม่ดาวน์โหลดต้องใช้หลายขั้นตอนที่ซับซ้อน (การดึงเสียง การแบ่งส่วน การส่งไปยัง API ถอดความ) ซึ่งผู้ใช้รู้สึกว่าเป็นภาระและซับซ้อนเกินไป"
--- สิ่งที่เราได้ยินจากนักพัฒนาที่สร้างเครื่องมือถอดความ
ข้อดีและข้อเสียโดยสรุป
| ✓ ข้อดี | ✗ ข้อเสีย |
|---|---|
| ดึงบทถอดความได้ทันที พร้อมการประทับเวลา โดยไม่มีค่าใช้จ่าย | ความแม่นยำต่ำ คำบรรยายอัตโนมัติเป็นเพียงจุดเริ่มต้น ไม่ใช่ผลิตภัณฑ์ที่เสร็จสมบูรณ์ |
| ไม่ต้องใช้เครื่องมือ มีให้ใช้งานโดยตรงบน YouTube | การแก้ไขลบทุกนาทีที่เครื่องมือฟรีประหยัดไว้ |
| , | เนื้อหาหลายชั่วโมงที่มีคำบรรยายอัตโนมัติคุณภาพต่ำอาจใช้เวลาแก้ไขนานกว่าการพิมพ์ใหม่ตั้งแต่ต้น |
ตัวเลือก 2 - วาง URL ของ YouTube โดยตรงลงในเครื่องมือถอดความด้วย AI
เส้นทางที่สะอาดที่สุดสำหรับคนส่วนใหญ่คือการวาง URL ของ YouTube โดยตรงลงในเครื่องมือที่รองรับการนำเข้าลิงก์ เครื่องมือถอดความด้วย AI หลายตัวยอมรับ URL ดิบและส่งคืนบทถอดความพร้อมการประทับเวลาโดยที่คุณไม่ต้องบันทึกไฟล์ใด ๆ ไว้ในเครื่อง Cockatoo รองรับสิ่งนี้จากหน้าจออัปโหลด สำหรับลิงก์ YouTube, Vimeo และ SoundCloud และลิงก์ไฟล์สาธารณะ แผนฟรีไม่ต้องใช้บัตรเครดิตและไม่มีขีดจำกัดรายวัน
สิ่งสำคัญที่ต้องเข้าใจ: การนำเข้าผ่าน URL ขจัดอุปสรรคด้านรูปแบบ แต่ความแม่นยำยังคงขึ้นอยู่กับเอนจินการรู้จำเสียงพูดพื้นฐานของเครื่องมือนั้น ๆ ทั้งหมด ไม่ใช่วิธีการป้อนข้อมูล ซึ่งหมายความว่าคำศัพท์ทางเทคนิค สำเนียงที่หนัก หรือการพูดทับซ้อนกันยังคงทำให้เครื่องมือที่ออกแบบมาดีประสบปัญหาได้ ตัวแก้ไขบทถอดความของ Cockatoo ให้คุณจับและแก้ไขข้อผิดพลาดดังกล่าวได้โดยตรงในแพลตฟอร์ม ดังนั้นขั้นตอนการทำงานจากวิดีโอดิบไปสู่ข้อความที่แม่นยำและใช้งานได้จึงอยู่ในที่เดียว
ตัวเลือก 3 - ดาวน์โหลด MP4 ก่อนเมื่อเครื่องมือของคุณต้องการ
การดาวน์โหลดวิดีโอเป็น MP4 แล้วอัปโหลดไปยังเครื่องมือถอดเสียงด้วย AI ยังคงใช้งานได้ โดยมีประโยชน์ที่สุดเมื่อเครื่องมือไม่รองรับการนำเข้าผ่าน URL หรือเมื่อคุณต้องการสำเนาในเครื่องควบคู่ไปกับข้อความถอดเสียง MP4 ที่ดาวน์โหลดมาซึ่งป้อนเข้าสู่เอนจินเดียวกับ URL ที่วางไว้จะให้ผลลัพธ์ข้อความถอดเสียงเหมือนกัน ดังนั้นหากเครื่องมือของคุณรองรับการนำเข้าผ่าน URL ขั้นตอนการดาวน์โหลดจะเพิ่มความยุ่งยากโดยไม่เพิ่มความแม่นยำ สำหรับการบันทึกสัมภาษณ์ สายสนทนา หรือฟุตเทจการประชุมที่คุณบันทึกไว้ในเครื่องแล้ว การอัปโหลดโดยตรงก็ได้ผลเช่นเดียวกัน การเปลี่ยนเสียงหรือวิดีโอนั้นให้เป็นข้อความที่แม่นยำโดยไม่ต้องพิมพ์ใหม่เลยคือกระบวนการทำงานที่ Cockatoo ถูกสร้างขึ้นมาเพื่อรองรับ
บทความที่เกี่ยวข้อง
- แอปถอดเสียงที่ดีที่สุด
- Descript Vs Otter
- Fireflies Vs Otter
- Trint Vs Rev
- Happy Scribe Vs Rev
- คู่แข่งของ Otter.AI
วิธีตรวจทานและแก้ไขข้อความถอดเสียงที่สร้างโดย AI โดยไม่เสียเวลาหลายชั่วโมง
การบันทึกความยาว 60 นาทีไม่ได้หมายความว่าจะต้องใช้เวลา 60 นาทีในการเก็บกวาด ระบบเสียงด้วย AI สมัยใหม่ทำได้ อัตราคำผิดพลาดที่ 5-10% บนเสียงพูดมาตรฐาน หมายความว่า 90-95% ของข้อความถอดเสียงของคุณถูกต้องอยู่แล้วก่อนที่คุณจะแตะต้องมัน
กฎการเล่นที่ความเร็ว 1.5x สำหรับการตรวจสอบข้อความถอดเสียงอย่างรวดเร็ว
ตรวจทานข้อความถอดเสียงที่สร้างโดย AI ที่ความเร็วการเล่น 1.5x ขณะอ่านตามข้อความ ดวงตาของคุณจับความไม่ตรงกันระหว่างสิ่งที่ได้ยินกับสิ่งที่อ่านได้เร็วกว่าการอ่านซ้ำทีละบรรทัดมาก ด้วยการเล่นที่ความเร็ว 1.5x ผู้ใช้สามารถลดเวลาในการตรวจทานเหลือเพียงเศษเสี้ยวของเวลาที่ต้องอ่านซ้ำทั้งหมด ซึ่งมักเสร็จสิ้นภายในไม่กี่นาทีแทนที่จะใช้เวลาหนึ่งชั่วโมงหรือมากกว่า ตามข้อมูลของ DubSmart (2025) สัญญาณรบกวนพื้นหลังและผู้พูดที่พูดทับกันอาจทำให้อัตราคำผิดพลาดสูงกว่าเกณฑ์พื้นฐานที่ 5-10% มาก ดังนั้นวิธีนี้จึงได้ผลคุ้มค่าที่สุดเมื่อคุณภาพเสียงอยู่ในระดับที่ดี
เมื่อคุณพบข้อผิดพลาดแล้ว ตัวแก้ไขข้อความถอดเสียงในเบราว์เซอร์ของ Cockatoo ช่วยให้คุณแก้ไขได้โดยไม่ต้องสลับแท็บหรือดาวน์โหลดฉบับร่าง สำหรับทีมที่ต้องให้เพื่อนร่วมงานหรือลูกค้าเข้ามามีส่วนร่วม Cockatoo ส่งออกข้อความถอดเสียงที่แก้ไขแล้วโดยตรงไปยัง PDF หรือ DOCX ทำให้อีกฝ่ายได้รับไฟล์ที่สามารถเปิดและแก้ไขได้ใน Word หรือโปรแกรมอ่าน PDF มาตรฐานโดยไม่ต้องมีบัญชี Cockatoo
แก้ชื่อสักครั้ง ไม่ต้องแก้อีกเลย ด้วยคำศัพท์ที่กำหนดเอง
คำศัพท์ที่กำหนดเองช่วยตัดวงจรการแก้ไขคำวิสามานยนามที่ได้ยินผิดซ้ำเดิมในทุกข้อความถอดเสียง การแก้ไขคำศัพท์เพียงครั้งเดียวในเครื่องมือที่จดจำการแก้ไขจะส่งผลให้การแก้ไขนั้นถูกนำไปใช้กับข้อความถอดเสียงในอนาคตทุกไฟล์โดยอัตโนมัติ เครื่องมืออย่าง Sonix มีการปรับแต่งแยกตามภาษา และอัตราคำผิดพลาดแยกตามภาษานั้นแตกต่างกันมากพอที่การแก้ไขคำศัพท์เฉพาะทางจะยิ่งมีคุณค่าทวีคูณมากขึ้นเมื่อทีมทำงานข้ามหลายภาษาหรือสำเนียง
Clean-Verbatim กับ True-Verbatim เลือกสไตล์ของคุณก่อนแก้ไข
Clean-verbatim ตัดคำฟุ่มเฟือยและคำที่เริ่มพูดผิดออกโดยยังคงความหมายไว้ True-verbatim เก็บทุกเสียง การตัดสินใจว่าคุณต้องการสไตล์ใดก่อนเริ่มแก้ไขจะช่วยป้องกันการทำงานซ้ำและทำให้การแก้ไขของคุณสอดคล้องกันตลอดทั้งเอกสาร
หากผลลัพธ์สุดท้ายคือเอกสารที่ผู้อื่นจะแก้ไขหรือนำเสนอ การส่งออกไปยัง DOCX หรือ PDF จาก Cockatoo ในจุดนั้นจะรักษาตัวเลือกการจัดรูปแบบของคุณไว้และส่งมอบไฟล์ที่พร้อมใช้งานได้ทันที ไม่ใช่ข้อความดิบที่ต้องจัดรูปแบบใหม่
คุณสามารถส่งออกข้อความถอดเสียงเป็นไฟล์รูปแบบใดได้บ้าง และรูปแบบใดที่กระบวนการทำงานของคุณต้องการ
Cockatoo สามารถส่งออกข้อความถอดเสียงที่เสร็จแล้วของคุณได้ในเจ็ดรูปแบบ คือ DOCX, PDF, TXT, SRT, VTT, CSV และ JSON และรูปแบบที่เหมาะสมนั้นขึ้นอยู่กับสิ่งที่จะเกิดขึ้นต่อไปในกระบวนการทำงานของคุณทั้งหมด ไฟล์ที่ส่งไปยังกล่องจดหมายของลูกค้ามีข้อกำหนดต่างจากไฟล์ที่มุ่งไปยังตัวอัปโหลดคำบรรยายของ YouTube และการเลือกรูปแบบผิดหมายถึงขั้นตอนการแปลงเพิ่มเติมหรือไฟล์ที่แพลตฟอร์มของคุณไม่ยอมรับเลย สรุปด้านล่างนี้จับคู่แต่ละรูปแบบกับงานเฉพาะที่มันถูกสร้างขึ้นมาเพื่อรองรับ
รูปแบบการส่งออกห้าแบบครอบคลุมกระบวนการทำงานส่วนใหญ่สำหรับข้อความถอดเสียงที่เสร็จแล้ว และการเลือกผิดจะสร้างงานรอบที่สองซึ่งแอบหักลบเวลาที่การถอดเสียงด้วย AI เพิ่งประหยัดไป
1. DOCX - รูปแบบเอกสารที่แก้ไขได้สำหรับผู้ร่วมงานและลูกค้า
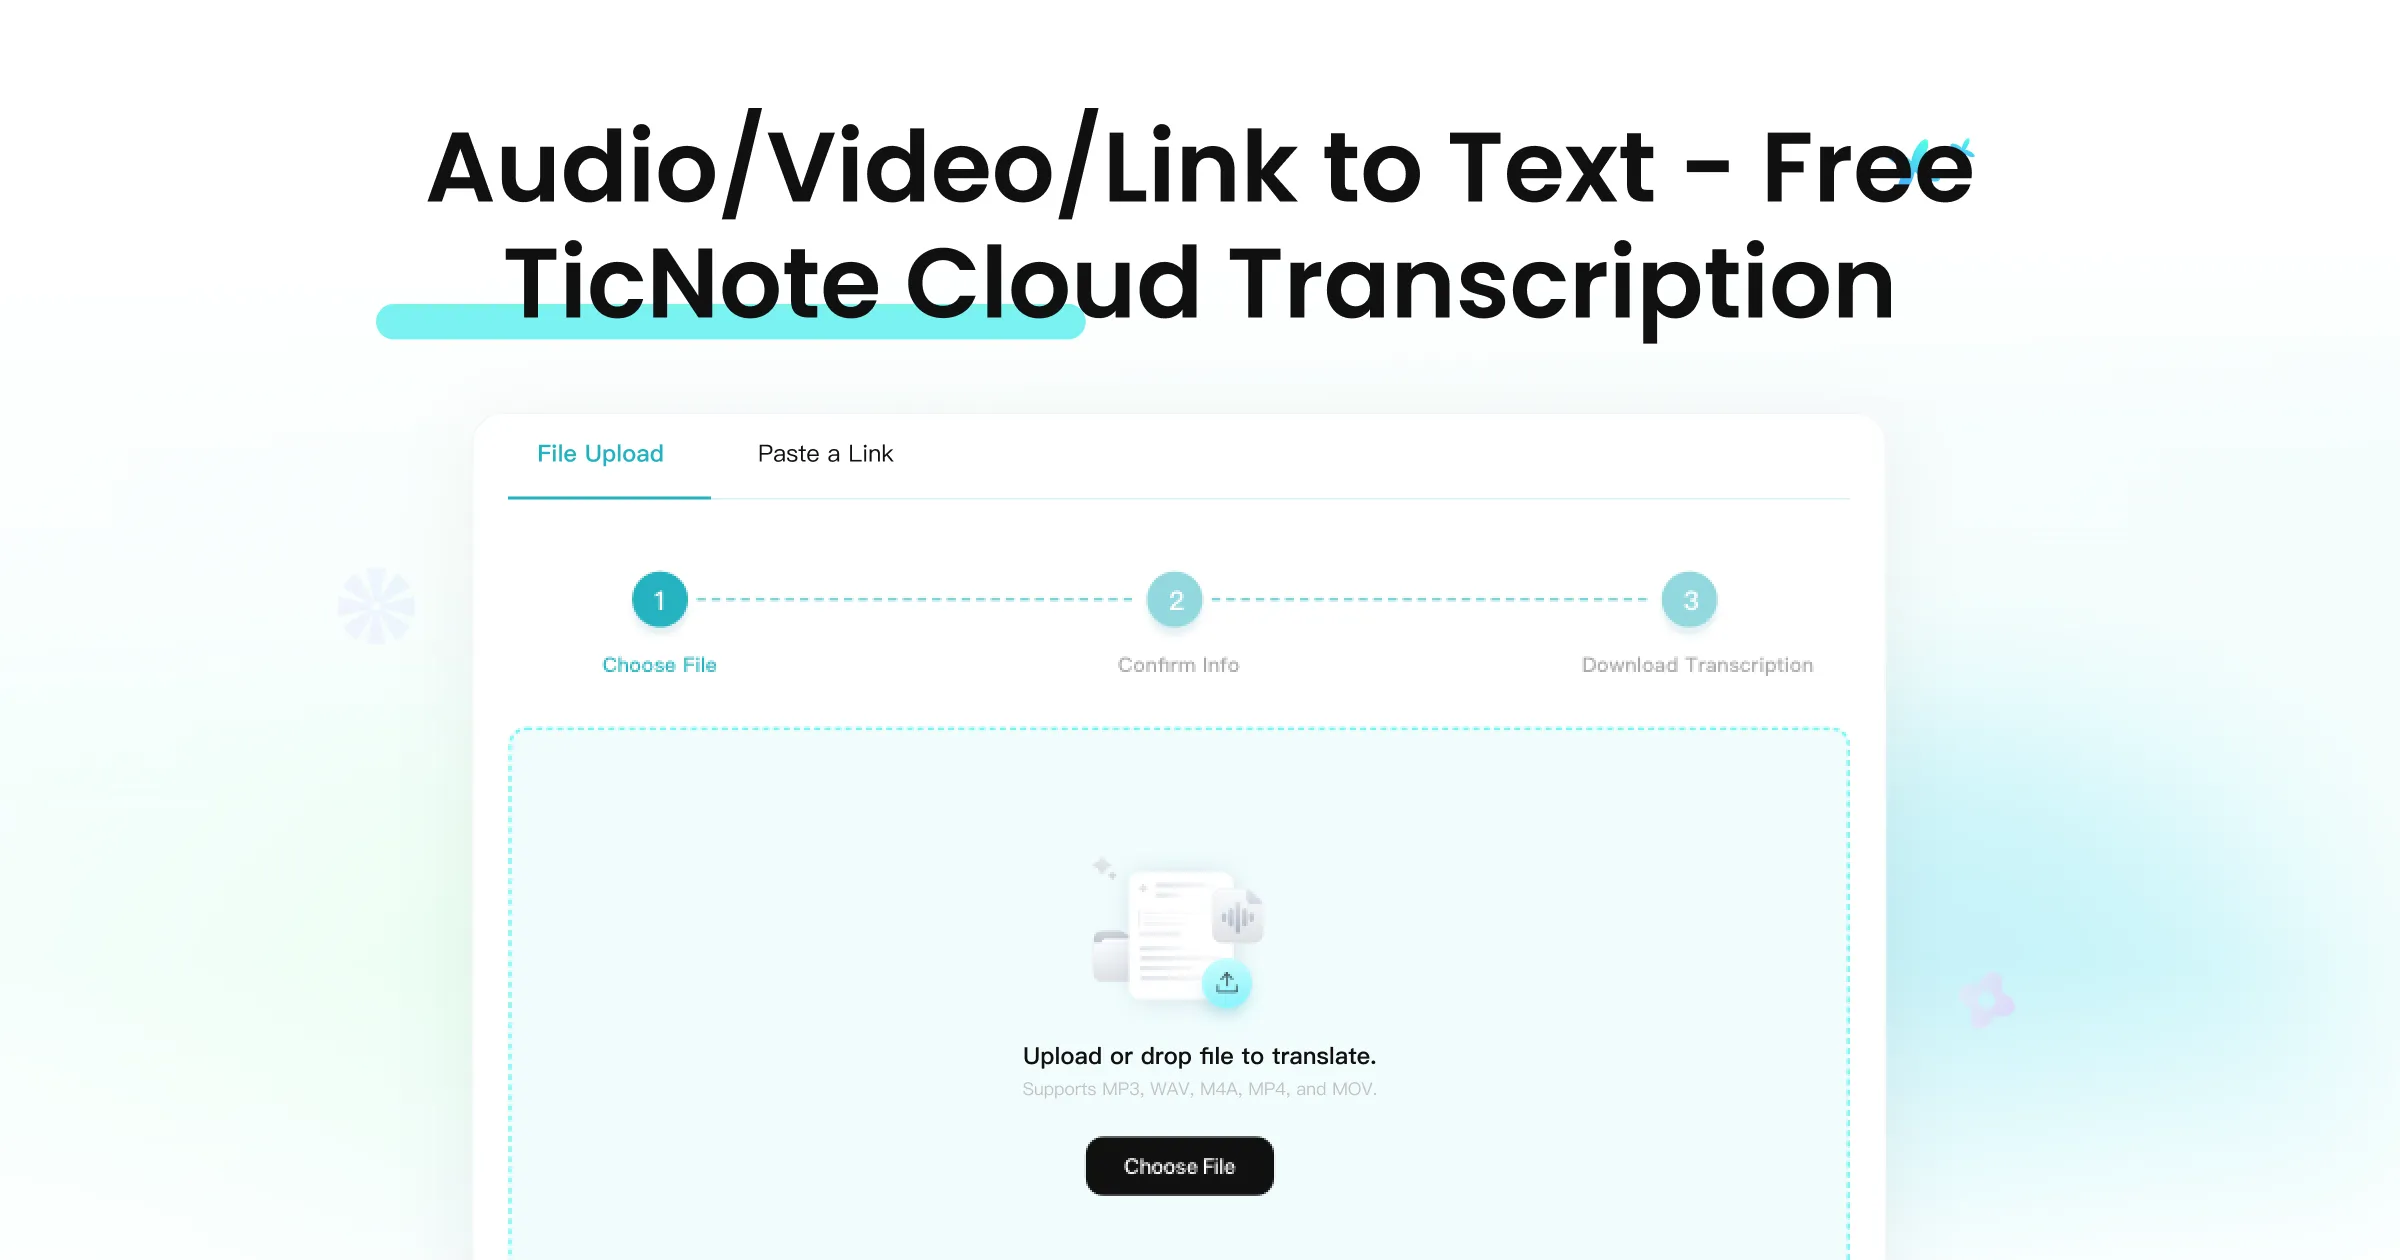
DOCX เป็นตัวเลือกที่เหมาะสมเมื่อเพื่อนร่วมงาน ลูกค้า หรือบรรณาธิการต้องการแก้ไขหรือตรวจแก้บันทึกถอดเสียงใน Word หรือ Google Docs การจัดรูปแบบยังคงอยู่หลังการถ่ายโอน: การแบ่งย่อหน้า ป้ายกำกับผู้พูด และเครื่องหมายวรรคตอนยังคงครบถ้วน ข้อเสียที่แท้จริงเพียงอย่างเดียวคือไฟล์ DOCX ไม่ได้รับการยอมรับจากตัวอัปโหลดคำบรรยายของแพลตฟอร์มวิดีโอใด ๆ ดังนั้นหากการเพิ่มคำบรรยายอยู่ในรายการของคุณด้วย คุณจะต้องส่งออกครั้งที่สอง
2. PDF - รูปแบบเค้าโครงคงที่สำหรับการจัดเก็บ แชร์ และเก็บถาวร
PDF ล็อกเค้าโครงของบันทึกถอดเสียงไว้เพื่อให้ดูเหมือนกันทุกอุปกรณ์และไม่สามารถแก้ไขโดยไม่ตั้งใจได้ เป็นตัวเลือกที่เหมาะสมสำหรับการส่งบันทึกฉบับสุดท้ายให้ลูกค้า จัดเก็บสำเนาทางกฎหมายหรือการปฏิบัติตามข้อกำหนด หรือแชร์สิ่งที่不应ถูกเปลี่ยน ข้อจำกัดก็เหมือนกับ DOCX: PDF ไม่สามารถอัปโหลดเป็นไฟล์คำบรรยายไปยัง YouTube หรือแพลตฟอร์มวิดีโออื่นใดได้
3. SRT - รูปแบบคำบรรยายสากลสำหรับ YouTube และแพลตฟอร์มวิดีโอส่วนใหญ่
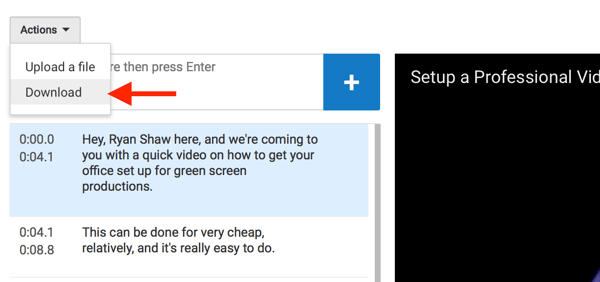
SRT เป็นรูปแบบที่ควรเลือกเมื่อขั้นตอนถัดไปของคุณคือการอัปโหลดคำบรรยายไปยังแพลตฟอร์มวิดีโอ แพลตฟอร์มวิดีโอระดับองค์กรรวมถึง YouTube และ Vimeo ต้องการ SRT หรือรูปแบบคำบรรยายที่มีการจับเวลาเทียบเท่าสำหรับการอัปโหลดคำบรรยายโดยตรง แต่ละบรรทัดมีเวลากำกับ ดังนั้นคำบรรยายจึงซิงค์โดยอัตโนมัติ SRT ไม่มีประโยชน์สำหรับการแก้ไขหรือเก็บถาวร เนื่องจากรหัสเวลาทำให้อ่านข้อความในโปรแกรมประมวลผลคำได้ยาก
4. VTT - รูปแบบคำบรรยายที่ใช้บนเว็บพร้อมการสนับสนุนการจัดรูปแบบสำหรับโปรแกรมเล่น HTML5
VTT (WebVTT) ทำหน้าที่เพิ่มคำบรรยายเช่นเดียวกับ SRT แต่เป็นรูปแบบเฉพาะสำหรับโปรแกรมเล่นวิดีโอ HTML5 ที่ฝังอยู่ในเว็บไซต์ หากวิดีโอของคุณอยู่บนเว็บไซต์ที่กำหนดเองหรือแพลตฟอร์มที่ใช้โปรแกรมเล่น HTML5 แทน YouTube หรือ Vimeo VTT ให้การควบคุมการจัดรูปแบบที่ SRT ไม่มี รวมถึงการจัดตำแหน่งและสีของตัวอักษร สำหรับการอัปโหลดไปยัง YouTube หรือ Vimeo ตามมาตรฐาน SRT และ VTT สามารถใช้แทนกันได้ VTT จะเป็นตัวเลือกที่ชัดเจนก็ต่อเมื่อโปรแกรมเล่นฝังอยู่บนเว็บ
5. TXT - การส่งออกข้อความธรรมดาสำหรับการนำเข้าสู่ไปป์ไลน์และเวิร์กโฟลว์การคัดลอกวาง
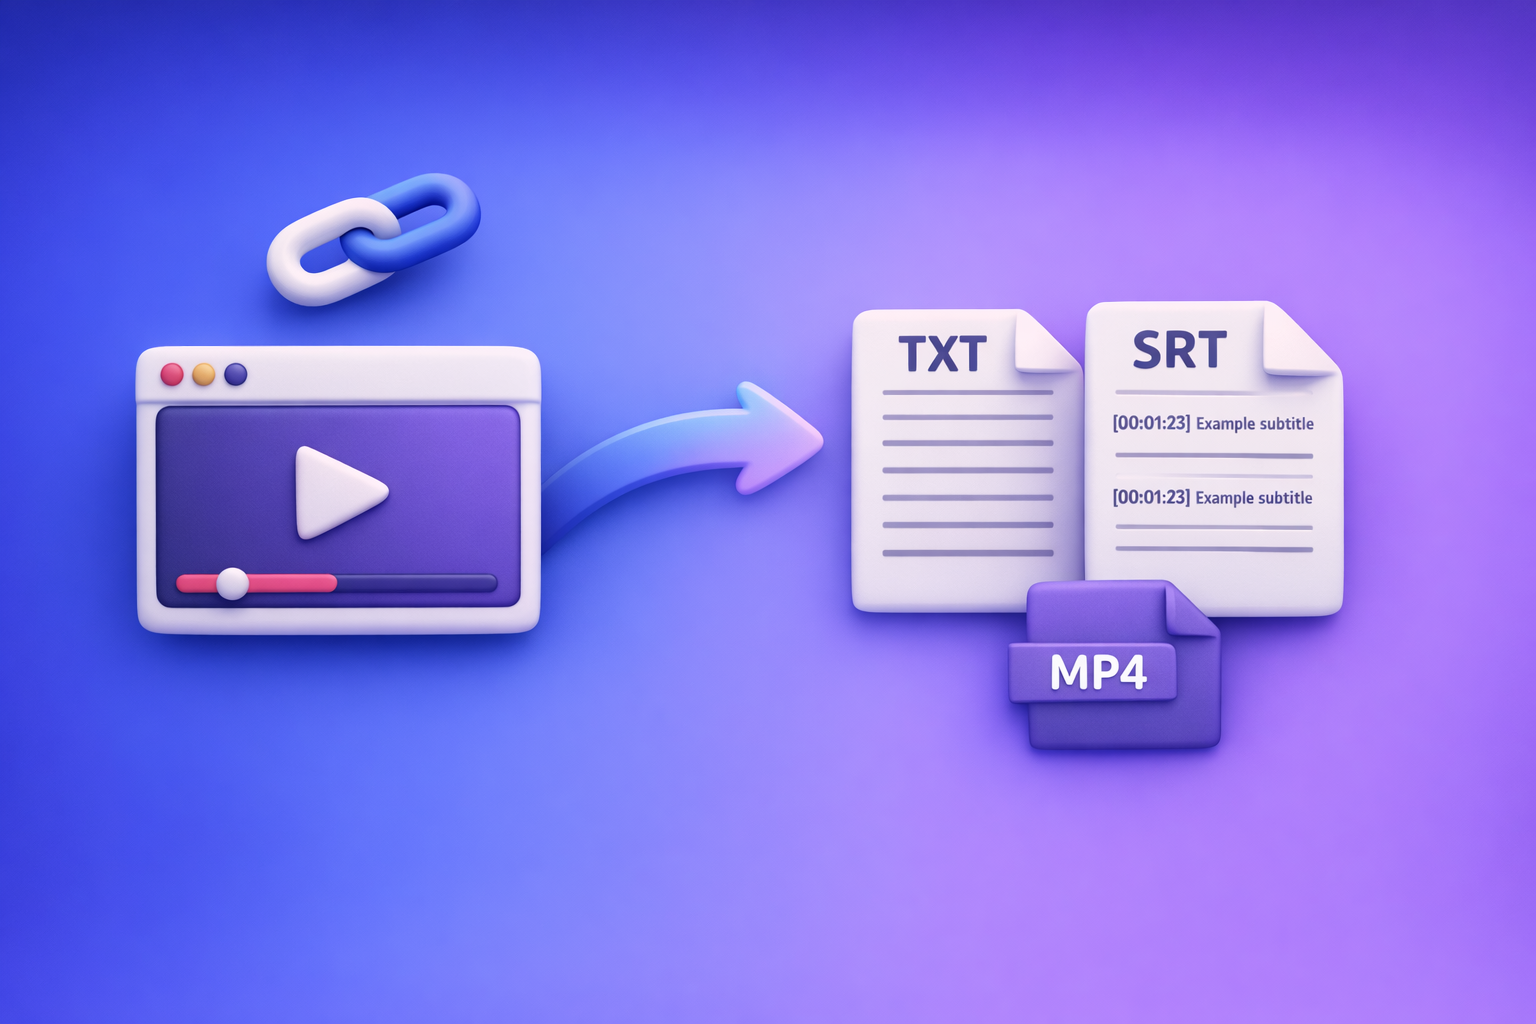
ข้อความธรรมดาจะตัดแท็กการจัดรูปแบบและเวลากำกับทั้งหมดออก เหลือเพียงคำดิบเท่านั้น ทำให้ TXT เป็นเส้นทางที่เร็วที่สุดเมื่อคุณต้องการวางเนื้อหาบันทึกถอดเสียงลงใน CMS โปรแกรมแก้ไขบล็อก เครื่องมือสรุป หรือระบบอื่นใดที่จัดการการจัดรูปแบบของตัวเอง ข้อเสียคือทั้งหมด: ไม่มีป้ายกำกับผู้พูด ไม่มีเวลากำกับ ไม่มีการจัดรูปแบบ ใช้ TXT เฉพาะเมื่อเครื่องมือปลายทางจะจัดรูปแบบเนื้อหาใหม่ให้อยู่แล้ว
ปัญหาที่แท้จริงคือเครื่องมือส่วนใหญ่บังคับให้คุณเปิดแต่ละไฟล์ใหม่เพื่อเปลี่ยนรูปแบบการส่งออก Cockatoo ช่วยให้คุณส่งออกบันทึกถอดเสียงที่เสร็จแล้วฉบับเดียวกันเป็น DOCX, PDF, TXT, SRT, VTT, CSV และ JSON ได้ในทุกแพ็กเกจ รวมถึงแพ็กเกจฟรี ดังนั้นคุณจึงไม่ต้องรันไฟล์ซ้ำเพื่อให้ได้รูปแบบที่ต่างออกไป
เมื่อคุณรู้แล้วว่าขั้นตอนการทำงานของคุณต้องการรูปแบบใด คำถามถัดไปคือบันทึกถอดเสียงในไฟล์นั้นแม่นยำพอที่จะใช้งานได้หรือไม่ โดยเฉพาะอย่างยิ่งหากผู้พูดของคุณมีสำเนียง ใช้ศัพท์ทางเทคนิค หรือบันทึกในภาษาที่ไม่ใช่ภาษาอังกฤษ นั่นคือจุดที่ข้อมูลมาตรฐานเปรียบเทียบที่น่าสนใจจริง ๆ ปรากฏขึ้น
ความแม่นยำของการถอดเสียงด้วย AI ในแต่ละภาษาและสำเนียง - สิ่งที่ข้อมูลมาตรฐานเปรียบเทียบแสดงให้เห็นจริง
การอ้างความแม่นยำของเครื่องมือถอดเสียงเป็นเรื่องแทบจะเป็นไปไม่ได้ที่จะประเมินโดยไม่รู้ว่าทดสอบภาษาใด ภายใต้สภาวะเสียงแบบใด และประสิทธิภาพเปลี่ยนไปอย่างไรกับคำพูดที่มีสำเนียงหรือเป็นบทสนทนา ข้อมูลมาตรฐานเปรียบเทียบที่สำคัญจริง ๆ จะแยกตัวแปรเหล่านี้ออกจากกันแทนที่จะรวมเป็นเปอร์เซ็นต์เดียวที่ดูดี
ทำไม "98% แม่นยำ" จึงเป็นตัวเลขที่ไม่มีความหมาย
คำกล่าวอ้างว่า "98% แม่นยำ" บนหน้า pricing ของเครื่องมือถอดเสียงแทบไม่ได้บอกอะไรที่เป็นประโยชน์เลย มันไม่ได้บอกว่าภาษาไหนที่ถูกทดสอบ เสียงเป็นบันทึกในสตูดิโอที่สะอาดหรือเป็นสายโทรศัพท์ หรือประสิทธิภาพตกต่ำลงมากแค่ไหนกับสำเนียงท้องถิ่น สองเครื่องมืออาจพิมพ์ "98%" ออกมาทั้งคู่ ขณะที่ตัวหนึ่งพังเมื่อเจอภาษาสเปนและอีกตัวยังคงนิ่ง
อัตราความผิดพลาดระดับคำ (word error rate) ในการพูดแบบสนทนาที่มีสำเนียงอาจสูงกว่าตัวเลขเสียงพูดสะอาดที่มักถูกใช้ป้อนคำกล่าวอ้างทางการตลาดอย่างมีนัยสำคัญ และเสียงพูดที่มีสำเนียงคุณภาพระดับโทรศัพท์มักให้ผลลัพธ์ที่แย่ลงไปอีก นั่นคือเสียงที่ครีเอเตอร์ ผู้สัมภาษณ์ และเจ้าของธุรกิจรายย่อยผลิตออกมาจริงเสียส่วนใหญ่
ช่องว่างนี้สะท้อนถึงการเลือกการออกแบบอย่างตั้งใจ โมเดลที่ฝึกมาเพื่อความกว้างขวางหลายภาษามักแลกความแม่นยำเฉพาะแต่ละภาษากับความครอบคลุมของภาษา ซึ่งเป็นการแลกเปลี่ยนที่เปอร์เซ็นต์รวมค่าเดียวปกปิดไว้จนหมดสิ้น มันยากจริง ๆ ที่จะเข้าใจว่าโมเดลดีแค่ไหนจริง ๆ โดยไม่เป็นผู้เชี่ยวชาญในสาขานี้ เพราะคำกล่าวอ้างล้วน ๆ ตีความไม่ได้หากไม่มีข้อมูลแยกตามชุดข้อมูล
การวัดประสิทธิภาพที่น่าเชื่อถือต้องระบุชื่อชุดข้อมูล ภาษา และสภาวะของเสียง แยกเสียงพูดอ่านออกเสียงที่สะอาดออกจากเสียงพูดแบบสนทนา และแสดงอัตราความผิดพลาดระดับคำแยกตามภาษา ไม่ใช่ค่าเฉลี่ยผสมที่ทำให้ข้อมูลนำเข้าที่ดีที่สุดของเครื่องมือดูดีเกินจริง เสียงพูดที่มีสำเนียง คนพูดเร็ว และศัพท์เฉพาะทางทำให้อัตราความผิดพลาดระดับคำในโลกจริงสูงกว่าตัวเลขพาดหัวอยู่บ่อยครั้ง ดังนั้นทรานสคริปต์ที่ดูเกือบสมบูรณ์บน Recording ที่สะอาดอาจต้องเขียนใหม่แทบทั้งหมดบนเสียงที่คนส่วนใหญ่ผลิตจริง นั่นไม่ใช่เหตุผลที่จะหลีกเลี่ยงการถอดเสียงด้วย AI แต่เป็นเหตุผลให้ทดสอบภาษาของคุณและสภาวะเสียงเฉพาะของคุณกับหลักฐานที่เผยแพร่ก่อนตัดสินใจใช้เครื่องมือ
สองเครื่องมือถอดเสียงที่ควรรู้จัก
การเลือกเครื่องมือถอดเสียงโดยไม่ทดสอบกับเสียงของคุณเองคือการเสี่ยงโชค แต่การรู้ว่าเครื่องมือไหนมีผลวัดประสิทธิภาพแยกตามภาษาที่น่าเชื่อถือและเผยแพร่แล้วอย่างน้อยก็ช่วยจำกัดตัวเลือกให้แคบลง สองเครื่องมือด้านล่างนี้น่าพิจารณาไม่ใช่เพราะเป็นตัวเลือกเดียวที่ทำได้ แต่เพราะมีความโปร่งใสเกี่ยวกับสภาวะและความครอบคลุมของภาษามากพอให้คุณประเมินคำกล่าวอ้างได้ แทนที่จะเพียงรับมันไว้เฉย ๆ
ทำไมการถอดเสียงแบบไม่จำกัดอย่างแท้จริงจึงเปลี่ยนการคำนวณสำหรับผู้ใช้เดี่ยว
ทำไม "ไม่จำกัด" มักมีเชิงอรรถ
แผนส่วนใหญ่ที่โฆษณาว่าเป็นการถอดเสียงไม่จำกัดมักจำกัดการใช้งานไว้ที่ประมาณ 720 ชั่วโมงต่อเดือน และโครงสร้างราคายิ่งซ้ำเติมปัญหา โมเดลแบบต่อที่นั่งหมายความว่าคนเดียวที่รับผิดชอบงานถอดเสียงต้องไปหาเหตุผลกับผู้จัดการเพื่อขอไลเซนส์แบบทีม หรือต้องแบกค่าราคาแบบทีมบนบัตรส่วนตัว เพียงเพื่อจะเริ่มต้น ทำให้ผู้ใช้เดี่ยวเหลือตัวเลือกที่ใช้ได้จริงน้อย
หลายคนที่ทำงานนี้อยู่แล้วใช้จ่ายกว่า $240 ต่อปีกระจายไปยังแอปเฉพาะทางหลายตัว ตัวหนึ่งสำหรับถอดเสียง อีกตัวสำหรับบันทึกเสียง อีกตัวสำหรับแปลเอกสาร ก่อนที่วันนี้จะได้ประมวลผลไฟล์แม้แต่ไฟล์เดียว
โหมดไม่จำกัดฟรีเปลี่ยนการคำนวณอย่างไร
Cockatoo ตัดปัจจัยเรื่องปริมาณออกจากการตัดสินใจ แผนฟรีให้ทรานสคริปต์ความยาวเต็มแบบไม่จำกัดใน V4-Flash โดยไม่มีขีดจำกัดรายวัน ดังนั้นปริมาณเสียงที่คุณมีจึงไม่เคยบังคับให้ต้องอัปเกรดด้วยตัวมันเอง
แผนแบบเสียเงิน是关于ความแม่นยำและป้ายกำกับผู้พูด ไม่ใช่ปริมาณ V4-Flash ถอดเสียงได้เร็วถึง 120 เท่าของเวลาจริง V4-Pro โหมดที่แม่นยำที่สุด ทำงานที่ความเร็วประมาณ 20 เท่าของเวลาจริงและติดป้ายกำกับผู้พูดโดยอัตโนมัติ บัญชีฟรีได้รับตัวอย่าง V4-Pro รายสัปดาห์ Pro ประมวลผลบันทึกทั้งไฟล์ใน V4-Pro ด้วยขีดจำกัดการใช้งานที่สูงขึ้น และ Max เริ่มต้นที่ $100 ต่อเดือน ให้โควตา V4-Pro แบบ Pro 5 หรือ 10 เท่าสำหรับงานค้างสะสมจำนวนมาก
แผนฟรีก่อนเทียบกับ Pro ก่อนจ่ายสักดอลลาร์
เริ่มจากแผนฟรีและเปรียบเทียบ V4-Flash กับตัวอย่าง V4-Pro รายสัปดาห์บน Recording ของคุณเอง หากคุณต้องการ V4-Pro ทุกไฟล์ Pro คือหนึ่งคน หนึ่งแผน ไม่ต้องขออนุมัติ ราคาปัจจุบันอยู่ที่หน้า pricing ของ Cockatoo
บทความที่เกี่ยวข้อง
- ทางเลือกแทน Turboscribe
- ทางเลือกแทน Trint
- ทางเลือกแทน Happy Scribe
- ทางเลือกแทน Sonix
- Trint กับ Otter
ขั้นตอนต่อไป
หากไฟล์บันทึกเสียงของคุณทำให้งานทำความสะอาดห้านาทีกลายเป็นเวลาหนึ่งชั่วโมงของการแก้ไข เส้นทางข้างหน้าจะเริ่มต้นจากการตระหนักว่าคำบรรยายอัตโนมัติฟรีคืองานถอดความชิ้นที่สอง ไม่ใช่ทางลัด
การแก้ไขฉบับร่างคำบรรยายอัตโนมัติที่หนาแน่นและเต็มไปด้วยข้อผิดพลาดใช้เวลารวมมากกว่าการเริ่มจากบทถอดความที่มีความแม่นยำสูงกว่าและทำการตรวจแก้บรรณาธิการที่เบากว่า นั่นหมายความว่าขั้นตอนการแก้ไข ไม่ใช่ขั้นตอนการอัปโหลดหรือประมวลผล คือจุดที่เวลาได้รับการประหยัดหรือสูญเสียไปจริง ๆ เครื่องมือที่มีความแม่นยำแท้จริงกับเสียงในโลกจริงจะย่อกระบวนการตรวจทานนั้นจากเซสชันแก้ไขที่ใช้เวลาหลายชั่วโมงให้เหลือเพียงไม่กี่นาที เมื่อนำสองข้อเท็จจริงนี้มารวมกันก็ชี้ไปที่ก้าวต่อไปที่ชัดเจนเพียงหนึ่งเดียว: นำไฟล์ของคุณผ่านเครื่องมือที่สร้างขึ้นสำหรับเสียงที่คุณผลิตจริง ไม่ใช่เสียงพูดในสตูดิโอที่สะอาดซึ่งตัวเลขความแม่นยำในพาดหัวสมมติขึ้น
เริ่มต้นด้วยซอฟต์แวร์ถอดความของ Cockatoo บนแผนฟรี วางไฟล์หรือวาง URL ของ YouTube แล้วบทถอดความที่มีเครื่องหมายวรรคตอนและประทับเวลาาจะส่งกลับมาภายในไม่กี่นาที ไม่ต้องใช้บัตรเครดิต ไม่ต้องตั้งค่า และไม่มีขีดจำกัดรายวัน พร้อมรูปแบบการส่งออกทุกรูปแบบ ป้ายกำกับผู้พูดมีมาให้กับ V4-Pro ซึ่งคุณสามารถดูตัวอย่างได้ฟรีทุกสัปดาห์
คำถามที่พบบ่อย
ฉันสามารถถอดความวิดีโอ YouTube โดยไม่ต้องดาวน์โหลดก่อนได้หรือไม่
ได้ คุณสามารถวางลิงก์ YouTube ลงในพื้นที่อัปโหลดของ Cockatoo โดยตรงแทนการดาวน์โหลดไฟล์ YouTube ยังมีเครื่องมือถอดความในตัว เปิดวิดีโอ คลิกเมนูสามจุดใต้เครื่องเล่น แล้วเลือก "Open transcript" แต่คำบรรยายที่สร้างอัตโนมัติมักมีปัญหากับสำเนียง คำศัพท์เฉพาะทาง และเสียงพูดที่ทับซ้อนกัน ทำให้เป็นเพียงจุดเริ่มต้นมากกว่าผลิตภัณฑ์ที่เสร็จสมบูรณ์
เครื่องมือถอดความติดป้ายกำกับว่าใครเป็นผู้พูดหรือไม่ หรือฉันต้องแยกแยะเอง
Cockatoo ติดป้ายกำกับผู้พูดโดยอัตโนมัติใน V4-Pro โหมดที่แม่นยำที่สุด โดยไม่ต้องมีขั้นตอนแยกต่างหาก V4-Pro ทำงานกับไฟล์บันทึกเสียงทั้งหมดบนแผนแบบชำระเงินและในการดูตัวอย่างรายสัปดาห์บนแผนฟรี เมื่อเสียงสองเสียงทับซ้อนกันหรือฟังดูคล้ายกันมาก ให้ตรวจสอบช่วงนั้นอย่างรวดเร็วในตัวแก้ไข
ใช้เวลานานเท่าใดจริง ๆ ในการได้บทถอดความกลับมา
การถอดความด้วย AI ส่งฉบับร่างที่ใช้งานได้ภายในไม่กี่นาที สำหรับบทสัมภาษณ์ความยาว 60 นาที บทถอดความที่มีเครื่องหมายวรรคตอนมักพร้อมก่อนคุณดื่มกาแฟเสร็จ การถอดความด้วยมือของไฟล์บันทึกเสียงความยาวหนึ่งชั่วโมงเดียวกันจะใช้เวลาส่วนใหญ่ของวันทำงาน และบริการถอดความโดยมนุษย์ใช้เวลา 24-48 ชั่วโมงสำหรับคำสั่งซื้อมาตรฐาน
ไฟล์วิดีโอของฉันถูกเก็บเป็นส่วนตัวหรือไม่ หรือถูกจัดเก็บไว้ที่ที่ฉันควบคุมไม่ได้
การถอดความบนคลาวด์จำเป็นต้องให้เสียงของคุณออกจากอุปกรณ์ ซึ่งเป็นความกังวลจริงสำหรับไฟล์บันทึกเสียงที่ละเอียดอ่อน Cockatoo จัดเก็บและประมวลผลไฟล์ที่อัปโหลดในสหรัฐอเมริกาและสหภาพยุโรป (ฟินแลนด์) หน้าความปลอดภัย อธิบายวิธีจัดการไฟล์
ไฟล์ SRT แตกต่างจากบทถอดความข้อความธรรมดาอย่างไร และสำคัญหรือไม่ว่าฉันส่งออกแบบไหน
ไฟล์ TXT ธรรมดาคือข้อความที่ไม่มีรูปแบบ มีประโยชน์สำหรับการวางลงในเอกสารหรือป้อนเข้าสู่เครื่องมืออื่น ไฟล์ SRT จับคู่แต่ละบรรทัดของบทสนทนากับการประทับเวลา เพื่อให้แพลตฟอร์มวิดีโออย่าง YouTube หรือ Vimeo รู้ว่าต้องแสดงเป็นคำบรรยายเมื่อใด การเลือกผิดรูปแบบเมื่อสิ้นสุดเซสชันการตรวจทานหมายถึงต้องเริ่มขั้นตอนการส่งออกใหม่ ดังนั้นจึงควรตัดสินใจโดยพิจารณาจากสิ่งที่จะเกิดขึ้นต่อไปก่อนที่คุณจะส่งออก






