Wskaźniki dokładności transkrypcji wprowadzają Cię w błąd w 2026
Dostawcy publikują wskaźniki dokładności bez ujawniania, co mierzyli. Oto, co WER faktycznie oblicza, dlaczego testy porównawcze na czystym dźwięku schlebiają każdemu narzędziu i ile kosztuje Cię ta nagłówkowa liczba na prawdziwym nagraniu.
Powszechne założenie jest takie, że jeśli narzędzie reklamuje wysoki wskaźnik dokładności, wynik powinien być wystarczająco niezawodny, by używać go z tylko drobnymi poprawkami; nagłówkowa liczba jest istotnym sygnałem jakości. Twierdzenia dostawców o dokładności są wszędzie. Żadne z nich nie mówi Ci, co liczba faktycznie zmierzyła ani czy ten pomiar ma cokolwiek wspólnego z Twoim nagraniem.
Podstawowy problem jest definicyjny. Ta sama metryka, mierzona w różnych warunkach, daje skrajnie różne wyniki, a żadna reguła nie wymaga od dostawców ujawnienia, jakich warunków użyli.
Zobacz nasze oprogramowanie do transkrypcji, aby dowiedzieć się, jak to działa w praktyce.
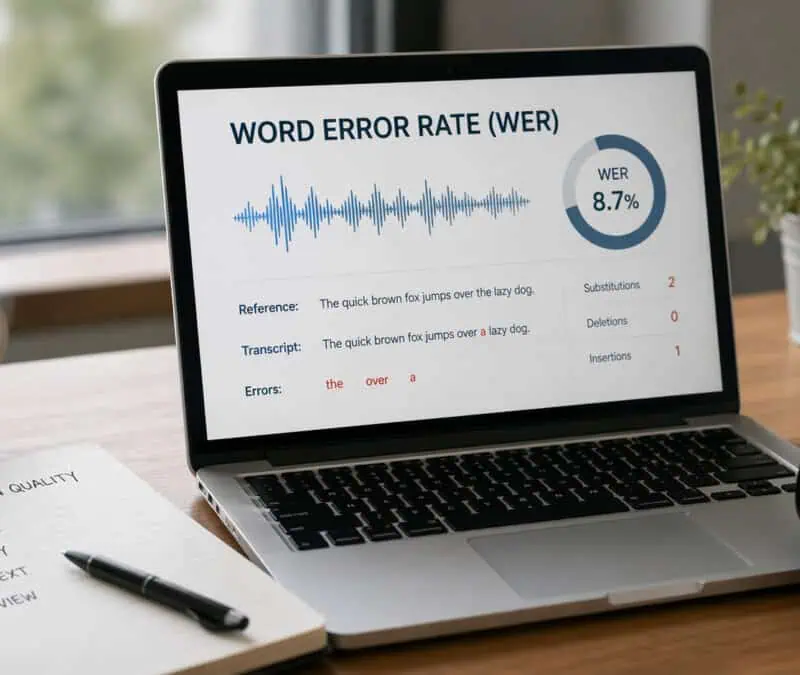
Word Error Rate (WER) to standardowa metryka stojąca za każdą liczbą dokładności w branży transkrypcji. Zgodnie z artykułem o e-WER 2018 Association for Computational Linguistics, WER oblicza się, licząc podstawienia, usunięcia i wstawienia w stosunku do całkowitej liczby słów w transkrypcie referencyjnym. Nowoczesne systemy AI mogą osiągnąć od 2 do 5 procent WER na czystym dźwięku jakości studyjnej, co przekłada się na od 95 do 98 procent dokładności. Haczyk kryje się w „czystym, jakości studyjnej”: pojedynczy mówca, blisko mikrofonu, niski szum tła, kontrolowane środowisko. Większość osób transkrybujących prawdziwy wywiad, rozmowę z klientem lub nagrane spotkanie nie pracuje w takich warunkach.
Te same badania ACL jasno pokazują, że WER wymaga transkryptu referencyjnego, a dostawcy wybierają, które audio ten transkrypt tworzy. Dostawca może uruchomić swój model na czystym nagraniu studyjnym z jednym mówcą, zgłosić 2 procent WER i opublikować na swojej stronie głównej „98% dokładności”. Ta liczba nie jest fałszywa.
Mierzy coś, co nie ma nic wspólnego z Twoją hałaśliwą salą konferencyjną ani regionalnym akcentem Twojego rozmówcy. Dwaj dostawcy mogą obaj twierdzić, że mają wysoką dokładność, podczas gdy ich narzędzia działają zupełnie inaczej na prawdziwym dźwięku, ponieważ porównywali je w zupełnie innych warunkach. Nie ma obowiązku ujawniania typu audio, profilu mówcy, poziomu szumu ani domeny.
Żaden ogólnobranżowy standard nie reguluje, jak dokładność transkrypcji musi być mierzona ani raportowana. Ponieważ WER jest obliczany względem wybranego transkryptu referencyjnego w wybranych warunkach, pojedynczej nagłówkowej liczby podanej bez ujawnienia metodyki nie można sensownie interpretować jako sygnału jakości dla rzeczywistego użycia. Jedyna liczba warta zaufania to taka, która została porównana na prawdziwym dźwięku i opublikowana dla każdego języka, abyś mógł sprawdzić ją względem własnego typu nagrania, zanim podejmiesz decyzję.
Najważniejsze wnioski
- „99% dokładne” to twierdzenie marketingowe, a nie pomiar; dostawcy prawie nigdy nie ujawniają, na jakim dźwięku testowali, co czyni tę liczbę niemożliwą do zweryfikowania lub zaufania.
- Współczynnik błędów słów jest domyślnie obliczany na czystej, studyjnie nagranej mowie, co oznacza, że każda nagłówkowa liczba dostawcy jest porównywana w warunkach, które nie mają nic wspólnego z prawdziwym wywiadem, spotkaniem czy nagraniem terenowym.
- Akcenty, szum tła, wielu mówców i słownictwo specyficzne dla danej dziedziny nie są przypadkami skrajnymi, są domyślną rzeczywistością większości prac transkrypcyjnych i to właśnie wykluczają benchmarki dostawców.
- Wymagania dotyczące dokładności nie są jednolitym progiem: współczynnik 95%, który sprawdza się w osobistej notatce głosowej, byłby katastrofalnie niewystarczający dla transkrypcji prawnej, medycznej lub zgodnościowej.
- Transkrypcja AI na czystym, jednomówcowym dźwięku zbliża się obecnie do dokładności na poziomie ludzkim; luka gwałtownie się powiększa w momencie pogorszenia jakości dźwięku, i wtedy właśnie wybór między AI a człowiekiem naprawdę ma znaczenie.
- Najskuteczniejsza poprawa dokładności następuje przed naciśnięciem przycisku nagrywania: umiejscowienie mikrofonu i akustyka pomieszczenia dają każdemu silnikowi transkrypcji lepszy sygnał, niż kiedykolwiek może to zrobić postprocessing.
- Jedyny benchmark wart zaufania podaje nazwę zestawu testowego, określa język i akcent oraz pozwala odtworzyć go na własnym dźwięku; każde twierdzenie, które nie spełnia tego warunku, należy zignorować.
- Cockatoo pozwala samodzielnie przeprowadzić ten test w rzeczywistych warunkach: prześlij własny dźwięk lub wideo, szybko otrzymaj transkrypcję AI i zweryfikuj dokładność na nagraniach, które naprawdę musisz przetworzyć – bez rozmowy sprzedażowej, bez przygotowanego pliku demonstracyjnego.
Jak obliczany jest współczynnik błędów słów i dlaczego benchmarki czystego dźwięku schlebiają każdemu dostawcy
Ta liczba pochodzi bezpośrednio ze wzoru Word Error Rate, a gdy zobaczysz arytmetykę, różnica między nagłówkową liczbą dostawcy a twoją rzeczywistą transkrypcją staje się niemożliwa do zignorowania.
Rozszyfrowany wzór WER - ile naprawdę kosztują cię podstawienia, usunięcia i wstawienia
Word Error Rate oblicza się jako (S + D + I) / N, gdzie S liczy podstawione słowa, D liczy usunięte słowa, I liczy wstawione słowa, a N to całkowita liczba słów w transkrypcji referencyjnej. Każdy typ błędu ma we wzorze równą wagę, więc pominięte słowo kosztuje dokładnie tyle samo, co błędne.
WER na poziomie 5% nie oznacza jednego błędu co równo 20 słów. Oznacza pięć błędów gdzieś w każdych 100 słowach, gromadzących się wokół mowy z akcentem, nakładających się głosów i terminów specyficznych dla danej dziedziny, a te skupiska zwykle trafiają dokładnie tam, gdzie znaczenie jest najbardziej skoncentrowane.
Dlaczego nowoczesna AI osiąga WER na poziomie 2 do 5 procent na czystym dźwięku i jak naprawdę brzmi takie nagranie
Nowoczesne systemy rozpoznawania mowy osiągają WER już od 2 do 5% na czystym dźwięku o jakości studyjnej, w benchmarkach wymagających nagrań jednomówcowych, z niskim szumem, blisko mikrofonu. Te liczby pochodzą z zbiorów danych takich jak LibriSpeech: jeden mówca, profesjonalny mikrofon, brak szumu tła, brak przerw, brak różnorodności akcentów, brak przełączania kodów. Jak zauważa glosariusz Allmaz dotyczący Word Error Rate, większość silników ogólnego przeznaczenia nie jest trenowana na rzeczywistych wzorcach konwersacyjnych, co oznacza, że nagłówkowe liczby pochodzące z czystego, dziedzinowego dźwięku nie przewidują wydajności na nagraniach, które większość użytkowników faktycznie tworzy.
95 procent dokładności oznacza już 25 błędnych słów na transkrypcję 500 słów, zanim rzeczywisty dźwięk pogorszy sprawę
25
Błędne słowa w transkrypcji 500 słów przy dokładności 95%
Transkrypcja spotkania 500 słów zawiera około 25 błędów przy dokładności 95%, co wystarcza, by błędnie nazwać klienta, zniekształcić liczbę lub całkowicie pominąć kluczowe działanie. Na rzeczywistych nagraniach z szumem tła, akcentami lub wieloma mówcami dokładność rutynowo spada do zakresu 85 do 92%. Przy 85% ta sama transkrypcja zawiera 75 błędów: to nie transkrypcja do edycji, ale do przepisania.
Taka skala korekty wymaga przepływu pracy opartego na łatwym eksporcie i przekazywaniu. Eksporty DOCX i PDF w Cockatoo istnieją właśnie w tym celu; osoba, która nagrała spotkanie, nie musi być tą samą osobą, która poprawia transkrypcję. Konta darmowe otrzymują nieograniczone transkrypcje pełnej długości w V4-Flash, bez dziennego limitu, oraz w każdym formacie eksportu: DOCX, PDF, TXT, SRT, VTT, CSV i JSON.
Czynniki, które w rzeczywistości niszczą dokładność transkrypcji na prawdziwych nagraniach
Prawdziwe nagrania psują narzędzia do transkrypcji w sposób, którego nigdy nie ujawniają benchmarki producentów. Warunki, które zawyżają wskaźniki błędów, nie są przypadkami skrajnymi; to domyślna rzeczywistość dla każdego, kto transkrybuje wywiad, nagranie rozmowy lub dyskusję panelową. Zrozumienie, które zmienne wywołują załamanie dokładności, to różnica między pewnym przesłaniem pliku a spędzeniem dwóch godzin na poprawianiu transkrypcji, która wróciła niemal jako bełkot.
1. Szum tła, pogłos pomieszczenia i złe ustawienie mikrofonu - Cztery zmienne nagraniowe, których nigdy nie testują benchmarki
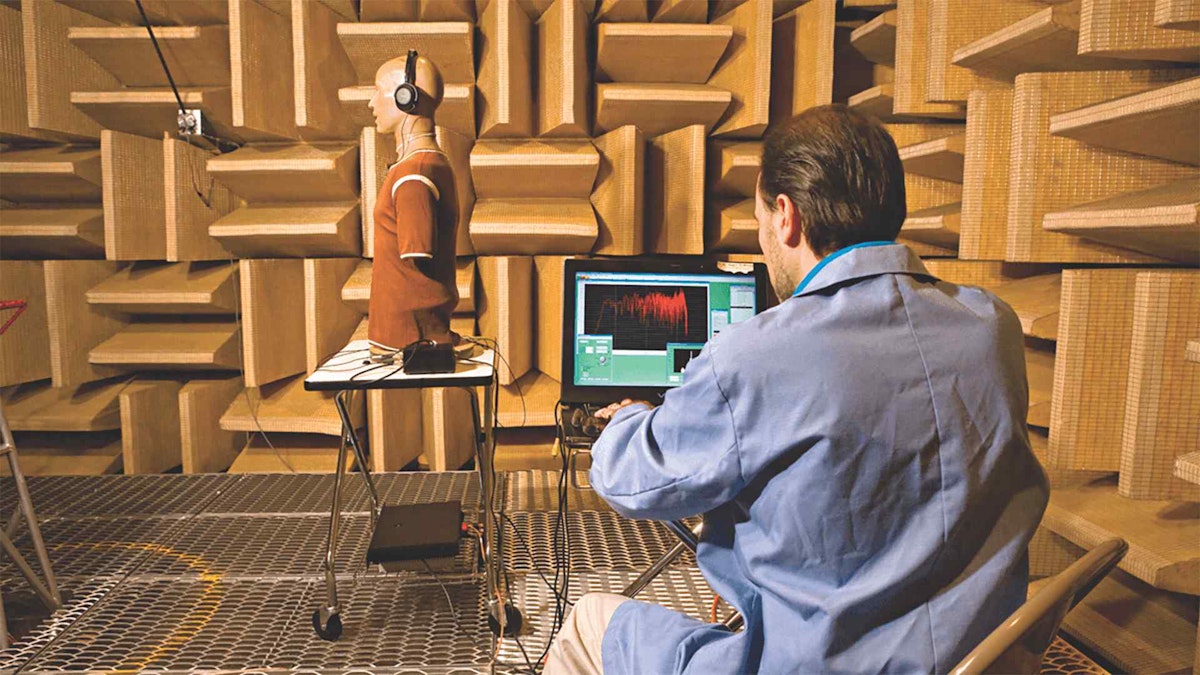
Stosunek sygnału do szumu jest pojedynczym najsilniejszym predyktorem dokładności transkrypcji i załamuje się szybko. Badania opublikowane w Speech Communication pokazują, że wskaźnik błędów słów może wzrosnąć z poniżej 5% na czystym dźwięku do powyżej 30%, gdy stosunek sygnału do szumu spada poniżej 10 dB, poziomu opisującego zwykłe biuro z pracującą klimatyzacją lub rozmowę telefoniczną prowadzoną w kuchni. Pogłos pomieszczenia dodatkowo to pogłębia: odbite dźwięki rozmywają spółgłoski, a model otrzymuje dwie kopie każdego fonemu w nieco różnych momentach, powodując błędy pominięć, których żadne przetwarzanie końcowe nie jest w stanie w pełni naprawić.
Ustawienie mikrofonu to zmienna, którą większość ludzi nie docenia. Mikrofon laptopa nagrywający mówcę z odległości dwóch metrów w niezaadaptowanym pomieszczeniu to zasadniczo inna klasa sygnału niż bliskie, bezechowe sygnały wejściowe używane w benchmarkach.
To tutaj wybór trybu ma znaczenie w praktyce. Cockatoo ma dwa tryby transkrypcji. V4-Flash transkrybuje z prędkością do 120x czasu rzeczywistego i jest darmowy oraz nieograniczony. V4-Pro to najdokładniejszy tryb, działa z prędkością około 20x czasu rzeczywistego i dodaje etykiety mówców. Konta darmowe otrzymują cotygodniowe podglądy V4-Pro, więc możesz porównać oba tryby na nagraniu wykonanym we własnym pomieszczeniu, zanim zdecydujesz, którego potrzebuje Twoje audio.
Pro przetwarza całe nagrania w V4-Pro, z wyższymi limitami użycia i priorytetowym przetwarzaniem. Aktualne plany są na stronie z cenami.
2. Akcenty nienative i regionalne zróżnicowanie dialektalne - Dlaczego błędy substytucji nasilają się poza korpusami akcentów większościowych

Dokładność transkrypcji mowy w języku angielskim u osób nienative różni się zasadniczo od nagłówkowej wartości. Badania branżowe wykazały, że pięć wiodących systemów ASR generowało wskaźniki błędów dla mówiących afroamerykańską odmianą angielskiego dwa razy wyższe niż dla mówiących białą amerykańską odmianą angielskiego, a dysproporcje związane z akcentem u osób nienative są jeszcze większe. Mechanizm awarii to błędy substytucji: słowa, które brzmią prawdopodobnie w kontekście, ale są błędne, więc przechodzą pobieżną lekturę i po cichu psują zapis.
Badania branżowe wykazały, że pięć wiodących systemów ASR generowało wskaźniki błędów dla mówiących afroamerykańską odmianą angielskiego dwa razy wyższe niż dla mówiących białą amerykańską odmianą angielskiego, a dysproporcje związane z akcentem u osób nienative są jeszcze większe.
Wywiad nagrany w kawiarni z dwoma osobami mówiącymi po angielsku jako nienative zwykle zwróci dokładność w wysokich 70. od narzędzia reklamującego 99%. Ta luka jest strukturalną konsekwencją korpusów treningowych obciążonych mową w akcencie większościowym, nagrywaną studyjnie. Cockatoo transkrybuje 36 języków, a jego wskaźniki błędów V4-Pro dla poszczególnych języków, na FLEURS i na nagraniach z rzeczywistego świata, są publikowane na jego stronie z benchmarkami, właściwym miejscu, by sprawdzić swój język przed zleceniem transkrypcji specjalistycznego nagrania.
Gdy masz już w ręku dokładny transkrypt, wprowadzenie go do formatu, który współpracownik może faktycznie otworzyć i edytować, jest kolejnym punktem tarcia. Cockatoo eksportuje bezpośrednio do PDF i DOCX, więc transkrypt trafia jako plik Word lub PDF, który ktoś inny może edytować bez żadnego kroku konwersji — szczegół, który brzmi błaho, dopóki nie spróbujesz wyodrębnić pliku tekstowego do sformatowanego dokumentu w terminie.
3. Wskaźnik błędu diaryzacji mówców (DER) - Ukryta warstwa dokładności, której dostawcy prawie nigdy nie publikują
Wskaźnik błędu diaryzacji (DER) mierzy, jak dokładnie system przypisuje każde słowo do właściwego mówcy. Oblicza się go jako sumę pominiętej mowy, fałszywych alarmów i pomylenia mówców, podzieloną przez całkowity referencyjny czas mowy. Branżowe benchmarki na nagraniach spotkań z wieloma mówcami ze źródeł takich jak ewaluacje NIST Rich Transcription pokazują wartości DER na poziomie 15-30% w przypadku nakładającej się mowy lub dźwięku o jakości telefonicznej, co oznacza, że w panelu czteroosobowym nawet trzy słowa na dziesięć mogą zostać przypisane do niewłaściwego mówcy.
Dostawcy prawie nigdy nie publikują DER obok WER. W rezultacie transkrypt może wyglądać na dokładny pod względem pojedynczych słów, ale być strukturalnie bezużyteczny: zdania podzielone w połowie myśli między niewłaściwych mówców, zadania przypisane niewłaściwej osobie i obowiązek oczyszczania, który badacze zajmujący się jakościowymi wywiadami konsekwentnie opisują jako gorszy niż przepisywanie od zera.
4. Nieliniowy spadek jakości dźwięku - Dlaczego dokładność nie pogarsza się płynnie i niektóre pliki wymagają pełnego przepisania
Dokładność nie spada płynnie w miarę pogarszania się warunków. Utrzymuje się, a potem załamuje.
Badania nad odpornością ASR pokazują efekt progowy: modele utrzymują dokładność bliską benchmarkowej, dopóki degradacja sygnału nie przekroczy punktu krytycznego, w którym model akustyczny traci grunt i wskaźnik błędów gwałtownie rośnie, zamiast rosnąć proporcjonalnie do dodanego szumu. Praktyczną konsekwencją jest to, że plik, który dla ludzkiego ucha brzmi „trochę chropowato”, może znajdować się tuż za tym progiem, zwracając transkrypt wymagający pełnego przepisania, a nie lekkiej edycji. Większość samodzielnych transkrybentów odkrywa to dopiero po przesłaniu pliku, oczekiwaniu i otwarciu wyniku.
Plan Pro w Cockatoo obsługuje nieograniczoną długość pliku, więc wielogodzinne pliki są przesyłane w całości. Prześlij dowolny plik audio lub wideo i otrzymaj edytowalny transkrypt. W V4-Pro mówcy są wykrywani automatycznie, a zmiana nazwy mówcy w edytorze aktualizuje każdą linię.

Transkrypty zawierają znaczniki czasu na poziomie słów i automatyczną interpunkcję. Dowody dokładności znajdują się na opublikowanej stronie benchmarków (wyniki FLEURS dla poszczególnych języków i wyniki rzeczywiste dla 36 języków, wraz z metodą), a nie jako goły procent.
Nieograniczona długość pliku ma tutaj znaczenie, ponieważ dłuższe nagrania, które statystycznie częściej zawierają zmienne warunki akustyczne, są plikami najbardziej narażonymi na osiągnięcie punktu nieliniowego załamania w połowie. Możliwość przesłania bez obcinania pliku oznacza, że model widzi pełny kontekst, a nie przyciętą wersję, która może zaczynać się lub kończyć w połowie zdania.
5. Nakładająca się mowa i przesłuch - Jak jednoczesne głosy niszczą integralność sygnału u źródła

Kiedy dwie osoby mówią jednocześnie, problem nie polega na ograniczeniu oprogramowania. To problem fizyki. Mikrofon odbiera pojedynczy zmiksowany przebieg i żaden model nie potrafi idealnie rozdzielić dwóch głosów zajmujących tę samą przestrzeń częstotliwości w tym samym momencie. Nagranie panelu z czterema nakładającymi się głosami, w którym diaryzacja dzieli zdania w połowie myśli między niewłaściwych mówców, zawodzi, ponieważ integralność sygnału została zniszczona u źródła.
Przesłuch w nagraniach rozmów i wideokonferencjach jest szczególnie szkodliwy, ponieważ kodeki kompresji stosowane w tych procesach dodatkowo pogarszają nakładające się segmenty, pozostawiając model z już zdegradowanym sygnałem wejściowym, zanim czynniki wpływające na dokładność transkrypcji w ogóle wejdą w grę.
W przypadku nagrań wideo z nakładającą się mową potrzeba końcowa to często opublikowany plik z napisami lub podtytułami, a nie transkrypcja do edycji. Cockatoo eksportuje pliki z podtytułami w formatach SRT i VTT w każdym planie, obok DOCX, PDF, TXT, CSV i JSON, a eksport zbiorczy jest dostępny w planie Pro, więc skorygowany wynik można dostarczyć bezpośrednio do wideo bez konieczności osobnej konwersji.
6. Słownictwo specyficzne dla dziedziny i żargon techniczny - Luka leksykalna, która zawyża współczynnik błędów słów w nagraniach specjalistycznych
Modele ASR ogólnego przeznaczenia są optymalizowane pod codzienne słownictwo i mają trudności z terminologią medyczną, prawniczą, naukową lub branżową. Gdy mówca używa żargonu dziedzinowego, model podstawia najbliższe fonetycznie podobne słowo potoczne, generując błędy, które trudniej wychwycić podczas przeglądu, ponieważ brzmią wiarygodnie. Dla profesjonalistów transkrybujących treści specjalistyczne ta luka leksykalna jest stałym i niedostatecznie raportowanym czynnikiem utraty dokładności transkrypcji, który wyniki WER dla czystego dźwięku całkowicie maskują.
Jak naprawdę wygląda dobra dokładność transkrypcji w różnych przypadkach użycia
Wymagania dotyczące dokładności nie są jednym progiem. Próg, przy którym osobista notatka głosowa jest doskonale użyteczna, doprowadziłby do zwolnienia inspektora ds. zgodności. Poziom dokładności, który narzędzie do transkrypcji musi faktycznie zapewnić, skaluje się wraz z tym, jak katastrofalnie pojedyncze błędne słowo może kaskadowo wpłynąć na dalsze procesy, więc nagłówna liczba podawana przez dostawcę jest dla niektórych użytkowników wręcz myląca.
Jedna niedoceniana pułapka: standardowe metryki Word Error Rate mogą kłamać przez pominięcie. Narzędzie, które po cichu pomija nakładającą się mowę, przeskakując mówców nakładających się zamiast próbować ich transkrybować, wykaże niższy WER niż narzędzie, które próbuje i czasami przekręca te wymiany. Pierwsze narzędzie wygląda na dokładniejsze na papierze, dostarczając mniej z twojego faktycznego spotkania.
1. Dokładność 80-90% - Akceptowalny dolny próg dla notatek swobodnych i osobistego dyktowania
Notatki swobodne i osobiste dyktowanie tolerują dokładność 80-90%, ponieważ koszt pominiętego słowa jest niski, a korekta szybka. Lista zakupów z dwoma zniekształconymi pozycjami to drobna niedogodność. Praktycy używający zamiany mowy na tekst do osobistego zarządzania wiedzą konsekwentnie stwierdzają, że poprawianie kilku błędów na akapit nie niweluje zaoszczędzonego czasu na rejestracji. Prawdziwym ograniczeniem jest tu obciążenie poznawcze, a nie precyzja.
Nawet na tym poziomie subtelny problem z niezawodnością potyka wielu użytkowników: początkowy okres wysokiej wydajności, po którym następuje niewyjaśniony spadek dokładności. Gdy to nastąpi, instynkt podpowiada założenie, że zmieniła się jakość dźwięku, podczas gdy prawdziwą przyczyną jest często zmiana trybu lub ścieżki przetwarzania. Strona z testami porównawczymi Cockatoo publikuje wskaźniki błędów V4-Pro dla poszczególnych języków wraz z metodologią, więc możesz sprawdzić, jak wypada twój język, zanim zobowiążesz się do przepływu pracy, zamiast odkrywać niezgodność po spadku.
2. Dokładność 95%+ - Minimalny standard dla spotkań biznesowych, podcastów i napisów do mediów
Spotkania biznesowe, transkrypcje podcastów i napisy do wideo lokują się na innym poziomie. Współczynnik błędów słów na poziomie 4% brzmi niewielki, dopóki nie zniekształci nazwiska klienta, nie pominie kwoty budżetu lub nie przypisze zadania niewłaściwej osobie. Zespół marketingowy tworzący napisy do filmów w mediach społecznościowych może tolerować WER na poziomie 4%; zespół produkujący film szkoleniowy z zakresu zgodności nie może. Na tym poziomie nazwy własne i liczby są pierwszymi ofiarami pogorszonej dokładności, a to właśnie te słowa napędzają decyzje.
Przepływ pracy korekty ma znaczenie równie duże jak początkowa dokładność. W edytorze przeglądarkowym Cockatoo wychwytujesz błędnie odczytane nazwiska i poprawiasz etykiety mówców bez ponownego przetwarzania pliku, a zmiana nazwy mówcy aktualizuje każdy wiersz. W przypadku nagrań ze spotkań plan Pro obejmuje również Canvas do podsumowań. Zamiast ponownie czytać całą godzinę, aby zweryfikować każde zadanie, możesz pracować na podstawie podsumowania tego, co faktycznie wymaga działania, a następnie zaglądać do transkrypcji tylko w celu ukierunkowanych poprawek. Ten dwuetapowy przepływ pracy utrzymuje osiągalną dokładność na poziomie biznesowym bez płacenia ludzkiemu transkrybentowi za każdy plik.
3. 99%+ dokładność - niepodlegający negocjacjom próg dla transkrypcji prawniczej, medycznej i compliance
Transkrypcja prawnicza, medyczna i compliance wymaga dokładności 99%+ bez istotnych wyjątków. Jedno przestawione lub źle usłyszane słowo może zmienić znaczenie, wprowadzić odpowiedzialność lub spowodować, że transkrypcja nie przejdzie audytu regulacyjnego. Badania branżowe mówią to wprost: jedno niedokładne słowo może zmienić znaczenie diagnozy, planu leczenia lub instrukcji dotyczącej leków. Na tym poziomie większość narzędzi AI nie jest w stanie zagwarantować tego progu na rzeczywistym dźwięku, a luka między nagłówkową liczbą dostawcy a rzeczywistą wydajnością w terenie jest miejscem, w którym kryje się odpowiedzialność.

Problem pomiaru WER jest tutaj najostrzejszy. Jeśli narzędzie po cichu pomija crosstalk specjalisty podczas dyskusji wielu klinicystów, wynikowa transkrypcja może uzyskać dobry wynik pod względem współczynnika błędów, mimo że całkowicie pomija klinicznie istotną treść – gorszy wynik niż transkrypcja, która podjęła próbę zapisu fragmentu i oznaczyła niepewność. Znajomość sposobu, w jaki narzędzie radzi sobie z nakładającą się mową, a nie tylko jego zbiorczy wynik dokładności, jest niezbędna przed zaufaniem mu w nagraniach o wysoką stawkę.
4. Transkrypcja ludzka na poziomie 99%+: wzorzec, według którego należy mierzyć AI
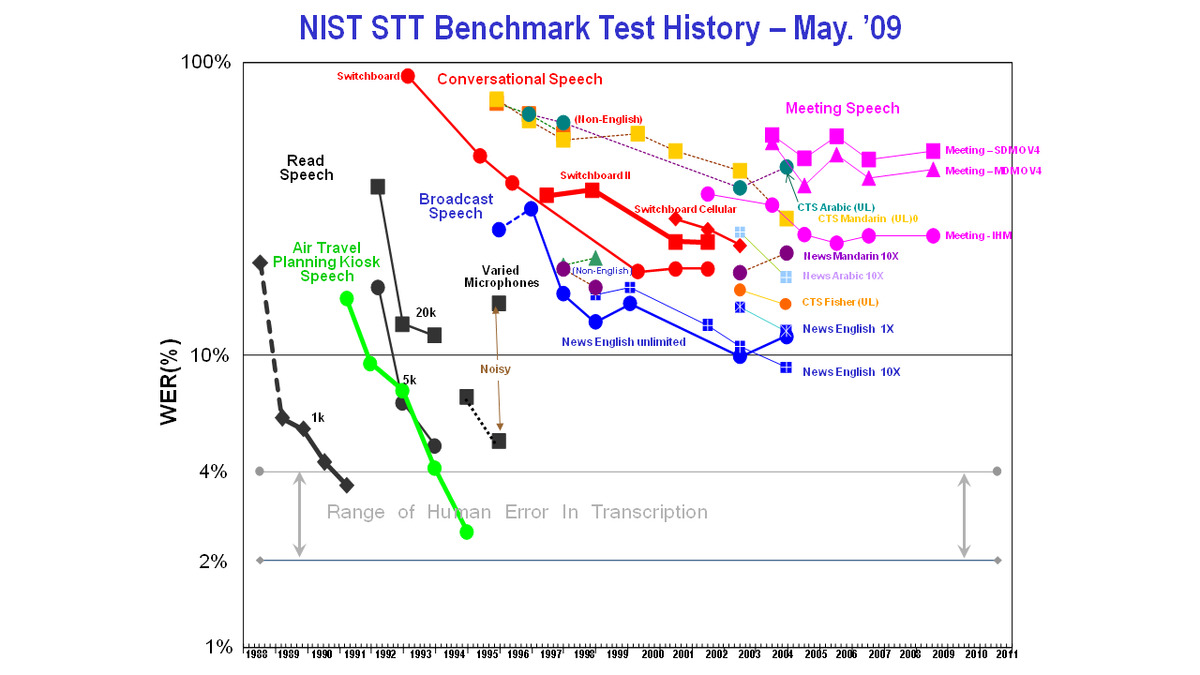
Wykwalifikowani transkrybenci ludzcy konsekwentnie osiągają dokładność 99%+, ponieważ ponownie słuchają, wywnioskowują kontekst i dostosowują się do akcentów w sposób, w jaki model statystyczny nie potrafi. To jest wzorzec, według którego mierzy się AI, a na czystym dźwięku studyjnym luka znacznie się zmniejszyła. Na nagraniach z akcentem, hałaśliwych lub z wieloma mówcami luka poszerza się w sposób, którego użytkownicy nie mogą przewidzieć z góry. Transkrypcja ludzka jest właściwym wyborem, gdy nagranie naprawdę wiąże się z wysoką stawką, a warunki dźwiękowe są złe; jest przesadą w przypadku roboczego podsumowania spotkania biznesowego.
Praktycznym pytaniem dla większości prosumerów i małych firm jest to, czy oceniane narzędzie jest testowane na dźwięku przypominającym ich rzeczywiste nagrania. Cockatoo bezpośrednio odnosi się do średniego poziomu: wyniki AI działają natychmiast w przypadku notatek swobodnych i szkiców spotkań, a edytor przeglądarkowy obsługuje etap korekty na poziomie biznesowym, poprawiając imiona, liczby i etykiety mówców bez ludzkiego transkrybenta przy każdym pliku. W planie Pro podsumowania Canvas oznaczają, że długie nagrania można skrócić do tego, co naprawdę wymaga działania, więc etap korekty jest ograniczony i szybki, a nie otwarty.
Użytkownicy mogą zweryfikować cały ten przepływ pracy na własnych plikach w planie Free, z nieograniczoną liczbą pełnych transkrypcji, bez dziennego limitu i bez karty kredytowej, plus cotygodniowe podglądy V4-Pro, przed zobowiązaniem się do płatnego planu. Pro przetwarza całe nagrania w V4-Pro, z etykietami mówców i nieograniczoną długością pliku, i dodaje podsumowania Canvas, co czyni praktycznym przetwarzanie wielogodzinnych nagrań przez ten sam przepływ pracy na skalę.
Znajomość własnego progu to tylko połowa równania. Trudniejszym pytaniem jest, czy jakiekolwiek narzędzie AI, w tym te cytujące 99% na swojej stronie głównej, faktycznie przekracza ten próg na nagraniach z akcentem, hałaśliwych i specyficznych dla danej dziedziny, które znajdują się w twoim folderze z nagraniami. To jest dokładnie to, co mierzy następna sekcja.
Powiązane lektury
- Najlepsze oprogramowanie do transkrypcji
- Cennik Turboscribe
- Lokalna transkrypcja AI
- Jak transkrybować wideo
- Transkrypcja wielojęzyczna
- Transkrypcja AI offline
Jak dokładność transkrypcji AI wypada w porównaniu z transkrypcją ludzką na dźwięku, który faktycznie posiadasz
Wybór między transkrypcją AI a ludzką wygląda na debatę o jakości, ale w rzeczywistości jest to debata o warunkach.
Na czystym dźwięku AI niemal dorównuje transkrybentom ludzkim
Według analizy wzorcowej VexaScribe, najlepsze silniki AI dorównują lub przewyższają przeciętnego transkrybenta ludzkiego przy około 4-5% WER na czystych nagraniach angielskich z jednym mówcą. 60-minutowy wywiad zwracany przy 3% WER zajmuje około 15 minut przeglądu, a różnica wydajności między najlepszymi a najgorszymi głównymi silnikami AI wynosi około 3-5 punktów WER.
Niedoceniana konsekwencja: w przypadku czystego materiału wideo, wykładu, demonstracji produktu, nagranego webinaru, dokładność AI jest często wystarczająco wysoka, że Cockatoo może przekształcić transkrypcję w pliki napisów SRT lub VTT w kilka sekund, gotowe do szybkiego przeglądu przed publikacją.
Luka pogłębia się w przypadku dźwięku ze świata rzeczywistego, ponieważ ludzie wnioskują, a AI zgaduje
W przypadku nagrań ze świata rzeczywistego obraz się zmienia. Analiza VexaScribe wykazała, że w przypadku spotkań, rozmów telefonicznych i mowy z akcentem AI ustępuje wykwalifikowanym transkrypcjonistom o 2-5% WER. Model AI dopasowuje wzorce do danych treningowych, a gdy dźwięk wykracza poza ten rozkład, dokładność gwałtownie i nieprzewidywalnie spada, podczas gdy ludzie transkrypcjoniści wnioskują znaczenie z kontekstu. Ludzkie tworzenie transkrypcji nie czyni jej dokładną; czyni ją autorską, z całą selektywną uwagą i wnioskowaniem, jakie to implikuje.
Czas korekty to ukryty koszt, który niweluje przewagę szybkości AI w przypadku trudnego dźwięku
60-minutowy wywiad z dwoma osobami niebędącymi native speakerami i słyszalnym szumem w tle może wrócić z AI z WER na poziomie 14%.
Canvas w Cockatoo, dołączony do Pro, jest stworzony dokładnie do tego: zamiast edytować długą transkrypcję słowo po słowie, używasz go, aby podsumować nagranie do tego, co faktycznie wymaga działania.
Jak poprawić dokładność transkrypcji, zanim prześlesz pojedynczy plik
Nagranie wykonane w hałaśliwym pomieszczeniu stawia przed każdym silnikiem transkrypcji problem, którego nie może w pełni rozwiązać. Narzędzie otrzymuje to, co uchwycił mikrofon; nie może odtworzyć informacji mowy, która nigdy nie została czysto nagrana. Dlatego najskuteczniejszą poprawą dokładności dostępną dla każdego użytkownika jest decyzja o sprzęcie i otoczeniu podjęta przed nagraniem, a nie ustawienie oprogramowania przełączane przy przesyłaniu.
Większość ludzi zakłada, że rozwiązaniem jest lepsze narzędzie. Prawdziwym rozwiązaniem jest lepszy dźwięk źródłowy. Oto sześć konkretnych kroków, które robią różnicę.
1. Ulepsz mikrofon, zanim dotkniesz jakiegokolwiek ustawienia oprogramowania
Journal of Electrical and Electronic Engineering potwierdza, że mikrofony kardioidalne przewyższają konstrukcje dookólne w hałaśliwym otoczeniu, tłumiąc dźwięki dochodzące z boków i tyłu, zachowując sygnał głosu z przodu. Mikrofon pojemnościowy USB za $50 skierowany bezpośrednio na mówcę daje każdemu silnikowi transkrypcji czystszy sygnał, niż kiedykolwiek może dać mikrofon laptopa. Wydawanie pieniędzy na wyższy poziom subskrypcji podczas nagrywania na wbudowanym sprzęcie optymalizuje niewłaściwy koniec procesu.
2. Nagrywaj w cichym pomieszczeniu, aby wyeliminować największego zabójcę dokładności
Klimatyzator, ulica za oknem lub działający wentylator sumują się w błędy w całym nagraniu. Zamknij drzwi, wyłącz wszystko, co buczy, i nagrywaj z dala od okien. Im cichsze pomieszczenie, tym więcej informacji mowy wychwytuje mikrofon i tym mniej silnik musi zgadywać.
3. Wycisz powiadomienia i ucisz urządzenia przed każdą sesją nagraniową
Dźwięki powiadomień są krótkie, ale ich wpływ jest nieproporcjonalny. Pojedynczy dźwięk alertu nakładający się na wypowiedziane słowo może całkowicie zepsuć to słowo, ponieważ silnik traci w tym momencie swoją kotwicę pewności, a często cierpią także sąsiednie słowa. Ustaw telefony na tryb cichy, zamknij karty przeglądarki, które automatycznie odtwarzają dźwięk, i wyłącz dźwięki systemowe na każdym komputerze w pomieszczeniu, zanim naciśniesz nagrywanie. To kosztuje trzydzieści sekund konfiguracji i rutynowo oszczędza minuty korekty.
4. Unikaj głośników telefonu i wbudowanych mikrofonów laptopa w przypadku każdego poważnego nagrania
Dźwięk rozmowy telefonicznej przetwarzany przez kodek wąskopasmowy obejmuje skompresowany zakres częstotliwości, który usuwa szczegóły akustyczne, na których silnik polega, aby rozróżnić podobnie brzmiące słowa. Wbudowane mikrofony laptopa mają ten sam problem: są dookólne i umieszczone daleko od ust mówcy, więc wychwytują pomieszczenie równie chętnie jak głos. Oba są akceptowalne w przypadku swobodnych notatek, gdzie drobne błędy mają niskie stawki. W przypadku każdego nagrania, w którym liczą się nazwiska, liczby lub decyzje, żadne z nich nie jest niezawodnym urządzeniem przechwytującym.
5. Ustal oczekiwania dotyczące dokładności przed przyjęciem nagrań terenowych lub dźwięku z rozmów telefonicznych
Jeśli ktoś przesyła ci nagranie wykonane telefonem w zatłoczonej kawiarni, górny limit dokładności jest już ustalony przed przesłaniem pliku. Żaden silnik ani żadna korekta po przesłaniu nie odzyska informacji mowy, która nie została czysto zarejestrowana. Przed przyjęciem pliku od klienta lub współpracownika zadaj jedno pytanie: czy nagranie zostało wykonane blisko mówiącego w cichym miejscu? Jeśli odpowiedź brzmi „nie”, zgłoś to od razu. Poprawianie złej transkrypcji zajmuje znacznie więcej czasu niż ustalenie oczekiwań przed rozpoczęciem pracy.
6. Sprawdź jakość starszych i archiwalnych nagrań przed przystąpieniem do transkrypcji
Nagrania archiwalne zawierają artefakty, szum taśmy, szum kodeka, kompresję pasma, które nowoczesne silniki AI obsługują inaczej niż ludzcy transkrybenci. Człowiek odsłuchuje ponownie i wnioskuje z kontekstu; silnik generuje najlepsze statystyczne przypuszczenie i przechodzi dalej, więc błędy kumulują się cicho wokół zniekształconych fragmentów. Przed przesłaniem pliku archiwalnego odtwórz trzydzieści sekund i nasłuchuj szumu, przesterowania lub echa. Jeśli odtwarzanie brzmi dla ciebie szorstko, w transkrypcji będzie wyglądać jeszcze gorzej. Ponowne nagranie krótkiego fragmentu, jeśli to możliwe, lub oznaczenie zniekształconych sekcji przed przesłaniem, kosztuje kilka minut i oszczędza pełne przepisanie.
Jedyna liczba dokładności, której warto ufać, to ta, którą możesz sam zweryfikować
Procenty wskaźnika błędów słów publikowane przez dostawców są zazwyczaj mierzone na czystej, studyjnie nagranej mowie angielskiej, warunkach, które niewiele mają wspólnego z zniekształconym, wielojęzycznym lub dziedzinowym dźwiękiem, z którym faktycznie pracuje większość organizacji. Znaczące testy porównawcze podają nazwę zestawu testowego, określają rozkład języków i akcentów oraz dzielą wydajność według poziomu jakości dźwięku, zamiast sprowadzać wszystko do jednej optymistycznej średniej.
„Użytkownicy nie mogą niezależnie zweryfikować twierdzeń TranscribeX o '40% lepszej dokładności' lub 'znacznie lepszej dokładności'; nie dostarczono żadnego testu porównawczego, pliku testowego ani metodologii, którą ktokolwiek mógłby samodzielnie powtórzyć.”
— co słyszymy od użytkowników oprogramowania do transkrypcji
Test porównawczy Google FLEURS obejmuje rzeczywistą nagraną mowę w 102 językach w standardowych warunkach, co czyni go powtarzalnym zewnętrznym punktem odniesienia, który każdy użytkownik może zweryfikować. FLEURS publikuje podziały ewaluacyjne dla poszczególnych języków, więc wskaźnik błędów słów dla danego języka na FLEURS jest weryfikowalnym twierdzeniem, a nie liczbą wybraną przez dostawcę w sprzyjających warunkach.
Model, który dobrze radzi sobie z angielskim w większościowym akcencie, może zwracać znacznie wyższe wskaźniki błędów dla indonezyjskiego, asama lub francuskiego, podczas gdy główna liczba w ogóle się nie zmienia. Weryfikowalna dokładność wymaga trzech rzeczy jednocześnie: nazwanego testu porównawczego (FLEURS się kwalifikuje), podziałów na poszczególne języki zamiast uśrednionej liczby oraz dźwięku testowego odzwierciedlającego rzeczywiste warunki nagrywania.
Dlaczego kompromis między dokładnością a przystępnością cenową jest problemem technologicznym, a nie prawem fizyki
Najnowocześniejsze uczenie głębokie, zaprojektowane pod kątem szybkości i dokładności, sprawia, że wysoka dokładność jest przystępna cenowo przy dowolnym wolumenie.
Cockatoo publikuje wyniki dla poszczególnych języków dla swojego trybu V4-Pro we wszystkich 36 językach, które transkrybuje. Są one mierzone na FLEURS oraz na wewnętrznym, oznaczonym przez ludzi zbiorze rzeczywistych nagrań, oceniane jako WER (CER dla chińskiego, japońskiego, khmerskiego i tajskiego) z normalizacją tekstu open-source OpenAI Whisper. Luka opisana w tym artykule pojawia się również w tych liczbach. Na angielskich klipach FLEURS wskaźnik błędów słów V4-Pro wynosi 3.9%. Na rzeczywistych angielskich nagraniach wynosi od 10.4% do 10.9%. V4-Pro ma najniższy wskaźnik błędów spośród testowanych dostawców w 25 z 36 języków na FLEURS, ale nie w każdym języku: na angielskim FLEURS Universal-3.5 Pro firmy AssemblyAI uzyskał niższy wynik. Wyniki, metoda i uwaga, że zbiór rzeczywisty jest sprawdzeniem wewnątrzpróbkowym, znajdują się na stronie testów porównawczych. Dokładność różni się w zależności od języka i jakości nagrania.
Jak przeprowadzić pięciominutowy test weryfikacyjny, zanim zasubskrybujesz cokolwiek
Policz błędy w stosunku do tego, co zostało faktycznie powiedziane. Benchmark dostawcy na FLEURS mówi ci o dolnym progu; twój własny klip mówi ci o rzeczywistości. Zewnętrzny benchmark plus test na prawdziwym pliku razem eliminują asymetrię informacji, którą pozostawia samoocena dostawcy.
Powiązane lektury
- Najlepsza aplikacja do transkrypcji
- Descript Vs Otter
- Fireflies Vs Otter
- Trint Vs Rev
- Happy Scribe Vs Rev
- Konkurenci Otter.AI
Następne kroki
Jeśli twoje nagrania wracają z transkrypcjami, których poprawianie zajmuje więcej czasu niż ponowne przepisanie, droga naprzód zaczyna się od uznania, że główna liczba dokładności nigdy nie była mierzona na dźwięku takim jak twój. Zacznij od naszego oprogramowania do transkrypcji.
Wpływ jakości dźwięku na dokładność przyćmiewa wszelkie różnice między silnikami, a różnica między najlepszymi i najgorszymi narzędziami AI na rzeczywistych nagraniach zmniejsza się do 3 do 5 punktów WER, margines, który same warunki nagrania mogą przesunąć o większą wartość. Oznacza to, że wybór „dokładniejszego” narzędzia bez uprzedniego przetestowania go na własnych plikach to optymalizacja niewłaściwej zmiennej. Jednocześnie dostawca, który publikuje wyniki dla poszczególnych języków na standaryzowanym zewnętrznym zbiorze danych i pozwala przetestować na własnym dźwięku przed zapłatą, strukturalnie usuwa asymetrię informacji, która sprawia, że twierdzenia o dokładności są z definicji nieweryfikowalne.
Te dwa warunki razem, zewnętrzny benchmark plus test na prawdziwym pliku, to jedyna kombinacja, która pozwala zweryfikować twierdzenie, a nie mu zaufać. Razem wskazują na oczywisty następny krok: przetestuj własny dźwięk w narzędziu, które publikuje oba.
Zacznij od oprogramowania do transkrypcji, które publikuje benchmarki FLEURS dla poszczególnych języków i nie wymaga karty kredytowej do testowania. Prześlij prawdziwy klip z własnych nagrań, porównaj wynik z opublikowanymi liczbami dla swojego języka i masz jedyną liczbę dokładności, która kiedykolwiek przenosi się na warunki produkcyjne.
Często zadawane pytania
Co właściwie oznacza dla mojej transkrypcji w praktyce współczynnik dokładności 95%?
Współczynnik dokładności 95% oznacza około 25 błędów na każde 500 słów transkrypcji, wystarczająco, by błędnie nazwać klienta, zniekształcić liczbę lub całkowicie pominąć kluczowy element działania. Na rzeczywistych nagraniach z szumem tła, akcentami lub wieloma mówcami dokładność rutynowo spada dalej, do zakresu 85 do 92%, gdzie ta sama transkrypcja może zawierać 75 błędów i wymagać pełnego przepisania, a nie lekkiej edycji.
Dlaczego dostawcy reklamują dokładność 98% lub 99%, gdy moje transkrypcje wracają pełne błędów?
Dostawcy testują swoje narzędzia na czystym, studyjnym dźwięku jednego mówcy, zbiorach danych takich jak LibriSpeech z profesjonalnymi mikrofonami, bez szumu tła i bez zróżnicowania akcentów, i nie mają obowiązku ujawniania tych warunków testowych. Twoja rozmowa kwalifikacyjna, nagranie rozmowy telefonicznej lub nagranie spotkania prawie na pewno nie odpowiada tym warunkom, więc główna liczba po prostu nie została zmierzona na dźwięku takim jak twój.
Jak złe jest w rzeczywistości nakładanie się mowy dla narzędzi do transkrypcji?
Kiedy dwóch mówców mówi jednocześnie, mikrofon rejestruje pojedynczy mieszany przebieg fali, którego żaden model nie może idealnie rozdzielić, ponieważ głosy zajmują jednocześnie tę samą przestrzeń częstotliwości, to problem fizyki, nie oprogramowania. Poza błędami słów, które to powoduje, branżowe benchmarki na nagraniach spotkań wielomówcowych pokazują współczynniki błędów diaryzacji (Diarization Error Rate) na poziomie 15-30% dla dźwięku z nakładaniem się mowy lub jakości telefonicznej, co oznacza, że do trzech słów na dziesięć może być przypisanych niewłaściwemu mówcy w panelu czteroosobowym.
Czy Word Error Rate to to samo co procent dokładności pokazany na stronie głównej dostawcy?
Tak, procent dokładności to po prostu odwrócony WER. WER oblicza się jako (Podstawienia + Usunięcia + Wstawienia) podzielone przez całkowitą liczbę słów w transkrypcji referencyjnej, więc WER 5% staje się deklarowaną dokładnością 95%. Każdy typ błędu liczy się w formule equally, co oznacza, że usunięcie, które usuwa słowo „nie” z „nie kontynuuj”, kosztuje tyle samo co trywialna literówka, a błędy skupiają się wokół najtrudniejszych momentów, mowy z akcentem, nakładających się głosów i terminów dziedzinowych, zamiast rozkładać się równomiernie w całej transkrypcji.
Czy moje nagranie musi być naprawdę złe, zanim dokładność się załamie, czy spada stopniowo?
Dokładność nie spada płynnie w dół, lecz utrzymuje się na poziomie zbliżonym do referencyjnego, a następnie gwałtownie się załamuje, gdy degradacja sygnału przekroczy krytyczny próg. Badania nad odpornością ASR pokazują, że ten efekt progowy oznacza, iż plik, który dla ludzkiego ucha brzmi tylko „trochę szorstko”, może już być poza punktem, w którym wskaźnik błędów gwałtownie rośnie, zwracając transkrypcję wymagającą pełnego przepisania, a nie lekkiej edycji.






