Transskriptionsnøjagtighedsrater vildleder dig i 2026
Leverandører offentliggør nøjagtighedstal uden at oplyse, hvad de målte. Her er, hvad WER faktisk beregner, hvorfor benchmarks med ren lyd smigrer alle værktøjer, og hvad det overskriftstal koster dig på en rigtig optagelse.
Den almindelige antagelse er, at hvis et værktøj reklamerer med en høj nøjagtighedsprocent, bør outputtet være pålideligt nok til at bruge med kun mindre rettelser; overskriftstallet er et meningsfuldt kvalitetssignal. Leverandørers nøjagtighedspåstande er overalt. Ingen af disse fortæller dig, hvad tallet faktisk målte, eller om den måling har noget at gøre med din optagelse.
Kerneproblemet er definitionsmæssigt. Den samme metrik, målt under forskellige forhold, giver vidt forskellige resultater, og ingen regel kræver, at leverandører fortæller dig, hvilke forhold de brugte.
Se vores transskriberingssoftware for hvordan dette fungerer i praksis.
Word Error Rate (WER) er den standardmetrik, der ligger bag ethvert nøjagtighedstal i transskriberingsbranchen. Ifølge Association for Computational Linguistics' 2018 e-WER-artikel beregnes WER ved at tælle substitutioner, sletninger og indsættelser i forhold til det samlede antal ord i en referencetransskription. Moderne AI-systemer kan opnå 2 til 5 procent WER på ren lyd i studiekvalitet, hvilket oversættes til 95 til 98 procent nøjagtighed. Hage er begravet i "ren lyd i studiekvalitet": enkelt taler, tæt på mikrofonen, lav baggrundsstøj, kontrolleret miljø. De fleste, der transskriberer et rigtigt interview, kundesamtale eller optaget møde, arbejder ikke under disse forhold.
Den samme ACL-forskning gør det klart, at WER kræver en referencetransskription, og leverandører vælger, hvilken lyd der producerer den transskription. En leverandør kan køre deres model mod en ren studieoptagelse med en enkelt taler, rapportere en 2 procent WER og offentliggøre "98% nøjagtig" på deres hjemmeside. Det tal er ikke falsk.
Det måler noget, der ikke har noget at gøre med dit støjende konferencerum eller din interviewpersons regionale accent. To leverandører kan begge påstå høj nøjagtighed, mens deres værktøjer fungerer helt forskelligt på rigtig lyd, fordi de benchmarkede mod helt forskellige forhold. Der er ingen forpligtelse til at oplyse lydtypen, talerprofilen, støjniveauet eller domænet.
Ingen branchestandard styrer, hvordan transskriberingsnøjagtighed skal måles eller rapporteres. Fordi WER beregnes mod en valgt reference under valgte forhold, kan et enkelt overskriftstal rapporteret uden metodeoplysning ikke meningsfuldt fortolkes som et kvalitetssignal til brug i den virkelige verden. Det eneste tal, der er værd at stole på, er et, der er benchmarket på rigtig lyd, offentliggjort pr. sprog, så du kan tjekke det mod din egen optagelsestype, før du forpligter dig.
Vigtige pointer
- "99% præcis" er en markedsføringspåstand, ikke en måling; leverandører afslører næsten aldrig, hvilken lyd de har testet på, hvilket gør tallet umuligt at verificere eller stole på.
- Word Error Rate beregnes som standard på ren, studieregistreret tale, hvilket betyder, at enhver leverandørs hovedtal er benchmarket på forhold, der ikke ligner et rigtigt interview, møde eller feltoptagelse.
- Accenter, baggrundsstøj, flere talere og domænespecifikt ordforråd er ikke kanttilfælde, de er den grundlæggende virkelighed for det meste transskriptionsarbejde, og det er præcis, hvad leverandørbenchmarks udelukker.
- Nøjagtighedskrav er ikke en enkelt tærskel: en 95%-rate, der fungerer fint til en personlig stemmenote, ville være katastrofalt utilstrækkelig til juridisk, medicinsk eller compliance-transskription.
- AI-transskription på ren lyd med en enkelt taler nærmer sig nu menneskelig nøjagtighed; forskellen bliver markant større i det øjeblik lydkvaliteten forringes, hvilket er netop, når valget mellem AI og menneske faktisk betyder noget.
- Forbedringen med højest effekt sker, før du trykker på optag: mikrofonplacering og rumakustik giver enhver transskriptionsmotor et bedre signal at arbejde med, end efterbehandling nogensinde kan.
- Det eneste benchmark, der er værd at stole på, navngiver testsættet, specificerer sproget og accenten og lader dig replikere det på din egen lyd; enhver påstand, der ikke opfylder den standard, bør ignoreres.
- Cockatoo lader dig selv køre den virkelige test: upload din egen lyd eller video, få AI-transskription hurtigt tilbage, og verificer nøjagtigheden mod de optagelser, du faktisk har brug for at behandle, intet salgsopkald, ingen kurateret demofil.
Hvordan Word Error Rate beregnes, og hvorfor benchmarks med ren lyd smigrer enhver leverandør
Det tal kommer direkte fra formlen for Word Error Rate, og når du først ser regnestykket, bliver forskellen mellem en leverandørs hovedtal og din faktiske transskription umulig at ignorere.
WER-formlen dekodet - hvad substitutioner, sletninger og indsættelser reelt koster dig
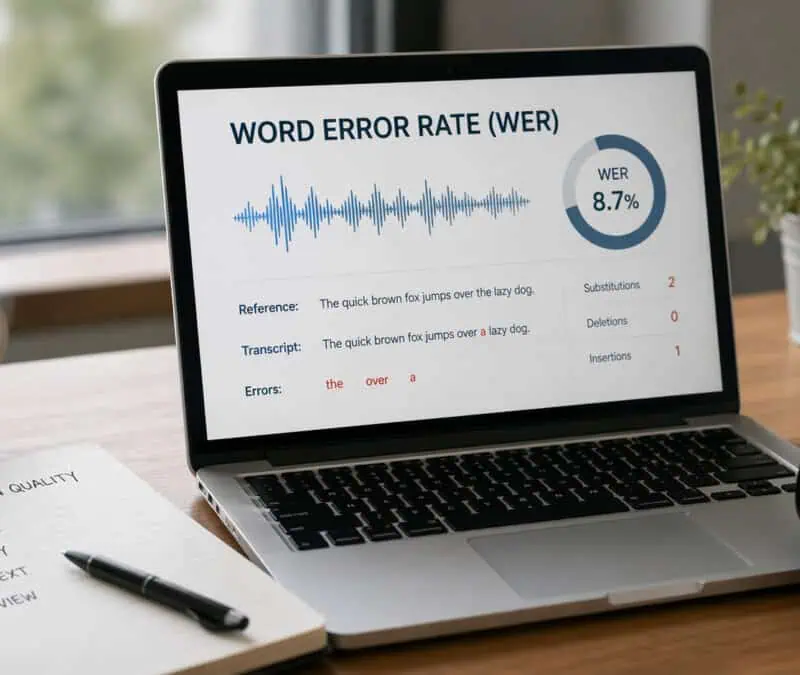
Word Error Rate beregnes som (S + D + I) / N, hvor S tæller substituerede ord, D tæller slettede ord, I tæller indsatte ord, og N er det samlede antal ord i referencetransskriptionen. Hver fejltype vægtes lige i formlen, så et udeladt ord koster præcis lige så meget som et forkert.
En 5% WER betyder ikke én pæn fejl for hver 20 ord. Det betyder fem fejl et eller andet sted i hver 100 ord, hobende sig op omkring accentet tale, overlappende stemmer og domænespecifikke termer, og disse klynger har tendens til at lande præcis, hvor meningen er mest koncentreret.
Hvorfor moderne AI scorer 2 til 5 procent WER på ren lyd, og hvordan den optagelse faktisk lyder
Moderne talegenkendelsessystemer opnår WER helt ned til 2 til 5% på ren lyd i studiekvalitet, benchmarks der kræver optagelser med en enkelt taler, lav støj og tæt på mikrofonen. Disse tal kommer fra datasæt som LibriSpeech: en enkelt taler, professionel mikrofon, ingen baggrundsstøj, ingen afbrydelser, ingen accentvariation, ingen kodeskift. Som Allmaz' ordliste om Word Error Rate bemærker, er de fleste general-purpose-motorer ikke trænet på virkelige samtalemønstre, hvilket betyder, at hovedtal afledt af ren, domæneintern lyd ikke forudsiger ydeevnen på de optagelser, de fleste brugere faktisk producerer.
95 procent præcis betyder allerede 25 forkerte ord pr. 500-ords transskription, før virkelig lyd gør det værre
25
Forkerte ord i en 500-ords transskription ved 95% nøjagtighed
En 500-ords mødetransskription indeholder cirka 25 fejl ved 95% nøjagtighed, nok til at navngive en klient forkert, fordreje et tal eller helt droppe en vigtig handlingspunkt. På faktiske optagelser med baggrundsstøj, accenter eller flere talere falder nøjagtigheden rutinemæssigt til intervallet 85 til 92%. Ved 85% indeholder samme transskription 75 fejl: ikke en transskription, du redigerer, men en du skriver om.
Den korrektionsskala kræver en arbejdsgang bygget op omkring nem eksport og overdragelse. Cockatoo's DOCX- og PDF-eksporter findes netop til det formål; den person, der optog mødet, behøver ikke være den person, der renser transskriptionen op. Gratis konti får ubegrænsede transskriptioner i fuld længde i V4-Flash, uden daglig grænse, og alle eksportformater: DOCX, PDF, TXT, SRT, VTT, CSV og JSON.
De faktorer, der reelt ødelægger transskriptionsnøjagtigheden på rigtige optagelser
Rigtige optagelser bryder transskriptionsværktøjer på måder, som leverandørernes benchmarks aldrig afslører. De betingelser, der oppuster fejlraten, er ikke kanttilfælde; de er den standardvirkelighed, enhver står over for, når de transskriberer et interview, en telefonoptagelse eller en paneldiskussion. At forstå, hvilke variabler der udløser nøjagtighedskollaps, er forskellen mellem at uploade en fil med selvtillid og at bruge to timer på at rette en transskription, der kom tilbage som næsten volapyk.
1. Baggrundsstøj, rumklang og dårlig mikrofonplacering - De fire optagelsesvariabler, som benchmarks aldrig tester
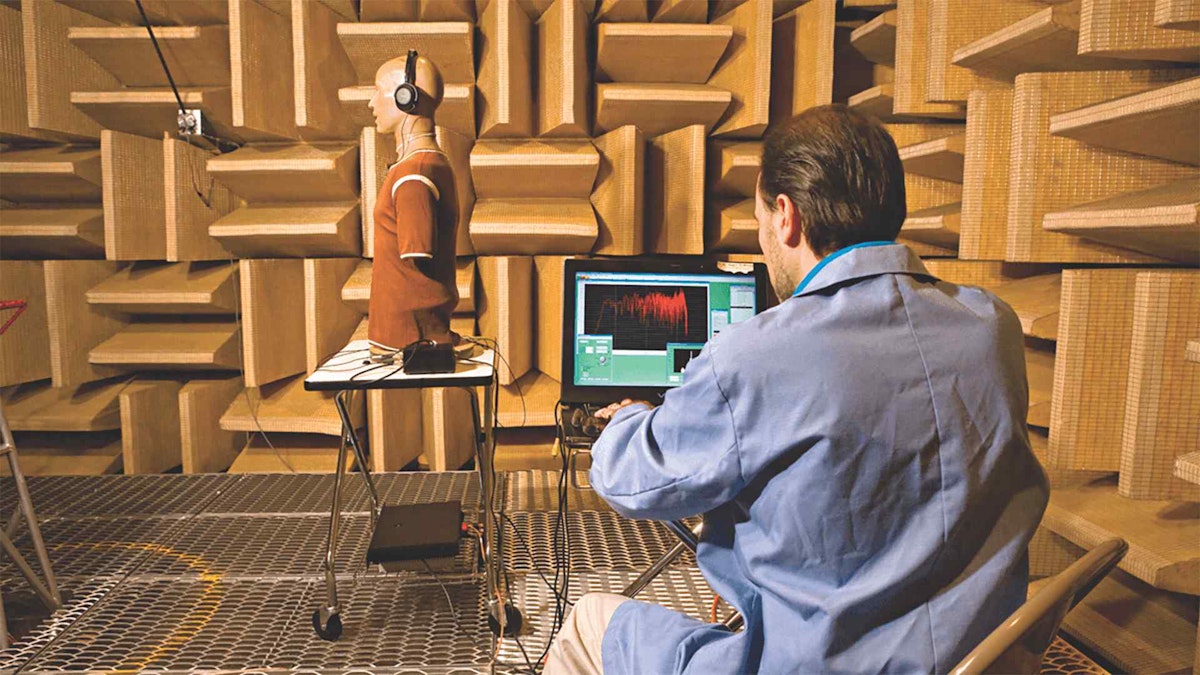
Signal-til-støj-forholdet er den enkeltstående stærkeste forudsiger for transskriptionsnøjagtighed, og det kollapser hurtigt. Forskning offentliggjort i Speech Communication viser, at word error rate kan stige fra under 5% på ren lyd til over 30%, når signal-til-støj-forholdet falder under 10 dB, et niveau der beskriver et almindeligt kontor med en kørende aircondition eller en telefonopkald taget i et køkken. Rumklang forværrer dette yderligere: reflekteret lyd udtværer konsonanter sammen, og modellen modtager to kopier af hver fonem på let forskellige tidspunkter, hvilket forårsager sletningsfejl, som ingen mængde efterbehandling kan genoprette fuldt ud.
Mikrofonplacering er den variabel, de fleste undervurderer. En laptopmikrofon, der optager en taler to meter væk i et ubehandlet rum, er en fundamentalt anderledes signalklasse end de tæt-mikrofon, ekkofrie input, som benchmarks bruger.
Det er her, valget af tilstand betyder noget i praksis. Cockatoo har to transskriptionstilstande. V4-Flash transskriberer op til 120x realtid og er gratis og ubegrænset. V4-Pro er den mest nøjagtige tilstand, kører ved cirka 20x realtid og tilføjer taleretiketter. Gratis konti får ugentlige V4-Pro-forhåndsvisninger, så du kan sammenligne begge tilstande på en optagelse lavet i dit eget rum, før du beslutter, hvilken din lyd har brug for.
Pro kører hele optagelser i V4-Pro, med højere brugsgrænser og prioriteret behandling. Aktuelle planer findes på prissiden.
2. Ikke-indfødte accenter og regional dialektvariation - Hvorfor substitutionsfejl stiger uden for korpora med flertalsaccent

Transskriptionsnøjagtighed på ikke-indfødt engelsk tale adskiller sig væsentligt fra det officielle tal. Brancheforskning fandt, at fem førende ASR-systemer producerede fejlrater for sorte amerikanske engelsktalende, der var dobbelt så høje som for hvide amerikanske engelsktalende, og accentrelaterede forskelle for ikke-indfødte talere er endnu større. Fejltilstanden er substitutionsfejl: ord, der lyder plausible i konteksten, men er forkerte, så de overlever en hurtig gennemlæsning og korrumperer optegnelsen i det skjulte.
Brancheforskning fandt, at fem førende ASR-systemer producerede fejlrater for sorte amerikanske engelsktalende, der var dobbelt så høje som for hvide amerikanske engelsktalende, og accentrelaterede forskelle for ikke-indfødte talere er endnu større.
Et interview optaget på en café med to ikke-indfødte engelsktalende vil typisk returnere en nøjagtighed i de høje 70'ere fra et værktøj, der reklamerer med 99%. Kløften er en strukturel konsekvens af træningskorpora, der er vægtet mod tale med flertalsaccent optaget i studio. Cockatoo transskriberer 36 sprog, og dets fejlrate per sprog V4-Pro, på FLEURS og på virkelige optagelser, er offentliggjort på dets benchmark-side, det rette sted at tjekke dit sprog, før du forpligter en specialoptagelse.
Når du har en præcis transskription ved hånden, er det næste friktionspunkt at få den i et format, en kollega faktisk kan åbne og redigere. Cockatoo eksporterer direkte til PDF og DOCX, så en transskription lander som en Word- eller PDF-fil, som en anden kan redigere uden nogen konverteringstrin – en detalje, der lyder ubetydelig, indtil man har prøvet at udtrække en ren tekstfil til et formateret dokument under en deadline.
3. Speaker Diarization Error Rate (DER) - Det skjulte præcisionslag, som leverandører næsten aldrig offentliggør
Diarization Error Rate (DER) måler, hvor præcist et system tildeler hvert ord til den korrekte taler. Det beregnes som summen af mistet tale, falske alarmer og talerforveksling divideret med den samlede referencetaletid. Branchebenchmarks på flertaler-mødeoptagelser fra kilder som NIST Rich Transcription-evalueringerne viser DER-tal på 15-30% på overlappende eller telefonkvalitetslyd, hvilket betyder, at i et panel med fire personer kan op til tre ord ud af ti blive tildelt den forkerte taler.
Leverandører offentliggør næsten aldrig DER sammen med WER. Resultatet er, at en transskription kan se præcis ud på ordniveau, mens den er strukturelt ubrugelig: sætninger delt midt i en tanke på tværs af de forkerte talere, handlingspunkter tilskrevet den forkerte person, og en oprydningsbyrde, som forskere inden for kvalitative interview konsekvent beskriver som værre end at skrive fra bunden.
4. Ikke-lineært lydkvalitetskollaps - Hvorfor præcision ikke forringes gradvist, og hvorfor nogle filer kræver en fuld omskrivning
Præcision falder ikke gradvist, efterhånden som forholdene forværres. Den holder, og så bryder den sammen.
Forskning i ASR-robusthed viser en tærskelvirkning: modeller bevarer næsten benchmark-præcision, indtil signalforringelse krydser et kritisk punkt, hvor den akustiske model mister fodfæstet, og fejlraten stiger skarpt i stedet for at stige proportionalt med den tilføjede støj. Den praktiske konsekvens er, at en fil, der lyder "lidt rå" for et menneskeligt øre, kan ligge lige forbi denne tærskel og give en transskription, der kræver en fuld omskrivning snarere end let redigering. De fleste solotransskribenter opdager først dette, efter de allerede har uploadet, ventet og åbnet resultatet.
Cockatoo's Pro-plan understøtter ubegrænset fillængde, så filer på flere timer uploades i deres helhed. Upload enhver lyd- eller videofil og få en redigerbar transskription tilbage. På V4-Pro registreres talere automatisk, og omdøbning af en taler i editoren opdaterer hver linje.

Transskriptioner leveres med tidsstempler på ordniveau og automatisk tegnsætning. Præcisionsevidence findes på den offentliggjorte benchmarks-side (FLEURS pr. sprog og virkelige resultater for 36 sprog, med metoden) i stedet for en bar procentdel.
Ubegrænset fillængde er vigtig her, fordi længere optagelser, som statistisk set er mere tilbøjelige til at indeholde variable akustiske forhold hele vejen igennem, er de filer, der mest sandsynligt rammer det ikke-lineære kollapspunkt undervejs. At kunne uploade uden at afkorte filen betyder, at modellen ser den fulde kontekst i stedet for en klippet version, der kan starte eller slutte midt i en sætning.
5. Overlappende tale og krydstale - Hvordan samtidige stemmer ødelægger signalintegriteten ved kilden

Når to talere taler samtidig, er problemet ikke en softwarebegrænsning. Det er et fysikproblem. Mikrofonen modtager en enkelt blandet bølgeform, og ingen model kan perfekt adskille to stemmer, der optager samme frekvensrum på samme tidspunkt. En paneloptagelse med fire overlappende stemmer, hvor diarisering deler sætninger midt i en tanke på tværs af de forkerte talere, fejler, fordi signalintegriteten blev ødelagt ved kilden.
Krydstale i opkaldsoptagelser og videokonferencer er særligt skadelig, fordi komprimerings-codecs, der bruges i disse pipelines, yderligere forringer de overlappende segmenter og efterlader modellen med et allerede forringet input, før nøjagtighedsfaktorer, der påvirker transskription, overhovedet kommer i spil.
Til videooptagelser med overlappende tale er det nedstrøms behov ofte en publiceret undertekst- eller subtitle-fil frem for en transskription til redigering. Cockatoo eksporterer undertekstfiler i SRT og VTT på alle planer, sammen med DOCX, PDF, TXT, CSV og JSON, og masseeksport følger med Pro, så det korrigerede output kan leveres direkte til videoen uden at kræve en separat konvertering.
6. Domænespecifikt vokabular og teknisk jargon - Det leksikale gab, der oppuster word error rate på specialiserede optagelser
Generelle ASR-modeller er optimeret til hverdagssprog og har svært ved medicinsk, juridisk, videnskabelig eller branchespecifik terminologi. Når en taler bruger domænejargon, erstatter modellen det med det nærmeste fonetisk lignende almindelige ord, hvilket producerer fejl, der er sværere at fange ved gennemgang, fordi de lyder plausible. For fagfolk, der transskriberer specialiseret indhold, er dette leksikale gab en vedvarende og underrapporteret årsag til tab af transskriptionsnøjagtighed, som WER-scorer på ren lyd fuldstændigt slører.
Hvordan god transskriptionsnøjagtighed faktisk ser ud på tværs af forskellige anvendelsestilfælde
Nøjagtighedskrav er ikke én enkelt tærskel. Den grænse, der gør en personlig stemmenote perfekt brugbar, ville få en compliance-medarbejder fyret. Det nøjagtighedsniveau, et transskriptionsværktøj faktisk skal levere, skalerer med, hvor katastrofalt et enkelt forkert ord kan kaskadere nedstrøms, så leverandørens hovedtal er direkte misvisende for nogle brugere.
En undervurderet fælde: standard Word Error Rate-metrikker kan lyve ved udeladelse. Et værktøj, der lydløst dropper krydstale og springer overlappende talere over i stedet for at forsøge at transskribere dem, vil rapportere en lavere WER end et værktøj, der forsøger og lejlighedsvis forvrænger disse udvekslinger. Det første værktøj ser mere nøjagtigt ud på papiret, mens det leverer mindre af dit faktiske møde.
1. 80-90% nøjagtighed - Det acceptable gulv for uformelle noter og personlig diktering
Uformelle noter og personlig diktering tolererer 80-90% nøjagtighed, fordi prisen for et mistet ord er lav, og korrektionen er hurtig. En indkøbsliste med to forvanskede elementer er en mindre gene. Udøvere, der bruger tale-til-tekst til personlig vidensstyring, finder konsekvent, at rettelse af et par fejl pr. afsnit ikke udsletter den tid, der spares på optagelsen. Den reelle begrænsning her er kognitiv belastning, ikke præcision.
Selv på dette niveau snubler mange brugere over et subtilt pålidelighedsproblem: en indledende periode med høj ydeevne efterfulgt af et uforklarligt fald i nøjagtighed. Når det sker, er instinktet at antage, at lydkvaliteten ændrede sig, mens den reelle årsag ofte er, at tilstanden eller behandlingsvejen skiftede. Cockatoo's benchmarks-side offentliggør fejlrater pr. sprog V4-Pro, med metoden, så du kan tjekke, hvordan dit sprog klarer sig, før du forpligter dig til en arbejdsgang, i stedet for at opdage uoverensstemmelsen efter faldet.
2. 95%+ nøjagtighed - Minimumsstandarden for forretningsmøder, podcasts og medieundertekster
Forretningsmøder, podcast-transskriptioner og videoundertekster ligger i et andet niveau. En word error rate på 4% lyder lille, indtil den forvrænger en klients navn, dropper et budgettal eller fejltildeler en handlingspost til den forkerte person. Et marketingteam, der laver undertekster til sociale videoer, kan tolerere en WER på 4%; et team, der producerer en compliance-træningsvideo, kan ikke. På dette niveau er egennavne og tal de første ofre for forringet nøjagtighed, og det er netop de ord, der driver beslutninger.
Korrektionsarbejdsgangen betyder lige så meget som den indledende nøjagtighed. I Cockatoo's browser-editor fanger du fejllæste navne og retter taleretiketter uden at genbehandle filen, og omdøbning af en taler opdaterer hver linje. Til mødeoptagelser inkluderer Pro også Canvas til opsummeringer. I stedet for at genlæse en hel time for at verificere hver handlingspost, kan du arbejde ud fra en opsummering af, hvad der faktisk skal handles på, og derefter gå ind i transskriptionen kun for de målrettede rettelser. Denne to-trins arbejdsgang holder forretningsniveauets nøjagtighed opnåelig uden at betale en menneskelig transskribent for hver fil.
3. 99%+ nøjagtighed - den ufravigelige tærskel for transskription inden for jura, medicin og compliance
Transskription inden for jura, medicin og compliance kræver 99%+ nøjagtighed uden meningsfulde undtagelser. Et enkelt ombyttet eller fejlhørt ord kan ændre betydningen, medføre ansvar eller få en transskription til at dumpe i en regulatorisk revision. Brancheforskning siger det klart: et enkelt unøjagtigt ord kan ændre betydningen af en diagnose, behandlingsplan eller medicineringsinstruktion. På dette niveau kan de fleste AI-værktøjer ikke garantere tærsklen på lyd fra den virkelige verden, og kløften mellem en leverandørs overskriftsnummer og den faktiske ydeevne i marken er, hvor ansvaret ligger.

Problemet med WER-måling er skarpest her. Hvis et værktøj lydløst udelader en specialists crosstalk under en diskussion med flere klinikere, kan den resulterende transskription score godt på fejlraten, mens den mangler klinisk signifikant indhold helt, et værre resultat end en transskription, der forsøgte passagen og flaggede usikkerhed. At vide, hvordan et værktøj håndterer overlappende tale, ikke bare dets samlede nøjagtighedsscore, er essentielt, før man stoler på det til højrisikooptagelser.
4. Menneskelig transskription ved 99%+: Benchmark, som AI skal måles imod
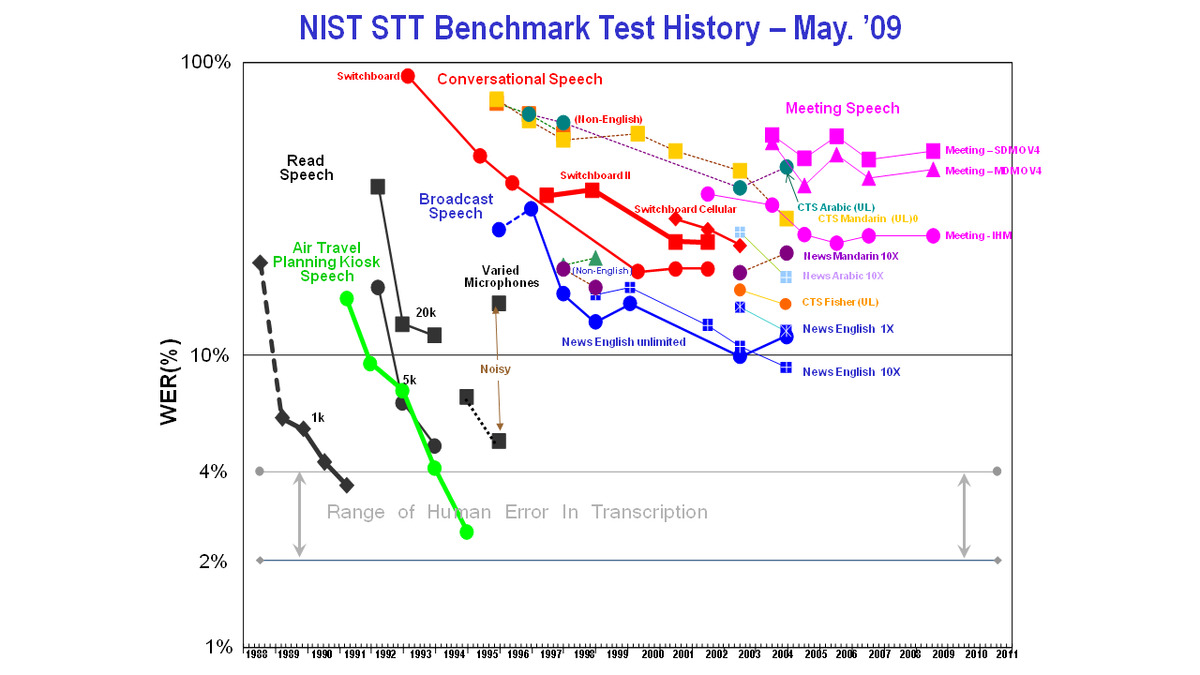
Dygtige menneskelige transskribenter opnår konsekvent 99%+ nøjagtighed, fordi de genlytter, udleder kontekst og tilpasser sig accenter på måder, en statistisk model ikke kan. Det er benchmarken, som AI måles imod, og på ren studiolyd er kløften blevet betydeligt mindre. På accented, støjende eller flerhøjttaleroptagelser udvides kløften på måder, brugerne ikke kan forudsige på forhånd. Menneskelig transskription er det rigtige valg, når optagelsen er genuint højrisiko og lydforholdene er dårlige; det er overkill til et første udkast til et forretningsmøde resumé.
Det praktiske spørgsmål for de fleste prosumers og små virksomheder er, om det værktøj, de evaluerer, er benchmarked på lyd, der ligner deres faktiske optagelser. Cockatoo adresserer mellemniveauet direkte: AI-output fungerer med det samme til uformelle noter og mødeudkast, og browsereditoren håndterer forretningsniveauets korrektionspas, får navne, tal og højttalertiketter rigtige uden en menneskelig transskribent på hver fil. På Pro betyder Canvas-resuméer, at lange optagelser kan kondenseres til det, der faktisk skal handles på, så korrektionspasset er afgrænset og hurtigt i stedet for åbent.
Brugere kan verificere hele denne arbejdsgang mod deres egne filer på gratisplanen, med ubegrænsede transskriptioner i fuld længde, ingen daglig grænse og intet kreditkort påkrævet, plus ugentlige V4-Pro-forhåndsvisninger, før de forpligter sig til en betalt plan. Pro kører hele optagelser i V4-Pro, med højttalertiketter og ubegrænset fillængde, og tilføjer Canvas-resuméer, hvilket gør det praktisk at køre flertimersoptagelser gennem samme arbejdsgang i skala.
At kende din tærskel er kun halvdelen af ligningen. Det sværere spørgsmål er, om noget AI-værktøj, inklusive dem, der citerer 99% på deres hjemmeside, faktisk klarer den bar på den accented, støjende, domænespecifikke lyd, der ligger i din optagelsesmappe. Det er præcis, hvad næste afsnit måler.
Relateret læsning
- Bedste transskriptionssoftware
- Turboscribe-priser
- Lokal AI-transskription
- Sådan transskriberer du en video
- Flersproget transskription
- Offline AI-transskription
Hvordan AI-transskriptionsnøjagtighed sammenlignes med menneskelig transskription på den lyd, du faktisk har
Valget mellem AI og menneskelig transskription ligner en kvalitetsdebat, men det er virkelig en betingelsesdebat.
På ren lyd matcher AI næsten menneskelige transskribenter
Ifølge VexaScribes benchmarkanalyse matcher eller overgår top-AI-motorer den gennemsnitlige menneskelige transskribent ved cirka 4-5% WER på rene engelsksprogede optagelser med en enkelt højttaler. Et 60-minutters interview, der returnerer ved 3% WER, tager cirka 15 minutter at gennemgå, og ydeevnespredningen mellem de bedste og dårligste store AI-motorer ligger på cirka 3-5 WER-point.
En undervurderet konsekvens: på rent videomateriale, en forelæsning, en produktdemo, en optaget webinar, er AI-nøjagtigheden ofte høj nok til, at Cockatoo kan omdanne transskriptionen til SRT eller VTT undertekstfiler på få sekunder, klar til en hurtig gennemgang før publicering.
Kløften vokser ved virkelig lyd, fordi mennesker udleder, mens AI gætter
Ved virkelige optagelser ændrer billedet sig. VexaScribe's analyse fandt, at ved møder, telefonopkald og accentpræget tale ligger AI 2-5% WER bag dygtige menneskelige transskribenter. En AI-model mønstermatchr mod træningsdata, og når lyden falder uden for den fordeling, falder nøjagtigheden stejlt og uforudsigeligt, hvorimod menneskelige transskribenter udleder betydning fra kontekst. Menneskelig produktion af en transskription gør den ikke nøjagtig; den gør den forfattet, med al den selektive opmærksomhed og udledning, det indebærer.
Rettelsestid er den skjulte omkostning, der udsletter AI's hastighedsfordel ved svær lyd
Et 60-minutters interview med to ikke-modersmålstalende og hørbar baggrundsstøj kan komme tilbage fra AI ved 14% WER.
Cockatoo's Canvas, inkluderet med Pro, er bygget til præcis dette: i stedet for at linjeredigere en lang transskription ord for ord, bruger du den til at opsummere optagelsen ned til det, der faktisk skal handles på.
Sådan forbedrer du transskriptionsnøjagtigheden, før du uploader en enkelt fil
En optagelse lavet i et støjende rum giver enhver transskriptionsmotor et problem, den ikke fuldt ud kan løse. Værktøjet modtager det, mikrofonen har fanget; det kan ikke rekonstruere taleinformation, der aldrig blev rent optaget i første omgang. Det er derfor, den enkeltstående mest effektive nøjagtighedsforbedring, der er tilgængelig for enhver bruger, er en hardware- og miljøbeslutning truffet før optagelsen, ikke en softwareindstilling, der slås til ved upload.
De fleste antager, at løsningen er et bedre værktøj. Den virkelige løsning er bedre kildelyd. Her er seks konkrete trin, der flytter nålen.
1. Opgrader din mikrofon, før du rører ved nogen softwareindstilling
Journal of Electrical and Electronic Engineering bekræfter, at kardioide mikrofoner klarer sig bedre end omnidirektionelle designs i støjende miljøer ved at dæmpe lyde, der ankommer fra siderne og bagfra, og bevare talesignalet foran. En $50 USB-kondensatormikrofon rettet direkte mod taleren giver enhver transskriptionsmotor et renere signal, end en bærbar mikrofon nogensinde kan. At bruge penge på et højere abonnementsniveau, mens man optager på indbygget hardware, optimerer den forkerte ende af pipelinen.
2. Optag i et stille rum for at eliminere den største nøjagtighedsdræber
Et klimaanlæg, en gade udenfor eller en kørende ventilator akkumulerer til fejl gennem en hel optagelse. Luk døre, sluk alt, der summer, og optag væk fra vinduer. Jo stillere rummet er, jo mere taleinformation fanger mikrofonen, og jo mindre skal motoren gætte.
3. Slå notifikationer fra og gør enheder lydløse før hver optagelsessession
Notifikationslyde er korte, men deres indvirkning er uforholdsmæssig stor. En enkelt alarmlyd, der overlapper et talt ord, kan ødelægge det ord fuldstændigt, fordi motoren mister sit konfidensanker på præcis det øjeblik, og de omkringliggende ord lider ofte også. Sæt telefoner på lydløs, luk browsertabs, der afspiller lyd automatisk, og deaktiver systemlyde på enhver computer i rummet, før du trykker på optag. Det koster tredive sekunders opsætning og sparer rutinemæssigt minutter med rettelser.
4. Undgå telefontalehøjttalere og indbyggede bærbare mikrofoner til enhver seriøs optagelse
Telefonopkaldslyd behandlet gennem en smalbåndskodek fanger et komprimeret frekvensområde, der fjerner akustisk detalje, som motoren er afhængig af for at skelne enslydende ord. Indbyggede bærbare mikrofoner har samme problem: de er omnidirektionelle og placeret langt fra talerens mund, så de fanger rummet lige så let som stemmen. Begge er acceptable til uformelle noter, hvor mindre fejl er af lav risiko. For enhver optagelse, hvor navne, tal eller beslutninger betyder noget, er ingen af dem en pålidelig optagelsesenhed.
5. Fastlæg forventninger til nøjagtighed, før du accepterer feltoptagelser eller lyd fra telefonopkald
Hvis nogen sender dig en optagelse, de har lavet på en telefon på en travl café, er loftet for nøjagtighed allerede sat, før du uploader den. Ingen motor, og ingen mængde justering efter upload, gendanner taleinformation, der aldrig blev optaget rent. Før du accepterer en fil fra en klient eller kollega, stil ét spørgsmål: blev den optaget tæt på taleren i et stille rum? Hvis svaret er nej, så markér det på forhånd. At rette en dårlig transskription tager langt længere tid end at nulstille forventningerne, før arbejdet begynder.
6. Gennemgå ældre og arkivoptagelser for kvalitet, før du forpligter dig til transskription
Ældre optagelser bærer artefakter, båndhiss, codec-støj, båndbreddekomprimering, som moderne AI-motorer håndterer anderledes end menneskelige transskribenter. Et menneske lytter igen og udleder ud fra konteksten; en motor leverer sit bedste statistiske gæt og går videre, så fejl samler sig lydløst omkring forringede passager. Før du uploader en arkivfil, afspil tredive sekunder, og lyt efter hiss, klipning eller ekko. Hvis afspilningen lyder rå for dit øre, vil den læse værre i transskriptionen. At genoptage et kort segment, hvor det er muligt, eller markere de forringede sektioner før upload, koster minutter og sparer en fuld omskrivning.
Det eneste nøjagtighedstal, der er værd at stole på, er et, du selv kan verificere
Word Error Rate-procenter, som leverandører offentliggør, måles typisk mod ren, studieregistreret engelsk tale, forhold der ligner lidt den forringede, flersprogede eller domænespecifikke lyd, som de fleste organisationer faktisk arbejder med. Meningsfulde benchmarks navngiver testsættet, specificerer sprog- og accentfordelingen og opdeler ydeevnen efter lydkvalitetsniveau i stedet for at samle alt i ét optimistisk gennemsnit.
"Brugere kan ikke uafhængigt verificere de '40% bedre nøjagtighed' eller 'meget bedre nøjagtighed'-påstande, som TranscribeX fremsætter; der er intet benchmark, testfil eller metodologi angivet, som nogen selv kan replikere."
— det hører vi fra brugere af transskriptionssoftware
Google FLEURS-benchmarken dækker rigtig optaget tale på tværs af 102 sprog under standardiserede forhold, hvilket gør den til en reproducerbar ekstern reference, som enhver bruger kan krydstjekke. FLEURS offentliggør sprogspecifikke evalueringsopdelinger, så en ordfejlrate pr. sprog på FLEURS er en verificerbar påstand, ikke et tal, som leverandøren har udvalgt under gunstige forhold.
En model, der klarer sig godt på engelsk med majoritetsaccent, kan returnere betydeligt højere fejlrater på indonesisk, assamesisk eller fransk, uden at det overordnede tal ændrer sig overhovedet. Reviderbar nøjagtighed kræver tre ting sammen: et navngivet benchmark (FLEURS kvalificerer), opdelinger pr. sprog i stedet for et blandet tal, og testlyd, der afspejler virkelige optagelsesforhold.
Hvorfor afvejningen mellem nøjagtighed og økonomi er et teknologiproblem, ikke en fysiklov
State-of-the-art deep learning, konstrueret til hastighed og nøjagtighed, gør høj nøjagtighed overkommelig i ethvert volumen.
Cockatoo offentliggør resultater pr. sprog for sin V4-Pro-tilstand på tværs af alle 36 sprog, som den transskriberer. De er målt på FLEURS og på et internt, menneskemærket sæt af virkelige optagelser, scoret som WER (CER for kinesisk, japansk, khmer og thai) med OpenAI Whisper's open source-tekstnormalisering. Det gab, denne artikel beskriver, viser sig også i disse tal. På engelske FLEURS-klip er V4-Pro's ordfejlrate 3.9%. På virkelige engelske optagelser er den 10.4% til 10.9%. V4-Pro har den laveste fejlrate blandt de testede udbydere i 25 af 36 sprog på FLEURS, men ikke på alle sprog: på engelsk FLEURS scorede AssemblyAI's Universal-3.5 Pro lavere. Resultaterne, metoden og en bemærkning om, at det virkelige sæt er et in-sample-tjek, findes på benchmarks-siden. Nøjagtigheden varierer efter sprog og optagelseskvalitet.
Sådan kører du en fem-minutters verifikationstest, før du abonnerer på noget
Tæl fejlene op mod det, der faktisk blev sagt. En leverandørs benchmark på FLEURS fortæller dig gulvet; dit eget klip fortæller dig virkeligheden. En ekstern benchmark plus en test med en rigtig fil fjerner tilsammen den informationsasymmetri, som en leverandørs selvrapporterede tal efterlader.
Relateret læsning
- Bedste transskriptionsapp
- Descript Vs Otter
- Fireflies Vs Otter
- Trint Vs Rev
- Happy Scribe Vs Rev
- Otter.AI-konkurrenter
Næste skridt
Hvis dine optagelser bliver ved med at komme tilbage med transskriptioner, der tager længere tid at rette end at skrive igen, starter vejen frem med at anerkende, at det markedsførte nøjagtighedstal aldrig blev målt på lyd som din. Start med vores transskriptionssoftware.
Lydkvalitetens indvirkning på nøjagtigheden overgår enhver forskel mellem motorer, og kløften mellem de bedste og dårligste AI-værktøjer på virkelige optagelser skrumper til 3 til 5 WER-point, en margin som optageforhold alene kan svinge med en større margin. Det betyder, at valget af et "mere præcist" værktøj uden først at teste det på dine egne filer er at optimere den forkerte variabel. Samtidig har en leverandør, der offentliggør resultater pr. sprog på et standardiseret eksternt datasæt og lader dig teste på din egen lyd før betaling, strukturelt fjernet den informationsasymmetri, der gør nøjagtighedspåstande uverificerbare per design.
Disse to betingelser tilsammen, ekstern benchmark plus test med rigtig fil, er den eneste kombination, der lader dig revidere påstanden i stedet for at stole på den. Tilsammen peger de på et oplagt næste skridt: kør din egen lyd gennem et værktøj, der offentliggør begge dele.
Start med transskriptionssoftware, der offentliggør FLEURS-benchmarks pr. sprog og ikke kræver kreditkort for at teste. Upload et rigtigt klip fra dine egne optagelser, sammenlign resultatet med de offentliggjorte tal for dit sprog, og du har det eneste nøjagtighedstal, der nogensinde overføres til produktionsforhold.
Ofte stillede spørgsmål
Hvad betyder en nøjagtighedsrate på 95% egentlig for min transskription i praksis?
En nøjagtighedsrate på 95% betyder cirka 25 fejl i hver 500-ords transskription, nok til at navngive en klient forkert, ødelægge et tal eller helt droppe et vigtigt handlingspunkt. På rigtige optagelser med baggrundsstøj, accenter eller flere talere falder nøjagtigheden rutinemæssigt yderligere, ned i intervallet 85 til 92%, hvor den samme transskription kan indeholde 75 fejl og kræve en fuld omskrivning i stedet for let redigering.
Hvorfor reklamerer leverandører med 98% eller 99% nøjagtighed, når mine transskriptioner kommer tilbage fulde af fejl?
Leverandører benchmarker deres værktøjer mod ren, studie-kvalitets, enkelt-taler lyd, datasæt som LibriSpeech med professionelle mikrofoner, ingen baggrundsstøj og ingen accentvariation, og er ikke forpligtet til at oplyse disse testbetingelser. Dit interview, din opkaldsoptagelse eller din mødeoptagelse matcher næsten helt sikkert ikke disse betingelser, så det markedsførte tal blev simpelthen ikke målt på lyd som din.
Hvor slemt bliver overlappende tale egentlig for transskriptionsværktøjer?
Når to talere taler på samme tid, optager mikrofonen en enkelt blandet bølgeform, som ingen model kan adskille perfekt, fordi stemmerne optager det samme frekvensrum samtidigt, det er et fysikproblem, ikke et softwareproblem. Ud over de ordfejl, dette forårsager, viser branchebenchmarks på mødeoptagelser med flere talere Diarization Error Rates på 15-30% på overlappende eller telefonkvalitetslyd, hvilket betyder, at op til tre ord ud af ti kan blive tildelt den forkerte taler i et panel med fire personer.
Er Word Error Rate det samme som den nøjagtighedsprocent, der vises på en leverandørs hjemmeside?
Ja, nøjagtighedsprocenten er blot WER inverteret. WER beregnes som (Substitutioner + Sletninger + Indsættelser) divideret med det samlede ordantal i en referencetransskription, så en WER på 5% bliver til en påstået nøjagtighed på 95%. Hver fejltype tæller lige meget i formlen, hvilket betyder, at en sletning, der fjerner ordet "ikke" fra "fortsæt ikke", koster det samme som en triviel stavefejl, og fejl klumper sig sammen omkring de sværeste øjeblikke, accentpræget tale, overlappende stemmer og domænespecifikke termer, i stedet for at sprede sig jævnt over transskriptionen.
Skal min optagelse blive virkelig dårlig, før nøjagtigheden kollapser, eller glider den gradvist?
Nøjagtighed falder ikke glidende nedad, den holder sig nær benchmark-niveauer og bryder derefter skarpt sammen, når signalforringelse krydser en kritisk tærskel. Forskning i ASR-robusthed viser, at denne tærskel-effekt betyder, at en fil, der kun lyder "lidt rå" for et menneskeligt øre, allerede kan være forbi det punkt, hvor fejlraten stiger dramatisk, og returnerer en transskription, der kræver en fuld omskrivning snarere end let redigering.






