อัตราความแม่นยำในการถอดเสียงกำลังทำให้คุณเข้าใจผิดใน 2026
ผู้ขายเผยแพร่ตัวเลขความแม่นยำโดยไม่เปิดเผยว่าพวกเขาวัดอะไร นี่คือสิ่งที่ WER คำนวณจริง ๆ ทำไมมาตรฐานเสียงคุณภาพดีจึงทำให้ทุกเครื่องมือดูดีเกินจริง และตัวเลขพาดหัวนั้นมีต้นทุนอะไรกับคุณในการบันทึกเสียงจริง
สมมติฐานทั่วไปคือ หากเครื่องมือโฆษณาอัตราความแม่นยำสูง ผลลัพธ์ควรเชื่อถือได้พอที่จะใช้โดยแก้ไขเพียงเล็กน้อย ตัวเลขพาดหัวเป็นสัญญาณคุณภาพที่มีความหมาย การกล่าวอ้างความแม่นยำของผู้ขายมีอยู่ทุกหนแห่ง ไม่มีสิ่งใดบอกคุณว่าตัวเลขนั้นวัดอะไรจริง ๆ หรือการวัดนั้นเกี่ยวข้องกับการบันทึกเสียงของคุณหรือไม่
ปัญหาหลักคือเรื่องนิยาม เมตริกเดียวกันที่วัดภายใต้เงื่อนไขต่างกันให้ผลลัพธ์ที่แตกต่างกันอย่างมาก และไม่มีกฎใดกำหนดให้ผู้ขายต้องบอกคุณว่าพวกเขาใช้เงื่อนไขใด
ดูซอฟต์แวร์ถอดเสียงของเราเพื่อดูว่าสิ่งนี้ทำงานอย่างไรในทางปฏิบัติ
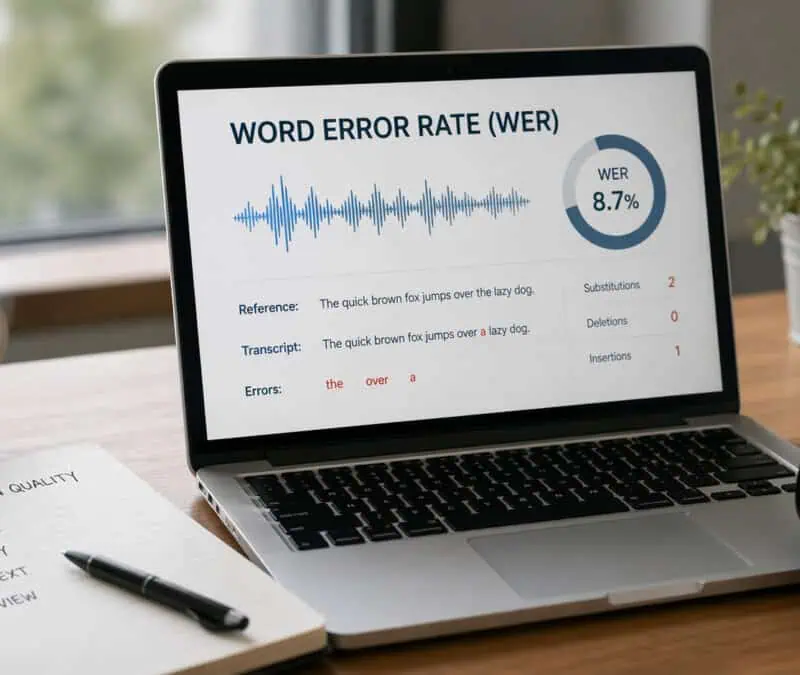
Word Error Rate (WER) เป็นเมตริกมาตรฐานเบื้องหลังตัวเลขความแม่นยำทุกตัวในอุตสาหกรรมการถอดเสียง ตามรายงาน e-WER ของ Association for Computational Linguistics 2018 WER คำนวณโดยการนับการแทนที่ การลบ และการแทรก เทียบกับจำนวนคำทั้งหมดในบทถอดเสียงอ้างอิง ระบบ AI สมัยใหม่สามารถทำได้ที่ WER 2 ถึง 5 เปอร์เซ็นต์บนเสียงคุณภาพสตูดิโอที่สะอาด ซึ่งแปลงเป็นความแม่นยำ 95 ถึง 98 เปอร์เซ็นต์ ข้อแม้นั้นซ่อนอยู่ในคำว่า "สะอาด คุณภาพสตูดิโอ": ผู้พูดคนเดียว ใกล้ไมโครโฟน เสียงรบกวนพื้นหลังต่ำ สภาพแวดล้อมควบคุม คนส่วนใหญ่ที่ถอดเสียงบทสัมภาษณ์จริง สายลูกค้า หรือการประชุมที่บันทึกไว้ ไม่ได้ทำงานภายใต้เงื่อนไขเหล่านั้น
งานวิจัย ACL เดียวกันระบุชัดเจนว่า WER ต้องมีบทถอดเสียงอ้างอิง และผู้ขายเลือกเองว่าเสียงใดจะสร้างบทถอดเสียงนั้น ผู้ขายสามารถรันโมเดลกับเสียงอัดสตูดิโอที่สะอาดของผู้พูดคนเดียว รายงาน WER 2 เปอร์เซ็นต์ และประกาศบนหน้าแรกว่า "แม่นยำ 98%" ตัวเลขนั้นไม่เป็นเท็จ
มันกำลังวัดบางสิ่งที่ไม่เกี่ยวข้องกับห้องประชุมที่มีเสียงรบกวนของคุณหรือสำเนียงท้องถิ่นของผู้ถูกสัมภาษณ์ ผู้ขายสองรายสามารถอ้างความแม่นยำสูงทั้งคู่ในขณะที่เครื่องมือของพวกเขาทำงานแตกต่างกันโดยสิ้นเชิงกับเสียงจริง เพราะพวกเขาเปรียบเทียบกับเงื่อนไขที่แตกต่างกันโดยสิ้นเชิง ไม่มีข้อผูกพันใดให้เปิดเผยประเภทเสียง โปรไฟล์ผู้พูด ระดับเสียงรบกวน หรือโดเมน
ไม่มีมาตรฐานระดับอุตสาหกรรมใดควบคุมว่าความแม่นยำในการถอดเสียงต้องวัดหรือรายงานอย่างไร เนื่องจาก WER คำนวณเทียบกับข้อมูลอ้างอิงที่เลือกภายใต้เงื่อนไขที่เลือก ตัวเลขพาดหัวเพียงตัวเดียวที่รายงานโดยไม่เปิดเผยระเบียบวิธีจึงไม่สามารถตีความอย่างมีความหมายเป็นสัญญาณคุณภาพสำหรับการใช้งานจริงได้ ตัวเลขเดียวที่ควรค่าแก่การเชื่อถือคือตัวเลขที่เปรียบเทียบกับเสียงจริง เผยแพร่แยกตามภาษา เพื่อให้คุณตรวจสอบกับประเภทการบันทึกเสียงของคุณเองก่อนตัดสินใจ
ประเด็นสำคัญ
- "99% แม่นยำ" เป็นคำกล่าวอ้างทางการตลาด ไม่ใช่การวัดผล ผู้ขายแทบไม่เคยเปิดเผยว่าใช้เสียงทดสอบอะไร ซึ่งทำให้ตัวเลขนั้นเป็นไปไม่ได้ที่จะตรวจสอบหรือเชื่อถือ
- Word Error Rate คำนวณจากเสียงพูดที่บันทึกในสตูดิโอที่สะอาดโดยค่าเริ่มต้น หมายความว่าตัวเลขหลักของทุกผู้ขายถูกวัดเทียบกับเงื่อนไขที่ไม่มีความคล้ายคลึงกับบทสัมภาษณ์ การประชุม หรือการบันทึกภาคสนามจริง
- สำเนียง เสียงรบกวนพื้นหลัง ผู้พูดหลายคน และคำศัพท์เฉพาะด้านไม่ใช่กรณีข้อยกเว้น แต่เป็นความจริงโดยปกติของงานถอดเสียงส่วนใหญ่ และเป็นสิ่งที่การทดสอบมาตรฐานของผู้ขายตัดออกไปเสียสิ้น
- ข้อกำหนดด้านความแม่นยำไม่ใช่มาตรฐานเดียว: อัตรา 95% ที่ใช้ได้ดีกับข้อความเสียงส่วนตัวจะไม่เพียงพออย่างร้ายแรงสำหรับการถอดเสียงทางกฎหมาย การแพทย์ หรือการปฏิบัติตามข้อกำหนด
- การถอดเสียงด้วย AI บนเสียงที่สะอาดและมีผู้พูดคนเดียวเข้าใกล้ความแม่นยำระดับมนุษย์ในปัจจุบัน ช่องว่างจะกว้างขึ้นอย่างรวดเร็วทันทีที่คุณภาพเสียงลดลง ซึ่งเป็นเวลาที่การเลือกระหว่าง AI กับมนุษย์มีความหมายจริง ๆ
- การปรับปรุงความแม่นยำที่ได้ผลสูงสุดเกิดขึ้นก่อนที่คุณจะกดบันทึก: การวางตำแหน่งไมโครโฟนและเสียงในห้องให้สัญญาณที่ดีกว่าแก่เครื่องถอดเสียงใด ๆ ได้ดีกว่าการประมวลผลภายหลัง
- การทดสอบมาตรฐานเดียวที่ควรค่าแก่การเชื่อถือคือการระบุชุดทดสอบ ระบุภาษาและสำเนียง และให้คุณทำซ้ำได้กับเสียงของคุณเอง คำกล่าวอ้างใดที่ไม่ผ่านเกณฑ์นั้นควรถูกเพิกเฉย
- Cockatoo ให้คุณทดสอบในโลกจริงได้ด้วยตัวเอง: อัปโหลดเสียงหรือวิดีโอของคุณ รับการถอดเสียงด้วย AI กลับมาอย่างรวดเร็ว และตรวจสอบความแม่นยำกับบันทึกที่คุณต้องประมวลผลจริง ไม่มีการโทรขาย ไม่มีไฟล์ตัวอย่างที่คัดสรรแล้ว
วิธีคำนวณ Word Error Rate และเหตุใดการทดสอบมาตรฐานบนเสียงสะอาดจึงทำให้ผู้ขายทุกรายดูดีเกินจริง
ตัวเลขนั้นมาจากสูตร Word Error Rate โดยตรง และเมื่อคุณเห็นการคำนวณแล้ว ช่องว่างระหว่างตัวเลขหลักของผู้ขายกับบทถอดเสียงจริงของคุณก็จะไม่อาจมองข้ามได้
ถอดรหัสสูตร WER - การแทนที่ การลบ และการแทรกทำให้คุณเสียหายจริงอย่างไร
Word Error Rate คำนวณเป็น (S + D + I) / N โดย S นับคำที่ถูกแทนที่ D นับคำที่ถูกลบ I นับคำที่ถูกแทรก และ N คือจำนวนคำทั้งหมดในบทถอดเสียงอ้างอิง ข้อผิดพลาดแต่ละประเภทมีน้ำหนักเท่ากันในสูตร คำที่ตกหล่นจึงมีต้นทุนเท่ากับคำที่ผิดพอดี
WER 5% ไม่ได้หมายถึงข้อผิดพลาดหนึ่งครั้งเรียบร้อยทุก ๆ 20 คำ แต่หมายถึงข้อผิดพลาดห้าครั้งที่ใดที่หนึ่งภายในทุก ๆ 100 คำ ซึ่งรวมตัวกันรอบ ๆ คำพูดที่มีสำเนียง เสียงที่ทับซ้อนกัน และคำศัพท์เฉพาะด้าน และกลุ่มข้อผิดพลาดเหล่านั้นมักตกอยู่ตรงจุดที่ความหมายเข้มข้นที่สุดพอดี
เหตุใด AI สมัยใหม่จึงได้คะแนน WER 2 ถึง 5 เปอร์เซ็นต์บนเสียงสะอาด และการบันทึกนั้นฟังดูเป็นอย่างไรจริง ๆ
ระบบรู้จำเสียงพูดสมัยใหม่ทำได้ WER ต่ำถึง 2 ถึง 5% บนเสียงสะอาดระดับสตูดิโอ ซึ่งเป็นการทดสอบมาตรฐานที่ต้องมีผู้พูดคนเดียว เสียงรบกวนต่ำ และบันทึกใกล้ไมโครโฟน ตัวเลขเหล่านั้นมาจาก ชุดข้อมูลอย่าง LibriSpeech: ผู้พูดคนเดียว ไมโครโฟนระดับมืออาชีพ ไม่มีเสียงรบกวนพื้นหลัง ไม่มีการขัดจังหวะ ไม่มีการแปรผันของสำเนียง ไม่มีการสลับภาษา ตามที่อภิธานศัพท์ของ Allmaz เกี่ยวกับ Word Error Rate ระบุไว้ เครื่องยนต์อเนกประสงค์ส่วนใหญ่ไม่ได้ถูกฝึกบนรูปแบบการสนทนาในโลกจริง ซึ่งหมายความว่าตัวเลขหลักที่ได้จากเสียงสะอาดในโดเมนเดียวกันไม่สามารถทำนายประสิทธิภาพบนบันทึกที่ผู้ใช้ส่วนใหญ่ผลิตจริงได้
95 เปอร์เซ็นต์แม่นยำอยู่แล้วหมายถึงคำผิด 25 คำต่อบทถอดเสียง 500 คำ ก่อนที่เสียงในโลกจริงจะทำให้แย่ลงไปอีก
25
คำผิดในบทถอดเสียง 500 คำที่ความแม่นยำ 95%
บทถอดเสียงการประชุม 500 คำมีข้อผิดพลาดประมาณ 25 ครั้งที่ความแม่นยำ 95% ซึ่งเพียงพอที่จะทำให้ชื่อลูกค้าผิด ทำให้ตัวเลขเพี้ยน หรือทำตกหล่นรายการสิ่งที่ต้องดำเนินการสำคัญไปเลย บนบันทึกจริงที่มีเสียงรบกวนพื้นหลัง สำเนียง หรือผู้พูดหลายคน ความแม่นยำมักลดลงอยู่ในช่วง 85 ถึง 92% ที่ 85% บทถอดเสียงเดียวกันนั้นมีข้อผิดพลาด 75 ครั้ง ไม่ใช่บทถอดเสียงที่คุณแก้ไข แต่เป็นบทที่คุณต้องเขียนใหม่
การแก้ไขในระดับนั้นต้องอาศัยกระบวนการทำงานที่สร้างขึ้นรอบการส่งออกและการส่งต่อที่ง่ายดาย การส่งออก DOCX และ PDF ของ Cockatoo มีไว้เพื่อจุดประสงค์นั้น ผู้ที่บันทึกการประชุมไม่จำเป็นต้องเป็นผู้ที่ต้องมาแก้ไขไฟล์ถอดความ บัญชีฟรีได้รับไฟล์ถอดความแบบเต็มความยาวไม่จำกัดใน V4-Flash โดยไม่มีขีดจำกัดรายวัน และมีทุกรูปแบบการส่งออก: DOCX, PDF, TXT, SRT, VTT, CSV และ JSON
ปัจจัยที่ทำลายความแม่นยำในการถอดความบนไฟล์บันทึกจริง
ไฟล์บันทึกจริงทำให้เครื่องมือถอดความเสียหายในลักษณะที่เกณฑ์มาตรฐานของผู้ขายไม่เคยเปิดเผย สภาวะที่ทำให้อัตราความผิดพลาดพุ่งสูงไม่ใช่กรณีสุดโต่ง แต่เป็นความจริงโดยปกติสำหรับใครก็ตามที่ถอดความบทสัมภาษณ์ การบันทึกสายสนทนา หรือการอภิปรายเป็นคณะ การเข้าใจว่าตัวแปรใดกระตุ้นให้ความแม่นยำพังทลายคือความแตกต่างระหว่างการอัปโหลดไฟล์อย่างมั่นใจ กับการใช้เวลาสองชั่วโมงแก้ไขไฟล์ถอดความที่ออกมาแทบเป็นภาษาต่างดาว
1. เสียงรบกวนพื้นหลัง เสียงสะท้อนในห้อง และการวางไมโครโฟนที่ไม่ดี - ตัวแปรการบันทึกสี่ประการที่เกณฑ์มาตรฐานไม่เคยทดสอบ
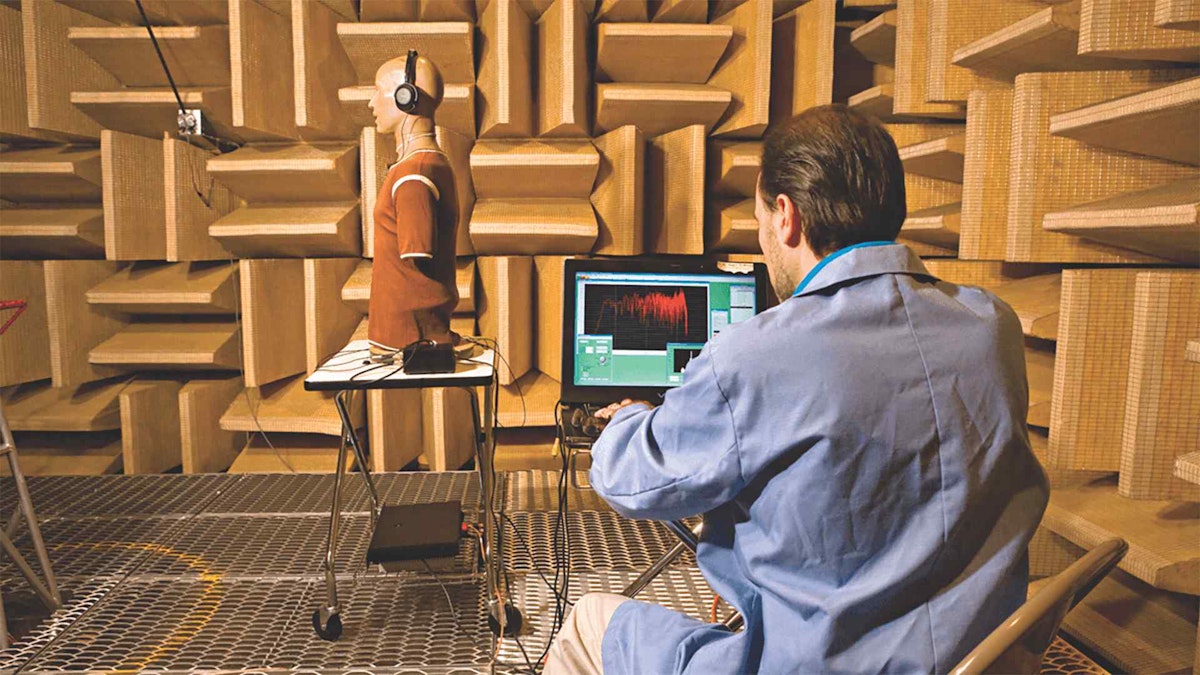
อัตราส่วนสัญญาณต่อเสียงรบกวน เป็นตัวพยากรณ์ความแม่นยำในการถอดความที่มีพลังมากที่สุดเพียงตัวเดียว และมันพังทลายได้อย่างรวดเร็ว งานวิจัยที่ตีพิมพ์ใน Speech Communication แสดงให้เห็นว่า อัตราคำผิดพลาดสามารถพุ่งขึ้น จากต่ำกว่า 5% บนเสียงที่สะอาดไปจนถึงสูงกว่า 30% เมื่ออัตราส่วนสัญญาณต่อเสียงรบกวนลดลงต่ำกว่า 10 dB ซึ่งเป็นระดับที่อธิบายถึงออฟฟิศธรรมดาที่เปิดเครื่องปรับอากาศ หรือการรับสายโทรศัพท์ในห้องครัว เสียงสะท้อนในห้องยิ่งซ้ำเติมเรื่องนี้: เสียงที่สะท้อนทำให้พยัญชนะหลอมรวมกัน และโมเดลได้รับสำเนาของแต่ละหน่วยเสียงสองชุดในเวลาที่ต่างกันเล็กน้อย ก่อให้เกิดข้อผิดพลาดจากการตัดทิ้งซึ่งไม่มีการประมวลผลหลังใด ๆ ที่กู้คืนได้อย่างสมบูรณ์
การวางไมโครโฟนเป็นตัวแปรที่คนส่วนใหญ่ประเมินต่ำเกินไป ไมโครโฟนแล็ปท็อปที่บันทึกผู้พูดที่อยู่ห่างออกไปสองเมตรในห้องที่ไม่ได้ปรับสภาพเสียง เป็นประเภทสัญญาณที่แตกต่างโดยพื้นฐานจากอินพุตแบบไมโครโฟนระยะใกล้และไร้เสียงสะท้อนที่เกณฑ์มาตรฐานใช้
นี่คือจุดที่การเลือกโหมดมีความสำคัญในทางปฏิบัติ Cockatoo มีสองโหมดการถอดความ V4-Flash ถอดความได้เร็วถึง 120 เท่าของเวลาจริง และฟรีไม่จำกัด V4-Pro เป็นโหมดที่แม่นยำที่สุด ทำงานที่ประมาณ 20 เท่าของเวลาจริง และเพิ่มป้ายกำกับผู้พูด บัญชีฟรีได้รับการพรีวิว V4-Pro รายสัปดาห์ ดังนั้นคุณจึงเปรียบเทียบทั้งสองโหมดบนไฟล์บันทึกที่บันทึกในห้องของคุณเองก่อนตัดสินใจว่าเสียงของคุณต้องการโหมดใด
Pro ประมวลผลไฟล์บันทึกทั้งไฟล์ใน V4-Pro พร้อมขีดจำกัดการใช้งานที่สูงขึ้นและการประมวลผลแบบลำดับความสำคัญ แผนปัจจุบันอยู่บนหน้าราคา
2. สำเนียงของผู้ไม่ใช่เจ้าของภาษาและการแปรผันของภาษาถิ่น - ทำไมข้อผิดพลาดแบบแทนที่จึงพุ่งสูงนอกคลังข้อมูลสำเนียงส่วนใหญ่

ความแม่นยำในการถอดความภาษาพูดภาษาอังกฤษของผู้ไม่ใช่เจ้าของภาษาแตกต่างอย่างมีนัยสำคัญจากตัวเลขพาดหัว งานวิจัยอุตสาหกรรมพบว่าระบบ ASR ชั้นนำห้าระบบสร้างอัตราความผิดพลาดสำหรับผู้พูดภาษาอังกฤษแบบแอฟริกันอเมริกันสูงเป็นสองเท่าของผู้พูดภาษาอังกฤษแบบผิวขาวอเมริกัน และความเหลื่อมล้ำที่เกี่ยวกับสำเนียงสำหรับผู้ไม่ใช่เจ้าของภาษายิ่งกว้างยิ่งขึ้นไปอีก รูปแบบความล้มเหลวคือข้อผิดพลาดแบบแทนที่: คำที่ฟังดูสมเหตุสมผลในบริบทแต่ผิด ดังนั้นจึงรอดพ้นจากการอ่านผ่าน ๆ และทำลายบันทึกอย่างเงียบ ๆ
งานวิจัยอุตสาหกรรมพบว่าระบบ ASR ชั้นนำห้าระบบสร้างอัตราความผิดพลาดสำหรับผู้พูดภาษาอังกฤษแบบแอฟริกันอเมริกันสูงเป็นสองเท่าของผู้พูดภาษาอังกฤษแบบผิวขาวอเมริกัน และความเหลื่อมล้ำที่เกี่ยวกับสำเนียงสำหรับผู้ไม่ใช่เจ้าของภาษายิ่งกว้างยิ่งขึ้นไปอีก
บทสัมภาษณ์ที่บันทึกในร้านกาแฟกับผู้พูดภาษาอังกฤษที่ไม่ใช่เจ้าของภาษาสองคนมักจะให้ความแม่นยำในระดับสูงช่วง 70 ปลาย ๆ จากเครื่องมือที่โฆษณาไว้ที่ 99% ช่องว่างนี้เป็นผลเชิงโครงสร้างจากคลังข้อมูลฝึกฝนที่ถ่วงน้ำหนักไปทางเสียงพูดที่บันทึกในสตูดิโอและเป็นสำเนียงส่วนใหญ่ Cockatoo ถอดความ 36 ภาษา และอัตราความผิดพลาด V4-Pro ต่อภาษาของมัน บน FLEURS และบนไฟล์บันทึกในโลกจริง เผยแพร่บนหน้าเกณฑ์มาตรฐาน ซึ่งเป็นที่ที่เหมาะสมในการตรวจสอบภาษาของคุณก่อนบันทึกไฟล์สำหรับงานเฉพาะทาง
เมื่อได้ทรานสคริปต์ที่แม่นยำอยู่ในมือแล้ว การทำให้มันอยู่ในรูปแบบที่เพื่อนร่วมงานสามารถเปิดและแก้ไขได้จริงคือจุดติดขัดถัดไป Cockatoo ส่งออกเป็น PDF และ DOCX ได้โดยตรง ทรานสคริปต์จึงกลายเป็นไฟล์ Word หรือ PDF ที่คนอื่นแก้ไขได้โดยไม่ต้องมีขั้นตอนแปลงไฟล์ รายละเอียดที่ฟังดูเล็กน้อยนี้จะชัดเจนขึ้นเมื่อคุณเคยลองดึงไฟล์ข้อความธรรมดาออกมาเป็นเอกสารที่มีการจัดรูปแบบภายใต้กำหนดเวลา
3. อัตราความผิดพลาดในการแยกผู้พูด (DER) - ชั้นความแม่นยำที่ซ่อนอยู่ซึ่งผู้ขายแทบไม่เคยเปิดเผย
อัตราความผิดพลาดในการแยกผู้พูด (DER) วัดว่าความแม่นยำของระบบในการกำหนดแต่ละคำให้กับผู้พูดที่ถูกต้องเป็นอย่างไร คำนวณจากผลรวมของคำพูดที่พลาด การตรวจจับผิดพลาด และความสับสนของผู้พูด หารด้วยเวลาคำพูดอ้างอิงทั้งหมด เกณฑ์มาตรฐานอุตสาหกรรมจากการบันทึกการประชุมที่มีผู้พูดหลายคนจากแหล่งเช่น การประเมิน NIST Rich Transcription แสดงตัวเลข DER ที่ 15-30% บนเสียงที่มีการพูดทับซ้อนหรือคุณภาพระดับโทรศัพท์ หมายความว่าในการเสวนากลุ่มสี่คน อาจมีคำถึงสามคำในสิบคำถูกกำหนดให้กับผู้พูดผิดคน
ผู้ขายแทบไม่เคยเปิดเผย DER ควบคู่กับ WER ผลก็คือทรานสคริปต์อาจดูแม่นยำในระดับคำแต่ใช้งานไม่ได้ในเชิงโครงสร้าง ประโยคถูกแบ่งกลางความคิดข้ามผู้พูดผิดคน รายการสิ่งที่ต้องทำถูกกำหนดให้กับคนผิด และภาระในการทำความสะอาดที่นักวิจัยในงานสัมภาษณ์เชิงคุณภาพอธิบายอย่างสม่ำเสมอว่าแย่กว่าการพิมพ์ใหม่ตั้งแต่ต้น
4. คุณภาพเสียงเสื่อมแบบไม่เชิงเส้น - ทำไมความแม่นยำจึงไม่ลดลงอย่างราบรื่นและบางไฟล์ต้องเขียนใหม่ทั้งหมด
ความแม่นยำไม่ได้ลดลงอย่างราบรื่นเมื่อสภาวะแย่ลง มันคงอยู่แล้วจึงแตกออก
งานวิจัยเกี่ยวกับความทนทานของ ASR แสดงให้เห็นผลกระทบแบบเกณฑ์: โมเดลรักษาความแม่นยำใกล้ระดับเกณฑ์มาตรฐานจนกว่าคุณภาพสัญญาณจะเสื่อมลงถึงจุดวิกฤต ซึ่งแบบจำลองเสียงจะสูญเสียความมั่นคงและอัตราความผิดพลาดพุ่งสูงขึ้นอย่างรวดเร็วแทนที่จะเพิ่มขึ้นตามสัดส่วนของเสียงรบกวนที่เพิ่ม ผลในทางปฏิบัติคือไฟล์ที่ฟังดู "ค่อนข้างหยาบ" สำหรับหูมนุษย์อาจอยู่เลยจุดวิกฤตนั้นไปเพียงเล็กน้อย ทำให้ได้ทรานสคริปต์ที่ต้องเขียนใหม่ทั้งหมดแทนการแก้ไขเล็กน้อย ผู้ถอดความรายบุคคลส่วนใหญ่จะค้นพบสิ่งนี้หลังอัปโหลด รอ และเปิดผลลัพธ์แล้วเท่านั้น
แผน Pro ของ Cockatoo รองรับความยาวไฟล์ไม่จำกัด ไฟล์หลายชั่วโมงจึงอัปโหลดได้ทั้งไฟล์ อัปโหลดไฟล์เสียงหรือวิดีโอใดก็ได้และรับทรานสคริปต์ที่แก้ไขได้กลับมา บน V4-Pro ระบบตรวจจับผู้พูดโดยอัตโนมัติ และการเปลี่ยนชื่อผู้พูดในตัวแก้ไขจะอัปเดตทุกบรรทัด

ทรานสคริปต์มาพร้อมเวลาประทับระดับคำและการเว้นวรรคอัตโนมัติ หลักฐานความแม่นยำอยู่บนหน้าผลทดสอบมาตรฐานที่เผยแพร่ (FLEURS แยกตามภาษาและผลลัพธ์โลกจริงสำหรับ 36 ภาษา พร้อมวิธีการ) แทนที่จะเป็นเพียงเปอร์เซ็นต์เปล่าๆ
ความยาวไฟล์ไม่จำกัดมีความสำคัญตรงนี้ เพราะการบันทึกที่ยาวขึ้นซึ่งมีโอกาสทางสถิติสูงกว่าที่จะมีสภาวะเสียงที่แปรผันตลอดทั้งไฟล์ คือไฟล์ที่มีแนวโน้มสูงสุดที่จะถึงจุดเสื่อมแบบไม่เชิงเส้นกลางทาง การอัปโหลดได้โดยไม่ตัดทอนไฟล์หมายความว่าโมเดลเห็นบริบททั้งหมดแทนที่จะเป็นเวอร์ชันที่ถูกตัดซึ่งอาจเริ่มหรือจบกลางประโยค
5. คำพูดทับซ้อนและการรบกวนข้ามช่อง - เสียงที่พูดพร้อมกันทำลายความสมบูรณ์ของสัญญาณตั้งแต่ต้นทางอย่างไร

เมื่อผู้พูดสองคนพูดพร้อมกัน ปัญหานี้ไม่ใช่ข้อจำกัดของซอฟต์แวร์ แต่เป็นปัญหาทางฟิสิกส์ ไมโครโฟนรับรูปคลื่นผสมเพียงหนึ่งเดียว และไม่มีโมเดลใดสามารถแยกเสียงสองเสียงที่อยู่ในช่วงความถี่เดียวกันในขณะเดียวกันได้อย่างสมบูรณ์ การบันทึกการเสวนาที่มีเสียงทับซ้อนสี่เสียงซึ่งการแยกผู้พูดแบ่งประโยคกลางความคิดข้ามผู้พูดผิดคนล้มเหลวเพราะความสมบูรณ์ของสัญญาณถูกทำลายตั้งแต่ต้นทาง
การรบกวนข้ามช่องในการบันทึกการโทรและการประชุมทางวิดีโอสร้างความเสียหายเป็นพิเศษ เพราะตัวเข้ารหัสบีบอัดที่ใช้ในกระบวนการเหล่านั้นทำให้ส่วนที่ทับซ้อนเสื่อมลงอีก ทำให้โมเดลได้รับอินพุตที่เสื่อมสภาพแล้วก่อนที่ปัจจัยด้านความแม่นยำที่ส่งผลต่อการถอดความจะเข้ามาเกี่ยวข้องเสียอีก
สำหรับการบันทึกวิดีโอที่มีการพูดทับซ้อนกัน ความต้องการปลายทางมักเป็นไฟล์คำบรรยายหรือคำบรรยายใต้ภาพที่เผยแพร่แล้ว มากกว่าจะเป็นไฟล์ถอดความสำหรับการแก้ไข Cockatoo ส่งออก ไฟล์คำบรรยาย ใน SRT และ VTT ในทุกแพ็กเกจ พร้อมกับ DOCX, PDF, TXT, CSV และ JSON และการส่งออกแบบเป็นกลุ่มมีให้ใน Pro ดังนั้นผลลัพธ์ที่แก้ไขแล้วสามารถส่งตรงไปยังวิดีโอได้เลยโดยไม่ต้องแปลงแยกต่างหาก
6. คำศัพท์เฉพาะทางและศัพท์เทคนิค - ช่องว่างทางคำศัพท์ที่ทำให้อัตราความผิดพลาดของคำสูงขึ้นในการบันทึกเฉพาะทาง
โมเดล ASR ทั่วไปได้รับการปรับให้เหมาะกับคำศัพท์ในชีวิตประจำวันและมีปัญหากับศัพท์ทางการแพทย์ กฎหมาย วิทยาศาสตร์ หรือเฉพาะอุตสาหกรรม เมื่อผู้พูดใช้ศัพท์เฉพาะทาง โมเดลจะแทนที่ด้วยคำทั่วไปที่ใกล้เคียงทางเสียงที่สุด ทำให้เกิดข้อผิดพลาดที่ตรวจจับได้ยากขึ้นเมื่อตรวจทานเพราะอ่านแล้วดูสมเหตุสมผล สำหรับผู้เชี่ยวชาญที่ถอดความเนื้อหาเฉพาะทาง ช่องว่างทางคำศัพท์นี้เป็นปัจจัยที่ทำให้ความแม่นยำในการถอดความลดลงอย่างสม่ำเสมอและถูกรายงานน้อยเกินไป ซึ่งคะแนน WER บนเสียงที่สะอาดปิดบังไว้อย่างสิ้นเชิง
ความแม่นยำในการถอดความที่ดีจริง ๆ มีหน้าตาอย่างไรในกรณีการใช้งานต่าง ๆ
ข้อกำหนดด้านความแม่นยำไม่ได้มีเกณฑ์เดียว เกณฑ์ที่ทำให้บันทึกเสียงส่วนตัวใช้งานได้อย่างสมบูรณ์แบบอาจทำให้เจ้าหน้าที่กำกับดูแลถูกไล่ออก ระดับความแม่นยำที่เครื่องมือถอดความต้องส่งมอบจริงนั้นแปรผันตามความรุนแรงที่คำผิดเพียงคำเดียวสามารถลุกลามไปยังปลายทางได้ ดังนั้นตัวเลขที่ผู้ขายโฆษณาไว้จึงทำให้เข้าใจผิดสำหรับผู้ใช้บางกลุ่ม
กับดักหนึ่งที่ถูกมองข้าม: เมตริก Word Error Rate มาตรฐานสามารถโกหกได้ด้วยการละเว้น เครื่องมือที่ตัดเสียงพูดทับซ้อนออกอย่างเงียบ ๆ โดยข้ามผู้พูดที่พูดทับกันแทนที่จะพยายามถอดความ จะรายงาน WER ที่ต่ำกว่าเครื่องมือที่พยายามและบางครั้งก็ถอดความบทสนทนาเหล่านั้นผิดเพี้ยน เครื่องมือแรกดูแม่นยำกว่าบนกระดาษแต่ส่งมอบการประชุมจริงของคุณได้น้อยกว่า
1. ความแม่นยำ 80-90% - ระดับขั้นต่ำที่ยอมรับได้สำหรับบันทึกทั่วไปและการป้อนคำสั่งส่วนตัว
บันทึกทั่วไปและการป้อนคำสั่งส่วนตัวยอมรับความแม่นยำระดับ 80-90% ได้ เพราะต้นทุนของคำที่พลาดนั้นต่ำและการแก้ไขก็รวดเร็ว รายการซื้อของที่มีสองรายการเพี้ยนถือเป็นเรื่องน่ารำคาญเล็กน้อย ผู้ปฏิบัติงานที่ใช้ระบบเสียงเป็นข้อความสำหรับการจัดการความรู้ส่วนตัวพบเสมอว่าการแก้ไขข้อผิดพลาดไม่กี่จุดต่อย่อหน้าไม่ได้ลบเวลาที่ประหยัดได้จากการบันทึก ขีดจำกัดที่แท้จริงในระดับนี้คือภาระทางความคิด ไม่ใช่ความแม่นยำ
แม้ในระดับนี้ ปัญหาความน่าเชื่อถือที่ละเอียดอ่อนก็ทำให้ผู้ใช้หลายคนสะดุด: ช่วงเริ่มต้นที่ประสิทธิภาพสูงตามด้วยการลดลงของความแม่นยำอย่างอธิบายไม่ได้ เมื่อเกิดขึ้น สัญชาตญาณคือการสันนิษฐานว่าคุณภาพเสียงเปลี่ยนไป ในขณะที่สาเหตุที่แท้จริงมักเป็นการเปลี่ยนโหมดหรือเส้นทางการประมวลผล หน้าการวัดประสิทธิภาพ ของ Cockatoo เผยแพร่อัตราความผิดพลาด V4-Pro รายภาษา พร้อมวิธีการ เพื่อให้คุณตรวจสอบว่าภาษาของคุณทำงานอย่างไรก่อนตัดสินใจใช้เวิร์กโฟลว์ แทนที่จะค้นพบความไม่สอดคล้องหลังการลดลง
2. ความแม่นยำ 95%+ - มาตรฐานขั้นต่ำสำหรับการประชุมธุรกิจ พอดแคสต์ และคำบรรยายสื่อ
การประชุมธุรกิจ ไฟล์ถอดความพอดแคสต์ และคำบรรยายวิดีโออยู่ในระดับที่แตกต่างออกไป อัตราความผิดพลาดของคำที่ 4% ฟังดูเล็กน้อยจนกระทั่งทำให้ชื่อลูกค้าเพี้ยน ทำตัวเลขงบประมาณหาย หรือมอบหมายรายการสิ่งที่ต้องทำให้ผิดคน ทีมการตลาดที่ใส่คำบรรยายวิดีโอโซเชียล ยอมรับ WER ที่ 4% ได้ แต่ทีมที่ผลิตวิดีโอฝึกอบรมด้านการกำกับดูแลทำไม่ได้ ในระดับนี้ คำวิสามานยนามและตัวเลขเป็นเหยื่อรายแรกของความแม่นยำที่ลดลง และนั่นคือคำที่ขับเคลื่อนการตัดสินใจพอดี
เวิร์กโฟลว์การแก้ไขมีความสำคัญพอ ๆ กับความแม่นยำเริ่มต้น ในโปรแกรมแก้ไขบนเบราว์เซอร์ของ Cockatoo คุณจับชื่อที่อ่านผิดและแก้ไขป้ายกำกับผู้พูดได้โดยไม่ต้องประมวลผลไฟล์ใหม่ และการเปลี่ยนชื่อผู้พูดจะอัปเดตทุกบรรทัด สำหรับการบันทึกการประชุม Pro ยังมี Canvas สำหรับบทสรุปด้วย แทนที่จะอ่านซ้ำทั้งชั่วโมงเพื่อตรวจสอบทุกรายการสิ่งที่ต้องทำ คุณสามารถทำงานจากบทสรุปของสิ่งที่ต้องดำเนินการจริง ๆ แล้วเจาะเข้าไปในไฟล์ถอดความเฉพาะจุดที่ต้องแก้ไขเท่านั้น เวิร์กโฟลว์สองขั้นตอนนี้ทำให้ความแม่นยำระดับธุรกิจเป็นไปได้โดยไม่ต้องจ้างผู้ถอดความมนุษย์กับทุกไฟล์
3. 99%+ ความแม่นยำ - เกณฑ์ขั้นต่ำที่ไม่อาจต่อรองได้สำหรับการถอดความทางกฎหมาย การแพทย์ และการปฏิบัติตามข้อกำหนด
การถอดความทางกฎหมาย การแพทย์ และการปฏิบัติตามข้อกำหนดต้องการความแม่นยำ 99%+ โดยไม่มีข้อยกเว้นที่มีนัยสำคัญ คำเดียวที่สลับที่หรือฟังผิดสามารถเปลี่ยนความหมาย ก่อให้เกิดความรับผิด หรือทำให้บันทึกการถอดความไม่ผ่านการตรวจสอบด้านกฎระเบียบ งานวิจัยในอุตสาหกรรมระบุไว้อย่างชัดเจนว่า คำที่ไม่ถูกต้องเพียงคำเดียวสามารถเปลี่ยนความหมายของการวินิจฉัย แผนการรักษา หรือคำสั่งใช้ยา ในระดับนี้ เครื่องมือ AI ส่วนใหญ่ไม่สามารถรับประกันเกณฑ์ดังกล่าวกับเสียงจากสถานการณ์จริงได้ และช่องว่างระหว่างตัวเลขที่ผู้ขายโฆษณากับประสิทธิภาพจริงในภาคสนามคือจุดที่ความรับผิดเกิดขึ้น

ปัญหาการวัดค่า WER จะเห็นชัดที่สุดในกรณีนี้ หากเครื่องมือละเว้นการพูดสอดแทรกของผู้เชี่ยวชาญโดยไม่แจ้งเตือนในระหว่างการสนทนาของแพทย์หลายคน บันทึกการถอดความที่ได้อาจได้คะแนนอัตราความผิดพลาดที่ดี แต่กลับพลาดเนื้อหาที่มีความสำคัญทางคลินิกไปทั้งหมด ซึ่งเป็นผลลัพธ์ที่แย่กว่าบันทึกที่พยายามถอดข้อความนั้นและแจ้งความไม่แน่ใจไว้ การรู้ว่าเครื่องมือจัดการกับการพูดทับซ้อนอย่างไร ไม่ใช่แค่คะแนนความแม่นยำโดยรวม เป็นสิ่งจำเป็นก่อนจะไว้วางใจกับบันทึกที่มีความเสี่ยงสูง
4. การถอดความโดยมนุษย์ที่ 99%+: มาตรฐานที่ AI ต้องถูกวัดเทียบ
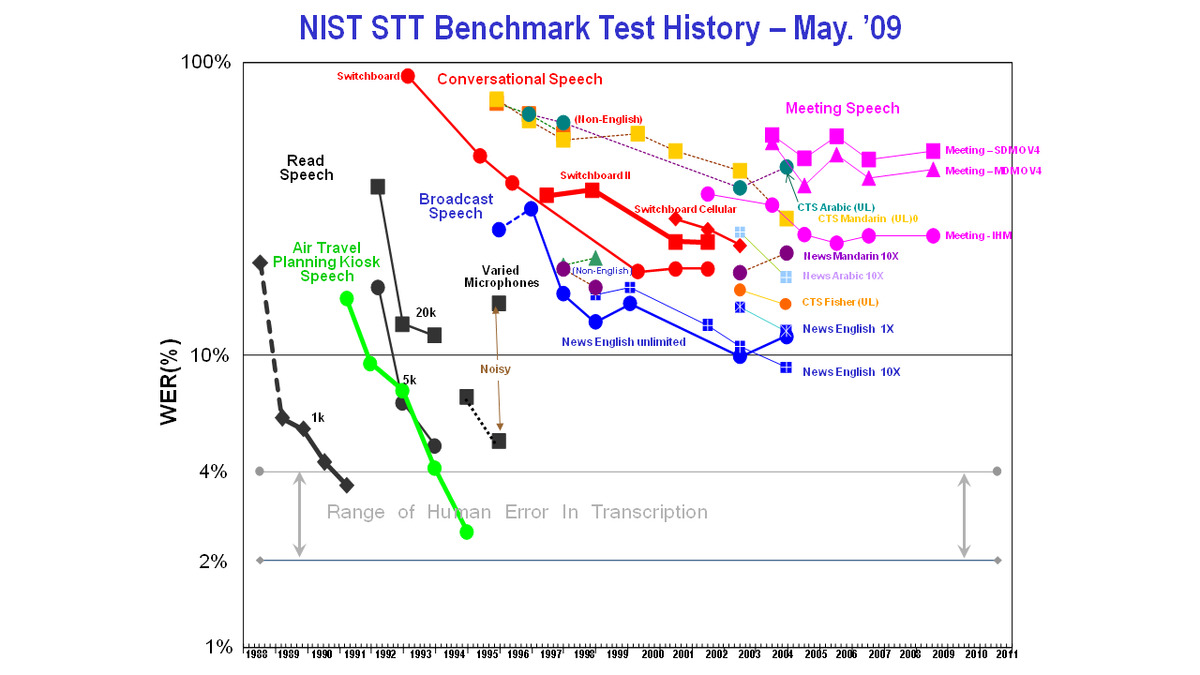
นักถอดความมนุษย์ที่มีทักษะสามารถทำความแม่นยำได้ 99%+ อย่างสม่ำเสมอ เพราะพวกเขาฟังซ้ำ อนุมานบริบท และปรับตัวเข้ากับสำเนียงในแบบที่แบบจำลองทางสถิติทำไม่ได้ นั่นคือมาตรฐานที่ AI ถูกวัดเทียบ และกับเสียงสตูดิโอที่สะอาด ช่องว่างได้แคบลงอย่างมีนัยสำคัญ แต่กับบันทึกที่มีสำเนียง มีเสียงรบกวน หรือมีผู้พูดหลายคน ช่องว่างจะกว้างขึ้นในแบบที่ผู้ใช้ไม่สามารถคาดเดาล่วงหน้าได้ การถอดความโดยมนุษย์เป็นทางเลือกที่ถูกต้องเมื่อบันทึกมีความเสี่ยงสูงจริง ๆ และสภาพเสียงแย่ แต่ก็เกินความจำเป็นสำหรับสรุปการประชุมธุรกิจฉบับร่างแรก
คำถามเชิงปฏิบัติสำหรับผู้ใช้ระดับโปรซูเมอร์และธุรกิจขนาดเล็กส่วนใหญ่คือ เครื่องมือที่พวกเขากำลังประเมินอยู่นั้นถูกทดสอบกับเสียงที่คล้ายกับบันทึกจริงของพวกเขาหรือไม่ Cockatoo กล่าวถึงระดับกลางโดยตรง: ผลลัพธ์จาก AI ใช้ได้ทันทีสำหรับโน้ตทั่วไปและร่างการประชุม และตัวแก้ไขในเบราว์เซอร์จัดการขั้นตอนแก้ไขระดับธุรกิจ ทำให้ชื่อ ตัวเลข และป้ายผู้พูดถูกต้องโดยไม่ต้องมีนักถอดความมนุษย์ในทุกไฟล์ ใน Pro สรุป Canvas หมายความว่าบันทึกยาวสามารถย่อเหลือเฉพาะสิ่งที่ต้องลงมือทำจริง ทำให้ขั้นตอนแก้ไขมีขอบเขตและรวดเร็วแทนที่จะเปิดกว้างไม่มีที่สิ้นสุด
ผู้ใช้สามารถตรวจสอบขั้นตอนการทำงานทั้งหมดนี้กับไฟล์ของตนเองได้ในแผนฟรี ด้วยการถอดความแบบเต็มความยาวไม่จำกัด ไม่มีขีดจำกัดรายวันและไม่ต้องใช้บัตรเครดิต พร้อมตัวอย่าง V4-Pro รายสัปดาห์ ก่อนตัดสินใจใช้แผนแบบเสียค่าใช้จ่าย Pro ประมวลผลบันทึกทั้งไฟล์ใน V4-Pro พร้อมป้ายผู้พูดและความยาวไฟล์ไม่จำกัด และเพิ่มสรุป Canvas ทำให้สามารถใช้งานบันทึกหลายชั่วโมงผ่านขั้นตอนการทำงานเดียวกันใน規模ได้จริง
การรู้เกณฑ์ของคุณเป็นเพียงครึ่งเดียวของสมการ คำถามที่ยากกว่าคือ เครื่องมือ AI ใด ๆ รวมถึงเครื่องมือที่โฆษณาตัวเลข 99% บนหน้าแรกของพวกเขา สามารถผ่านเกณฑ์นั้นได้จริงกับเสียงที่มีสำเนียง มีเสียงรบกวน และเฉพาะทางซึ่งอยู่ในโฟลเดอร์บันทึกของคุณหรือไม่ นั่นคือสิ่งที่ส่วนถัดไปจะวัด
บทความที่เกี่ยวข้อง
- ซอฟต์แวร์ถอดความที่ดีที่สุด
- ราคา Turboscribe
- การถอดความด้วย AI ภายในเครื่อง
- วิธีถอดความวิดีโอ
- การถอดความหลายภาษา
- การถอดความด้วย AI แบบออฟไลน์
ความแม่นยำของการถอดความด้วย AI เทียบกับการถอดความโดยมนุษย์บนเสียงที่คุณมีจริง
การเลือกระหว่างการถอดความด้วย AI และโดยมนุษย์ดูเหมือนเป็นการถกเถียงเรื่องคุณภาพ แต่จริง ๆ แล้วเป็นเรื่องของเงื่อนไข
บนเสียงสะอาด AI เกือบเทียบเท่านักถอดความมนุษย์
ตามการวิเคราะห์มาตรฐานของ VexaScribe เครื่องยนต์ AI ชั้นนำจับคู่หรือเกินกว่าค่าเฉลี่ยของนักถอดความมนุษย์ที่ประมาณ 4-5% WER บนบันทึกภาษาอังกฤษของผู้พูดคนเดียวที่สะอาด การสัมภาษณ์ 60 นาทีที่ได้ผลลัพธ์ที่ 3% WER ใช้เวลาประมาณ 15 นาทีในการตรวจทาน และช่องว่างประสิทธิภาพระหว่างเครื่องยนต์ที่ดีที่สุดกับที่แย่ที่สุดในกลุ่ม AI ชั้นนำอยู่ที่ประมาณ 3-5 จุด WER
ผลกระทบหนึ่งที่ถูกมองข้าม: สำหรับเนื้อหาวิดีโอที่สะอาด การบรรยาย การสาธิตผลิตภัณฑ์ เว็บบินาร์ที่บันทึกไว้ ความแม่นยำของ AI มักสูงพอที่ Cockatoo จะเปลี่ยนบทถอดเสียงเป็นไฟล์คำบรรยาย SRT หรือ VTT ได้ในไม่กี่วินาที พร้อมสำหรับการตรวจสอบอย่างรวดเร็วก่อนเผยแพร่
ช่องว่างกว้างขึ้นกับเสียงในโลกจริง เพราะมนุษย์อนุมานขณะที่ AI เดา
สำหรับการบันทึกในโลกจริง ภาพเปลี่ยนไป การวิเคราะห์ของ VexaScribe พบว่าในการประชุม สายโทรศัพท์ และคำพูดที่มีสำเนียง AI ตามหลังนักถอดเสียงมนุษย์ที่มีทักษะอยู่ 2-5% WER โมเดล AI จับคู่รูปแบบกับข้อมูลฝึก และเมื่อเสียงอยู่นอกการกระจายนั้น ความแม่นยำลดลงอย่างรวดเร็วและคาดเดาไม่ได้ ในขณะที่นักถอดเสียงมนุษย์อนุมานความหมายจากบริบท การผลิตบทถอดเสียงโดยมนุษย์ไม่ได้ทำให้มันแม่นยำ แต่มันทำให้มันถูกประพันธ์ ด้วยความสนใจเลือกสรรและการอนุมานทั้งหมดที่สื่อถึง
เวลาการแก้ไขคือต้นทุนแฝงที่ลบล้างข้อได้เปรียบด้านความเร็วของ AI บนเสียงที่ยาก
การสัมภาษณ์ 60 นาทีกับผู้พูดที่ไม่ใช่เจ้าของภาษาสองคนและมีเสียงรบกวนในพื้นหลังสามารถกลับมาจาก AI ที่ 14% WER
Canvas ของ Cockatoo ที่รวมอยู่กับ Pro ถูกสร้างมาเพื่อสิ่งนี้โดยเฉพาะ: แทนที่จะแก้ไขบทถอดเสียงยาวทีละคำ คุณใช้มันเพื่อสรุปการบันทึกให้เหลือเฉพาะสิ่งที่ต้องดำเนินการจริง ๆ
วิธีปรับปรุงความแม่นยำในการถอดเสียงก่อนที่คุณจะอัปโหลดไฟล์เดียว
การบันทึกในห้องที่มีเสียงรบกวนมอบปัญหาให้ทุกเอนจินถอดเสียงที่ไม่สามารถแก้ไขได้ทั้งหมด เครื่องมือได้รับสิ่งที่ไมโครโฟนบันทึกไว้ มันไม่สามารถสร้างข้อมูลคำพูดที่未被บันทึกอย่างสะอาดตั้งแต่แรกขึ้นมาใหม่ได้ นั่นคือเหตุผลว่าการปรับปรุงความแม่นยำที่มี leverage สูงสุดเพียงอย่างเดียวที่ผู้ใช้ทุกคนมีคือการตัดสินใจด้านฮาร์ดแวร์และสภาพแวดล้อมก่อนการบันทึก ไม่ใช่การตั้งค่าซอฟต์แวร์ที่เปิดใช้ตอนอัปโหลด
คนส่วนใหญ่คิดว่าวิธีแก้คือเครื่องมือที่ดีกว่า วิธีแก้จริงคือเสียงต้นทางที่ดีกว่า นี่คือหกขั้นตอนที่จับต้องได้ซึ่งสร้างความแตกต่าง
1. อัปเกรดไมโครโฟนก่อนที่คุณจะแตะการตั้งค่าซอฟต์แวร์ใด ๆ
Journal of Electrical and Electronic Engineering ยืนยันว่าไมโครโฟนแบบคาร์ดิออยด์ทำงานได้ดีกว่าแบบรอบทิศทางในสภาพแวดล้อมที่มีเสียงรบกวนโดยการลดทอนเสียงที่มาจากด้านข้างและด้านหลัง รักษาสัญญาณเสียงพูดที่อยู่ด้านหน้า ไมโครโฟนคอนเดนเซอร์ USB ราคา $50 ที่ชี้ตรงไปที่ผู้พูดให้สัญญาณที่สะอาดกว่าแก่เอนจินถอดเสียงใด ๆ ที่ไมโครโฟนแล็ปท็อปเคยทำได้ การใช้จ่ายเงินกับระดับการสมัครสมาชิกที่สูงขึ้นในขณะที่บันทึกด้วยฮาร์ดแวร์ในตัวเป็นการปรับแต่งปลายทางผิดของไปป์ไลน์
2. บันทึกในห้องเงียบเพื่อกำจัดตัวฆ่าความแม่นยำที่ใหญ่ที่สุด
เครื่องปรับอากาศ ถนนด้านนอก หรือพัดลมที่ทำงานอยู่สะสมเป็นข้อผิดพลาดตลอดการบันทึกทั้งหมด ปิดประตู ปิดสิ่งที่ส่งเสียงหึ่ง และบันทึกให้ห่างจากหน้าต่าง ยิ่งห้องเงียบเท่าไร ไมโครโฟนก็ยิ่งเก็บข้อมูลคำพูดได้มากขึ้น และเอนจินก็ยิ่งต้องเดาน้อยลง
3. ปิดเสียงการแจ้งเตือนและทำให้อุปกรณ์เงียบก่อนทุกเซสชันการบันทึก
เสียงกริ่งแจ้งเตือนนั้นสั้น แต่ผลกระทบนั้นไม่สมสัดส่วน เสียงเตือนเพียงครั้งเดียวที่ทับซ้อนกับคำพูดสามารถทำให้คำนั้นเสียหายทั้งหมด เพราะเอนจินสูญเสียจุดยึดความมั่นใจในขณะนั้นพอดี และคำรอบข้างมักได้รับผลกระทบด้วย ตั้งโทรศัพท์เป็นโหมดเงียบ ปิดแท็บเบราว์เซอร์ที่เล่นเสียงอัตโนมัติ และปิดเสียงระบบบนคอมพิวเตอร์ทุกเครื่องในห้องก่อนกดบันทึก สิ่งนี้ใช้เวลาตั้งค่าเพียงสามสิบวินาทีและมักประหยัดเวลาการแก้ไขหลายนาที
4. หลีกเลี่ยงลำโพงโทรศัพท์และไมโครโฟนแล็ปท็อปในตัวสำหรับการบันทึกจริงจังใด ๆ
เสียงสายโทรศัพท์ที่ประมวลผลผ่านโคเดกแบบแคบแบนด์จับช่วงความถี่ที่บีบอัดซึ่งตัดรายละเอียดเสียงที่เอนจินใช้แยกแยะคำที่ฟังคล้ายกันออก ไมโครโฟนแล็ปท็อปในตัวมีปัญหาเดียวกัน: มันเป็นแบบรอบทิศทางและวางไว้ห่างจากปากผู้พูด ดังนั้นมันจึงเก็บเสียงห้องได้พอ ๆ กับเสียงพูด ทั้งสองยอมรับได้สำหรับบันทึกสบาย ๆ ที่ข้อผิดพลาดเล็กน้อยมีความเสี่ยงต่ำ สำหรับการบันทึกใด ๆ ที่ชื่อ ตัวเลข หรือการตัดสินใจมีความสำคัญ ทั้งสองไม่ใช่อุปกรณ์บันทึกที่เชื่อถือได้
5\ กำหนดความคาดหวังด้านความแม่นยำก่อนรับไฟล์บันทึกภาคสนามหรือเสียงโทรศัพท์
หากมีคนส่งไฟล์บันทึกที่พวกเขาอัดด้วยโทรศัพท์ในคาเฟ่ที่วุ่นวาย เพดานความแม่นยำถูกกำหนดไว้แล้วก่อนที่คุณจะอัปโหลด ไม่มีเอนจินใด และไม่มีการปรับแต่งหลังอัปโหลดมากเท่าใด ที่จะกู้คืนข้อมูลเสียงที่ไม่เคยถูกบันทึกอย่างสะอาดได้ ก่อนรับไฟล์จากลูกค้าหรือเพื่อนร่วมงาน ให้ถามคำถามเดียว: มันถูกบันทึกใกล้ผู้พูดในพื้นที่เงียบหรือไม่? หากคำตอบคือไม่ ให้แจ้งล่วงหน้า การแก้ไขถอดความที่ไม่ดีใช้เวลานานกว่าการปรับความคาดหวังก่อนเริ่มงานมาก
6\ ตรวจสอบคุณภาพไฟล์บันทึกเก่าและไฟล์ archival ก่อนตัดสินใจถอดความ
ไฟล์บันทึกแบบเก่ามักมีสิ่งแปลกปลอม เสียงฮิสของเทป สัญญาณรบกวนจาก codec การบีบอัดแบนด์วิดท์ ซึ่งเอนจิน AI สมัยใหม่จัดการต่างจากนักถอดความมนุษย์ มนุษย์ฟังซ้ำและอนุมานจากบริบท ส่วนเอนจินส่งออกการคาดเดาทางสถิติที่ดีที่สุดแล้วไปต่อ ทำให้ข้อผิดพลาดรวมตัวกันอย่างเงียบ ๆ รอบท่อนที่คุณภาพต่ำ ก่อนอัปโหลดไฟล์ archival ให้เล่นกลับสามสิบวินาทีและฟังหาฮิส การตัดสัญญาณ หรือเสียงสะท้อน หากเสียงที่เล่นฟังดูแย่สำหรับหูคุณ มันจะอ่านได้แย่กว่าในบทถอดความ การอัดช่วงสั้น ๆ ใหม่เมื่อทำได้ หรือการแจ้งท่อนที่คุณภาพต่ำก่อนอัปโหลด ใช้เวลาเพียงไม่กี่นาทีและช่วยให้ไม่ต้องเขียนใหม่ทั้งหมด
ตัวเลขความแม่นยำเดียวที่ควรค่าแก่การเชื่อถือคือตัวเลขที่คุณตรวจสอบได้เอง
เปอร์เซ็นต์ Word Error Rate ที่ผู้ขายเผยแพร่มักวัดกับเสียงพูดภาษาอังกฤษที่บันทึกในสตูดิโอที่สะอาด ซึ่งเป็นเงื่อนไขที่แทบไม่คล้ายกับเสียงที่คุณภาพต่ำ หลายภาษา หรือเฉพาะโดเมนที่องค์กรส่วนใหญ่ทำงานอยู่จริง เกณฑ์มาตรฐานที่มีความหมายต้องระบุชุดทดสอบ ระบุภาษาและการกระจายสำเนียง และแยกประสิทธิภาพตามระดับคุณภาพเสียง แทนที่จะรวมทุกอย่างเป็นค่าเฉลี่ยในแง่ดีเพียงค่าเดียว
"ผู้ใช้ไม่สามารถตรวจสอบอย่างอิสระถึงคำกล่าวอ้าง 'ความแม่นยำดีขึ้น 40%' หรือ 'ความแม่นยำดีขึ้นมาก' ของ TranscribeX; ไม่มีเกณฑ์มาตรฐาน ไฟล์ทดสอบ หรือระเบียบวิธีใด ๆ ที่ให้ใครก็สามารถทำซ้ำได้เอง"
— สิ่งที่เราได้ยินจากผู้ใช้ซอฟต์แวร์ถอดความ
เกณฑ์มาตรฐาน Google FLEURS ครอบคลุมเสียงพูดที่บันทึกจริงใน 102 ภาษา ภายใต้เงื่อนไขมาตรฐาน ทำให้เป็นข้อมูลอ้างอิงภายนอกที่ทำซ้ำได้ซึ่งผู้ใช้ทุกคนสามารถตรวจสอบไขว้ได้ FLEURS เผยแพร่ชุดแบ่งการประเมินเฉพาะภาษา ดังนั้นอัตราความผิดพลาดระดับคำต่อภาษาบน FLEURS จึงเป็นคำกล่าวอ้างที่ตรวจสอบได้ ไม่ใช่ตัวเลขที่ผู้ขายเลือกภายใต้เงื่อนไขที่เอื้ออำนวย
โมเดลที่ทำงานได้ดีกับภาษาอังกฤษสำเนียงส่วนใหญ่สามารถให้อัตราความผิดพลาดสูงขึ้นอย่างมีนัยสำคัญกับภาษาอินโดนีเซีย อัสสัม หรือฝรั่งเศส โดยที่ตัวเลขพาดหัวไม่ขยับเลย การมีความแม่นยำที่ตรวจสอบได้ต้องมีสามสิ่งพร้อมกัน: เกณฑ์มาตรฐานที่ระบุชื่อ (FLEURS เข้าเกณฑ์) การแยกตามภาษาแทนที่จะเป็นตัวเลขรวม และเสียงทดสอบที่สะท้อนเงื่อนไขการบันทึกในโลกจริง
ทำไมการแลกเปลี่ยนระหว่างความแม่นยำกับความสามารถในการจ่ายจึงเป็นปัญหาทางเทคโนโลยี ไม่ใช่กฎฟิสิกส์
การเรียนรู้เชิงลึกที่ล้ำสมัย ซึ่งออกแบบมาเพื่อความเร็วและความแม่นยำ ทำให้ความแม่นยำสูงมีราคาที่จ่ายได้ในทุกระดับปริมาณ
Cockatoo เผยแพร่ผลลัพธ์รายภาษาสำหรับโหมด V4-Pro ของตนในทุก 36 ภาษา ที่ถอดความ พวกเขาวัดบน FLEURS และบนชุดข้อมูลภายในที่มนุษย์ติดป้ายกำกับจากการบันทึกในโลกจริง ให้คะแนนเป็น WER (CER สำหรับภาษาจีน ญี่ปุ่น เขมร และไทย) ด้วยการปรับมาตรฐานข้อความแบบโอเพนซอร์สของ OpenAI Whisper ช่องว่างที่บทความนี้อธิบายปรากฏในตัวเลขเหล่านั้นด้วย บนคลิปภาษาอังกฤษ FLEURS อัตราความผิดพลาดระดับคำของ V4-Pro คือ 3.9% บนไฟล์บันทึกภาษาอังกฤษในโลกจริง อยู่ที่ 10.4% ถึง 10.9% V4-Pro มีอัตราความผิดพลาดต่ำที่สุดในบรรดาผู้ให้บริการที่ทดสอบใน 25 จาก 36 ภาษาบน FLEURS แต่ไม่ใช่ในทุกภาษา: บนภาษาอังกฤษ FLEURS Universal-3.5 Pro ของ AssemblyAI ได้คะแนนต่ำกว่า ผลลัพธ์ วิธีการ และหมายเหตุว่าชุดข้อมูลโลกจริงเป็นการตรวจสอบแบบ in-sample อยู่บนหน้ากณฑ์มาตรฐาน ความแม่นยำแตกต่างกันตามภาษาและคุณภาพการบันทึก
วิธีทำการทดสอบตรวจสอบห้านาทีก่อนคุณสมัครสมาชิกกับสิ่งใด ๆ
นับข้อผิดพลาดเทียบกับสิ่งที่พูดจริง ๆ เกณฑ์มาตรฐานของผู้ขายบน FLEURS บอกคุณถึงขีดจำกัดล่าง คลิปของคุณเองบอกคุณถึงความเป็นจริง เกณฑ์มาตรฐานภายนอกร่วมกับการทดลองกับไฟล์จริงช่วยขจัดความไม่สมมาตรของข้อมูลที่ตัวเลขที่ผู้ขายรายงานเองยังคงไว้
บทความที่เกี่ยวข้อง
- แอปถอดเสียงที่ดีที่สุด
- Descript กับ Otter
- Fireflies กับ Otter
- Trint กับ Rev
- Happy Scribe กับ Rev
- คู่แข่งของ Otter.AI
ขั้นตอนถัดไป
หากการบันทึกของคุณยังคงได้ Transcript ที่ใช้เวลาแก้ไขนานกว่าการพิมพ์ใหม่ เส้นทางข้างหน้าจะเริ่มจากการตระหนักว่าตัวเลขความแม่นยำที่โฆษณาไว้นั้นไม่เคยถูกวัดกับเสียงแบบของคุณ เริ่มต้นด้วยซอฟต์แวร์ถอดเสียงของเรา
ผลกระทบของคุณภาพเสียงต่อความแม่นยำนั้นใหญ่กว่าความแตกต่างของเอนจินใด ๆ และช่องว่างระหว่างเครื่องมือ AI ที่ดีที่สุดกับแย่ที่สุดบนการบันทึกในโลกจริงนั้นลดลงเหลือ 3 ถึง 5 คะแนน WER ซึ่งเป็นระยะขอบที่เงื่อนไขการบันทึกเพียงอย่างเดียวสามารถเหวี่ยงได้มากกว่า นั่นหมายความว่าการเลือกเครื่องมือที่ "แม่นยำกว่า" โดยไม่ทดสอบกับไฟล์ของคุณเองก่อนคือการปรับแต่งตัวแปรที่ผิด ในขณะเดียวกัน ผู้ขายที่เผยแพร่ผลลัพธ์แยกตามภาษาบนชุดข้อมูลภายนอกมาตรฐานและให้คุณทดสอบกับเสียงของคุณเองก่อนจ่ายเงินได้ขจัดความไม่สมมาตรของข้อมูลที่ทำให้การอ้างความแม่นยำไม่สามารถตรวจสอบได้โดยการออกแบบนั้นอย่างเป็นระบบ
เงื่อนไขทั้งสองข้อนี้ร่วมกัน เกณฑ์มาตรฐานภายนอกบวกกับการทดลองกับไฟล์จริง เป็นเพียงการรวมกันเดียวที่ให้คุณตรวจสอบการอ้างสิทธิ์ได้แทนที่จะเชื่อมัน ร่วมกันแล้ว它們ชี้ไปยังขั้นตอนถัดไปที่ชัดเจนหนึ่งขั้น: นำเสียงของคุณเองไปผ่านเครื่องมือที่เผยแพร่ทั้งสองอย่าง
เริ่มต้นด้วยซอฟต์แวร์ถอดเสียงที่เผยแพร่เกณฑ์มาตรฐาน FLEURS แยกตามภาษาและไม่ต้องใช้บัตรเครดิตในการทดสอบ อัปโหลดคลิปจริงจากการบันทึกของคุณเอง เปรียบเทียบผลลัพธ์กับตัวเลขที่เผยแพร่สำหรับภาษาของคุณ และคุณจะได้ตัวเลขความแม่นยำเดียวที่ถ่ายทอดไปสู่เงื่อนไขการใช้งานจริงได้เสมอ
คำถามที่พบบ่อย
อัตราความแม่นยำ 95% หมายความว่าอย่างไรสำหรับ Transcript ของฉันในทางปฏิบัติ?
อัตราความแม่นยำ 95% หมายถึงข้อผิดพลาดประมาณ 25 ข้อในทุก ๆ Transcript ความยาว 500 คำ ซึ่งเพียงพอที่จะเรียกชื่อลูกค้าผิด ทำให้ตัวเลขเสียหาย หรือทำตกหล่นรายการดำเนินการสำคัญไปเลย บนการบันทึกจริงที่มีเสียงรบกวน สำเนียง หรือผู้พูดหลายคน ความแม่นยำมักลดลงอีก ไปอยู่ในช่วง 85 ถึง 92% ซึ่ง Transcript เดียวกันนั้นอาจมีข้อผิดพลาด 75 ข้อและต้องเขียนใหม่ทั้งหมดแทนที่จะแก้ไขเล็กน้อย
ทำไมผู้ขายถึงโฆษณาความแม่นยำ 98% หรือ 99% เมื่อ Transcript ของฉันกลับมาเต็มไปด้วยข้อผิดพลาด?
ผู้ขายทดสอบเครื่องมือของตนกับเสียงที่สะอาด คุณภาพสตูดิโอ ผู้พูดคนเดียว ชุดข้อมูลอย่าง LibriSpeech ที่ใช้ไมโครโฟนระดับมืออาชีพ ไม่มีเสียงรบกวนพื้นหลัง และไม่มีความหลากหลายของสำเนียง และไม่จำเป็นต้องเปิดเผยเงื่อนไขการทดสอบเหล่านั้น การสัมภาษณ์ การบันทึกสาย หรือการบันทึกการประชุมของคุณแทบจะแน่นอนว่าไม่ตรงกับเงื่อนไขเหล่านั้น ดังนั้นตัวเลขที่โฆษณาไว้จึงไม่ได้ถูกวัดกับเสียงแบบของคุณเลย
เสียงพูดที่ทับซ้อนกันแย่แค่ไหนจริง ๆ สำหรับเครื่องมือถอดเสียง?
เมื่อผู้พูดสองคนพูดพร้อมกัน ไมโครโฟนจะบันทึกคลื่นเสียงผสมเดียวที่ไม่มีโมเดลใดแยกออกได้สมบูรณ์ เพราะเสียงทั้งสอง occupy ช่วงความถี่เดียวกันพร้อมกัน มันเป็นปัญหาทางฟิสิกส์ ไม่ใช่ทางซอฟต์แวร์ นอกเหนือจากข้อผิดพลาดของคำที่เกิดขึ้น เกณฑ์มาตรฐานอุตสาหกรรมบนการบันทึกการประชุมที่มีผู้พูดหลายคนแสดงอัตราความผิดพลาดในการแยกผู้พูด (Diarization Error Rates) ที่ 15-30% บนเสียงที่ทับซ้อนหรือคุณภาพโทรศัพท์ หมายความว่าอาจมีถึงสามคำในสิบคำที่ถูกกำหนดให้ผู้พูดผิดในการสนทนากลุ่มสี่คน
Word Error Rate เหมือนกับเปอร์เซ็นต์ความแม่นยำที่แสดงบนหน้าแรกของผู้ขายหรือไม่?
ใช่ เปอร์เซ็นต์ความแม่นยำเป็นเพียง WER ที่กลับด้าน WER คำนวณจาก (การแทนที่ + การลบ + การเพิ่ม) หารด้วยจำนวนคำทั้งหมดใน Transcript อ้างอิง ดังนั้น WER 5% จึงกลายเป็นความแม่นยำที่อ้างว่า 95% ข้อผิดพลาดทุกประเภทนับเท่ากันในสูตร ซึ่งหมายความว่าการลบที่ทำให้คำว่า "ไม่" หายไปจาก "ห้ามดำเนินการ" มีต้นทุนเท่ากับการสะกดผิดเล็กน้อย และข้อผิดพลาดจะกระจุกตัวรอบช่วงที่ยากที่สุด คือเสียงพูดที่มีสำเนียง เสียงที่ทับซ้อน และคำศัพท์เฉพาะทาง แทนที่จะกระจายเท่า ๆ กันทั่ว Transcript
การบันทึกของฉันต้องแย่มากจริง ๆ ก่อนความแม่นยำจะพัง หรือมันลดลงทีละน้อย?
ความแม่นยำไม่ได้ลดลงอย่างราบรื่น มันคงอยู่ใกล้ระดับเกณฑ์มาตรฐานและจากนั้นก็แตกออกอย่างรวดเร็วเมื่อสัญญาณเสื่อมลงจนข้ามเกณฑ์วิกฤต งานวิจัยเกี่ยวกับความทนทานของ ASR แสดงให้เห็นว่าผลของเกณฑ์นี้หมายความว่าไฟล์ที่ฟังดู "หยาบเล็กน้อย" สำหรับหูของมนุษย์อาจเลยจุดที่อัตราความผิดพลาดพุ่งขึ้นอย่างรุนแรงไปแล้ว ส่งผลให้ได้บทถอดเสียงที่ต้องเขียนใหม่ทั้งหมดแทนที่จะแก้ไขเพียงเล็กน้อย






