9 개인 사용을 위한 최고의 오프라인 AI 전사 도구 2026
전사 도구를 선택하는 것은 사실 데이터 보관 결정입니다. "오프라인"이라는 라벨은 세 가지 매우 다른 아키텍처를 포괄하며, 그중 하나만이 실제로 오디오를 다른 사람의 서버 밖에 두지 않습니다.
소규모 사업체의 프로슈머 사용자, 흔히 녹음 파일을 텍스트로 변환하는 일을 맡은 단 한 사람의 흔한 가정은 "오프라인"이라고 표시된 도구를 선택하는 것만으로 해당 오디오를 보호하기에 충분하다는 것입니다. 오프라인은 자동으로 파일이 기기 밖으로 나가지 않는다는 뜻이기 때문입니다. 녹음 파일을 클라우드 전사 서버에 업로드할 때마다, 그 오디오는 그 안에서 말한 모든 사람의 명시적 동의 없이 기기 밖으로 나갑니다. 그것은 프라이버시 선호의 문제가 아닙니다.
그것은 데이터 보관권의 이전이며, 민감한 녹음을 다루는 사람이라면 누구에게나 그 결과는 측정 가능하고 문서화되어 있습니다. 대부분의 사람들은 전사 소프트웨어 선택을 편의성의 문제로 취급합니다. 진짜 질문은 업로드 버튼을 누른 후 누가 오디오의 보관권을 갖는가입니다.
이것이 실제로 어떻게 작동하는지는 저희 전사 소프트웨어를 참고하세요.
GDPR과 HIPAA 모두 데이터 처리 계약을 요구하며, 많은 경우 개인 오디오가 제3자 처리자에게 넘겨지기 전에 정보 주체의 명시적 동의를 요구합니다. 인터뷰 대상자가 미국 클라우드 제공업체에 자신의 음성이 처리되는 것에 결코 동의한 적이 없는 프리랜서 기자는 파일이 업로드되는 순간 이미 법적 위험을 만들어낸 것입니다. 유출이 실제로 발생했는지 여부와 무관합니다. 그 위험은 가상의 것이 아닙니다. 소비자 연구는 성인 약 3분의 1이 이미 자신의 데이터를 안전하게 보관하리라 신뢰했던 회사에서 데이터 유출을 경험했다는 것을 일관되게 보여줍니다. 클라우드 전사 서비스는 비즈니스 모델의 정상적인 일부로서 오디오를 수신하며, 다음에 무슨 일이 일어나는지는 당신의 가정이 아니라 그들의 서비스 약관이 규율합니다.
"오프라인"이라는 라벨은 시장 전반에 걸쳐 일관성 없이 적용됩니다. 일부 도구는 전체 모델 추론을 기기에서 실행합니다. 다른 도구는 오디오를 로컬에 캐시하지만 연결이 가능하면 클라우드 서버와 동기화합니다.
소수의 도구는 사용자에게 보이는 표시 없이 어려운 녹음을 클라우드 API로 조용히 라우팅합니다. 업계의 유출 탐지 연구는 대규모의 데이터 유출 사건이 내부 모니터링이 아니라 다크웹 시장이나 제3자 경고를 통해 데이터가 외부에 표면화된 후에야 발견된다는 것, 그리고 대부분의 조직이 민감한 데이터가 자신의 환경을 벗어나는지에 대한 실시간 가시성을 갖추지 못한다는 것을 일관되게 보여줍니다. 1인 사용자에게 그 가시성 격차는 전면적입니다.
이 가이드는 귀하의 데이터 보관 요건을 올바른 아키텍처에 맞추는 것을 중심으로 구성되었습니다. "오프라인"이라는 라벨은 최소 세 가지 구별되는 기술 아키텍처를 포괄하며, 그중 하나만이 오디오를 다른 사람의 서버 밖에 두지 않습니다.
핵심 요약
- 오프라인 전사 도구를 선택하는 것은 무엇보다 데이터 프라이버시 결정입니다. 질문은 인터넷 속도가 충분한지가 아니라, 오디오가 다른 사람의 서버에 닿는지 여부입니다.
- 오프라인으로 마케팅되는 많은 도구가 정확도가 어려워지면 클라우드 추론으로 전환하며, 이는 프라이버시 약속과 정확도 약속이 정확히 잘못된 순간에 조용히 함께 가기를 멈춘다는 것을 의미합니다.
- 모든 클라우드 전사 업로드는 누가 이를 처리하는지, 얼마나 보관되는지, 무엇을 훈련하는 데 사용되는지에 대한 명시적 공개 없이 오디오를 이전합니다.
- 온디바이스 추론은 전체 모델을 로컬에서 실행하므로 오디오 파일이 하드웨어를 벗어나지 않지만, 그 보장은 도구의 파이프라인이 첫 단계뿐만 아니라 모든 단계에서 완전히 로컬일 때만 유효합니다.
- Whisper 모델 크기는 정확도 극대화가 아닌 하드웨어 매칭의 문제입니다. 기기에 비해 너무 큰 모델을 실행하면 얻는 정확도 이득보다 오디오 분당 더 많은 시간을 잃게 됩니다.
- 오프라인 전사에 대해 공개된 단어 오류율 수치는 Whisper의 텍스트 정규화기가 구두점을 제거하고 비표준 형태를 매끄럽게 만든 후에 계산되므로, 실제 전사본에 가장 큰 피해를 주는 오류는 체계적으로 벤치마크에서 제외됩니다.
- 녹음이 기기에 남아 있을 필요가 없다면, Cockatoo 같은 클라우드 서비스가 실용적인 대안입니다. 일일 한도 없이 전체 길이 전사본 무료, 언어별 정확도 결과는 방법과 함께 공개되며, 데이터는 미국과 EU(핀란드)에서 저장 및 처리됩니다.
오프라인 AI 전사가 기술적으로 실제 의미하는 것
스스로를 오프라인이라고 부르는 대부분의 도구는 가장 중요한 순간, 즉 오디오가 처리되는 바로 그 시점에 여전히 본사 서버와 통신합니다.
온디바이스 추론 - 모델이 실제로 당신의 오디오에 하는 일
단 하나의 실행 항목을 찾기 위해 45분짜리 회의를 다시 재생하는 것은 정말로 비효율적이며, 바로 이 마찰이 오프라인 전사를 제대로 이해할 가치가 있게 만드는 지점입니다.
정확히 정의하자면, 오프라인 AI 전사는 전체 추론 파이프라인이 어느 단계에서도 네트워크 호출 없이 로컬 하드웨어에서 실행됨을 의미합니다. OpenAI의 Whisper에 대한 업계 데이터 분석에 따르면, 이 모델은 680,000시간의 다국어 오디오로 학습된 인코더-디코더 트랜스포머로서, 데이터가 기기를 떠나지 않은 채 로컬 CPU, GPU 또는 Apple Neural Engine에서 전적으로 음성-텍스트 추론을 수행합니다. 전사 실행 중에 실제로 일어나는 일은 다음과 같습니다: 오디오 파형이 30초 세그먼트로 분할되고, 각 세그먼트가 로그-멜 스펙트로그램으로 변환되며, 인코더는 그 스펙트로그램을 벡터 표현으로 매핑하고 디코더는 이를 사용해 토큰 시퀀스를 예측합니다.
680,000
Whisper가 학습한 오디오 시간
Cockatoo는 클라우드 서비스입니다: 당신의 오디오는 미국과 EU(핀란드)에 있는 서버에서 처리됩니다. 특정 녹음에 대해 클라우드 처리가 허용된다면, 무료 요금제는 신용카드가 필요 없고 일일 제한 없이 전체 길이의 전사본을 무제한으로 제공하므로, 같은 파일에 대한 로컬 Whisper 실행 결과와 출력을 비교할 수 있습니다. Pro에서는 Canvas가 긴 녹음을 실제로 조치가 필요한 내용으로 요약하여, 다시 재생하는 데 45분이 걸렸을 오디오 파일을 훨씬 짧은 시간에 결정 사항의 짧은 목록으로 바꿔 줍니다.
OpenAI의 Whisper와 Whisper.cpp가 거의 모든 오프라인 도구 내부의 엔진이 된 방법
OpenAI는 2022년 9월에 Whisper를 GitHub의 오픈소스 모델 가중치로 공개했으며, 무료로 다운로드하고 실행하고 수정할 수 있습니다. 이는 Neural Engine을 사용해 Apple Silicon에서 전체 로컬 AI 모델 추론을 실행하며, medium 및 large 모델 변형에서 실시간 계수(real-time factor)가 1.0보다 훨씬 낮아, 최신 MacBook에서 10분짜리 녹음이 10분 이내에 완료됩니다.
오프라인 상태를 유지할 필요가 없는 긴 녹음의 경우, Cockatoo의 Pro 요금제는 무제한 파일 길이를 지원하므로 여러 시간 분량의 대용량 업로드도 통째로 처리됩니다. 바로 이런 녹음이 전사로 가장 많은 시간을 절약하는 경우입니다: 수동으로 다시 재생하기에는 너무 긴 것들 말입니다.
본사 서버 통신 함정 - "인터넷 필요 없음"이 항상 생각하는 의미는 아닌 이유
"인터넷 필요 없음"이라는 표시는 도구가 연결 없이 작동할 수 있다는 것만 보장할 뿐, 연결이 있을 때 네트워크 호출을 절대 시도하지 않는다는 것을 보장하지는 않습니다.
가장 프라이버시가 필요한 오디오가 바로 업로드되는 오디오입니다.
클라우드 서비스인 Cockatoo는 지원하는 36개 언어에 대한 언어별 오류율을 벤치마크 페이지에 공개하므로, 사용자는 무엇이든 업로드하기 전에 성능을 확인할 수 있습니다. 이는 온디바이스 프라이버시와 클라우드 정확성 사이의 선택을 작은 글씨에 숨기지 않고 사용자의 손에 맡깁니다. 진정한 오프라인 전사가 로컬 하드웨어가 실제로 실행할 수 있는 것에 달려 있다는 것을 알았다면, 다음 질문은 실용적입니다: 10분짜리 녹음을 40분짜리 대기로 바꾸지 않고 당신의 특정 기기가 실행할 수 있는 Whisper 모델 크기는 무엇인가?
하드웨어에 맞는 올바른 Whisper 모델 크기를 선택하는 방법
다섯 가지 Whisper 등급과 각각이 당신의 기기에 실제로 요구하는 비용
RAM과 VRAM을 먼저 맞춰 올바른 Whisper 모델 크기를 선택하세요. Tiny와 Base 모델은 전용 GPU 없이 표준 RAM에서 실행됩니다. 어떤 기기에서도 사용할 수 있지만, 깨끗한 단일 화자 오디오를 넘어서면 눈에 띄게 더 높은 오류율을 보이며, 이는 실제 환경 비교를 수행하는 실무자들에 의해 널리 문서화된 한계입니다. Small과 Medium은 중간 지대를 차지하며, 적당한 하드웨어에서도 충분히 사용 가능하면서 의미 있게 더 나은 정확도를 제공합니다. Turbo와 Large-v3는 최고의 정확도를 제공하지만 시스템 메모리를 스래싱하지 않고 실행하려면 최소 8 GB의 GPU VRAM이 필요합니다.
| 모델 | 대략 필요한 VRAM / RAM | CPU에서의 속도 | 적합한 용도 |
|---|---|---|---|
| Tiny | ~1 GB RAM, GPU 불필요 | 매우 빠름 | 빠른 메모, 깨끗한 음성 |
| Base | ~1 GB RAM, GPU 불필요 | 빠름 | 일반적인 전사, 단일 화자 |
| Small | ~2 GB RAM 또는 GPU | 보통 | 일상적인 녹음, 대부분의 억양 |
| Medium | ~5 GB RAM 또는 GPU | 더 느림 | 억양이 있는 음성, 다국어 오디오 |
| Turbo | ~6 GB VRAM 권장 | GPU에서 빠름 | RTX 하드웨어에서 속도와 높은 정확도 |
| Large-v3 | ~8 GB VRAM 최소 | CPU에서 느림 | 기술적, 다국어, 잡음이 많은 녹음 |
Tinrec Blog의 3월 2026 모델 비교에 따르면, 충분한 VRAM 없이 Large 또는 Turbo를 실행하려고 하면 CPU가 이를 보완해야 하므로 실시간보다 느린 출력이나 메모리 부족 오류가 발생하고 정확도 이점이 모두 사라집니다.
하드웨어 우선 결정 규칙, 모델을 고르기 전에 RAM과 GPU를 먼저 맞추세요
결정 규칙은 간단합니다. 먼저 하드웨어의 한계를 찾은 다음, 그 한계 아래에 들어가는 가장 큰 모델을 고르세요. 16 GB Apple M3 MacBook Pro는 Apple Silicon이 추론을 Neural Engine으로 오프로드하기 때문에 Whisper Large-v3 를 문제없이 실행할 수 있습니다. 8 GB RAM을 갖춘 4년 된 Intel Core i5 의 실제 한계는 기껏해야 Small 또는 Medium입니다.
NVIDIA 하드웨어에서는 Turbo가 Large-v3 보다 더 현명한 선택인 경우가 많으며, RTX 3060 같은 중급 GPU에서 더 빠른 속도로 비슷한 정확도를 제공하므로, 별도 GPU가 있는 대부분의 Windows 노트북에 대한 기본 권장 사항입니다.
모델 등급을 올려야 할 때, 실제 전사에 영향을 미치는 정확도 차이
등급 간의 정확도 차이는 실제이지만 상황에 따라 다르며, Tinrec Blog의 3월 2026 분석에서도 이를 언급합니다. 조용한 환경에서 깨끗한 단일 화자 녹음의 경우, 실제로 Small이 Medium과 일치하는 경우가 자주 있습니다. Medium과 Large-v3 사이의 차이는 오디오가 기술적으로 밀도가 높거나, 다국어이거나, 억양이 심할 때만 의미가 있습니다.
하드웨어가 Medium을 안정적으로 유지할 수 없고, 녹음 파일을 기기 밖으로 내보내도 되는 사용자의 경우, Cockatoo 의 클라우드 전사는 자체 서버에서 실행됩니다. 그러면 출력 품질은 사용자의 노트북 RAM 용량이 아니라 모델과 오디오에 의해 결정되며, 이는 오프라인 도구가 없앨 수 없는 실질적인 한계입니다.
관련 읽을거리
- Best Transcription Software
- Turboscribe Pricing
- Local AI Transcription
- How To Transcribe A Video
- Multilingual Transcription
9 개인 사용을 위한 최고의 오프라인 AI 전사 도구를 플랫폼별로 순위 매기기
아홉 개의 도구, 세 개의 플랫폼, 그리고 실제로 중요한 한 가지 질문: 놓치기 쉬운 단계를 포함해 파이프라인의 모든 단계에서 오디오가 하드웨어에 남아 있는지 여부입니다.
이 가이드가 기반으로 하는 핵심 주장은 도구 비교를 시작하기 전에 분명히 밝힐 가치가 있습니다. 어떤 단일 "오프라인" 라벨도 구조적으로 프라이빗한 도구와 기본적으로 클라우드 선택 사항일 뿐인 도구를 확실히 구분하지 못합니다. 왜냐하면 도구는 기본 모델을 기기에서 실행하면서도 주변 파이프라인 단계인 구두점 복원, 화자 분리, 번역, 라이선스 핑, 텔레메트리를 외부로 조용히 라우팅할 수 있기 때문입니다. 즉, 진짜 민감한 오디오를 위해 도구를 평가하는 사용자는 최상위 "오프라인" 배지를 포괄적인 프라이버시 보장으로 받아들이지 말고 파이프라인의 각 기능을 독립적으로 감사해야 합니다.
"오프라인" 라벨은 원래 설계된 범위를 훨씬 넘어서는 역할을 하고 있습니다. Fraze의 9월 MacWhisper 비교에서 문서화했듯이, 도구는 핵심 추론 모델을 로컬에서 실행하면서도 클라우드 전사, 번역, AI 프롬프트 같은 선택 기능을 외부 서버를 통해 라우팅할 수 있습니다. 이 구분은 파이프라인이 완전히 감사 가능해야 하는 인터뷰 녹음, 법률 메모, 민감한 오디오 파일을 다루는 사람에게 매우 중요합니다. 도구의 프라이버시 보장은 구두점 복원, 화자 분리, 라이선스 핑, 텔레메트리를 포함한 파이프라인의 모든 단계가 검증 가능하게 로컬일 때만 유효합니다. 최상위 "오프라인" 배지를 포괄적인 보장으로 받아들이는 것이 바로 민감한 오디오를 위험에 빠뜨리는 실수입니다.
아래 아홉 개의 도구는 플랫폼별로 그룹화되어 있으며, 각 그룹 내에서는 그 더 엄격한 기준을 얼마나 깔끔하게 충족하는지에 따라 순위가 매겨져 있습니다.
1. MacWhisper - 비기술 사용자를 위한 최고의 macOS 네이티브 오프라인 AI 전사
MacWhisper가 최고의 macOS 자리를 차지하는 이유는 핵심 추론이 기본적으로 로컬에서 실행되며, 개인정보 보호 정책에서 익명 라이선스 확인 외에는 기기 밖으로 데이터가 나가지 않는다고 확인해 주기 때문입니다. 다만 Fraze의 문서는 분명히 밝히고 있습니다. 클라우드 전사, DeepL 번역, AI 프롬프트 기능은 활성화하면 데이터를 외부로 전송하므로, 개인정보 보호 보장은 이러한 선택 기능을 꺼 두어야만 유효합니다. 일회성 구매 가격은 약 64~65 유로이며 정기 구독이 없어, 사용자를 클라우드 요금제로 밀어붙이는 연간 갱신 부담이 없습니다. 하드웨어 주의사항: Parakeet 모델은 M 시리즈 Mac이 필요하고, Qwen3-ASR은 macOS 26가 필요하며, Medium 또는 Large Whisper 모델은 8 GB 이상의 RAM이 필요합니다. Intel Mac 사용자는 성능이 눈에 띄게 떨어질 수 있습니다.
2. Whisper.cpp - macOS 및 Linux 파워 유저를 위한 최고의 경량 CLI 도구
Whisper.cpp는 Apple Silicon의 Metal GPU 계층에 직접 컴파일되므로, MacBook Pro M3에서 클라우드 API에 맞먹는 속도로 Large-v3 모델을 실행할 수 있으며 어떤 단계에서도 네트워크 의존성이 전혀 없습니다. 대가로 드는 것은 설정 시간입니다. 터미널에서 소스로부터 빌드해야 하며, 처음에는 20~40분이 걸리고 명령줄 도구에 익숙해야 합니다. 실수로 켤 수 있는 선택적 클라우드 기능이 없어 외부 통신 위험은 사실상 제로입니다. 전체 모델 제어를 원하고 GUI 대신 감사 가능한 완전 로컬 추론 경로를 기꺼이 선택하려는 개발자와 연구자에게 최적입니다.
3. Wisper - Linux, Windows, macOS를 위한 최고의 크로스 플랫폼 오프라인 받아쓰기 도구
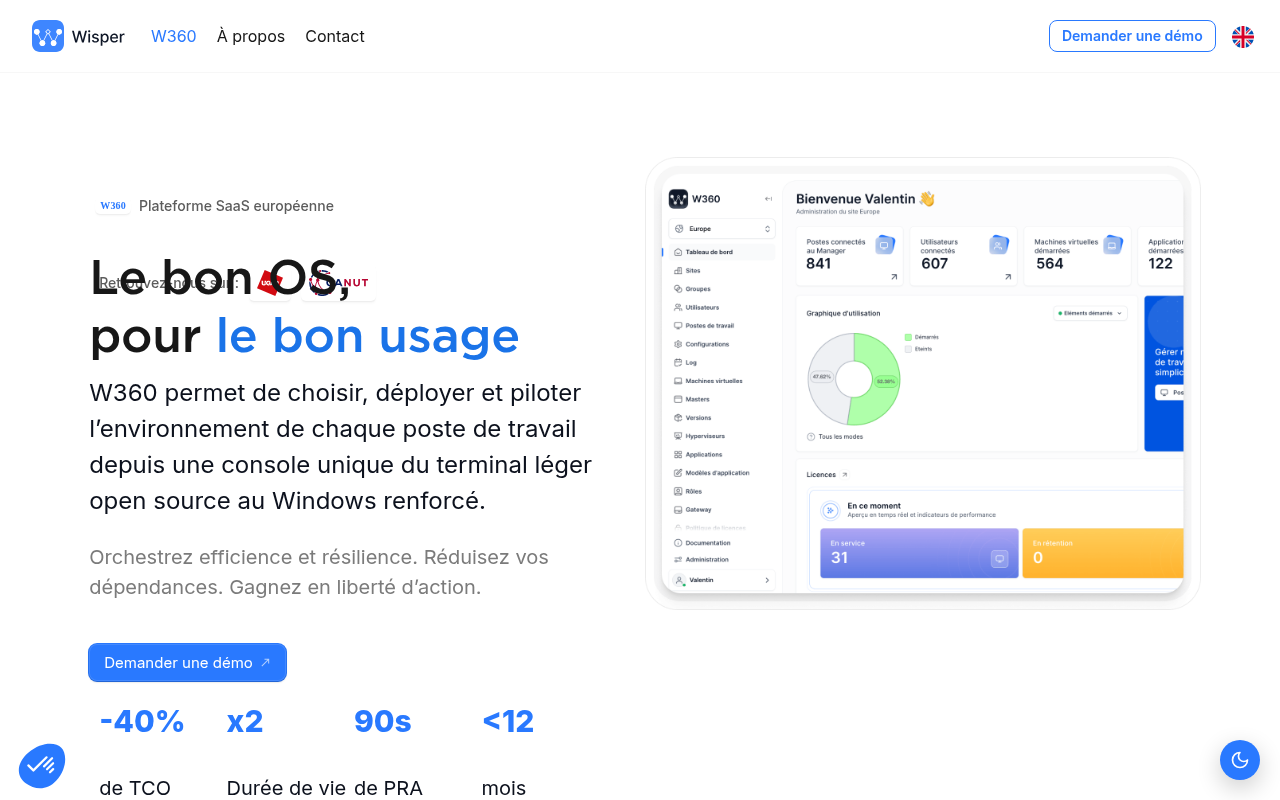
Wisper는 Whisper 추론을 GUI로 감싼 크로스 플랫폼 데스크톱 앱으로, 하나의 설치 프로그램으로 Windows, macOS, Linux를 지원하므로 여러 운영체제를 혼용하는 팀에게 가장 실용적인 선택입니다. 로컬 추론은 표준 구성에서 클라우드 폴백 경로 없이 전적으로 온디바이스에서 실행됩니다. Faster-Whisper와 비교한 대가는 순수 속도입니다. Wisper는 처리량보다 접근성을 우선하므로 대용량 파일 배치 처리에는 적합하지 않습니다. 전사 작업을 하는 사람이 개발자가 아니고, 어떤 노트북 앞에 있든 동일하게 작동하는 무언가가 필요할 때 적합한 선택입니다.
4. Faster-Whisper (Windows/Linux) - 대용량 파일을 위한 최고의 GPU 가속 오프라인 전사
Faster-Whisper는 CTranslate2을 사용해 Whisper를 재구현했으며, 동일한 하드웨어에서 원래 Python 구현보다 약 4~8배 빠른 추론과 더 낮은 VRAM 소비를 제공합니다. 이러한 속도 향상 덕분에 대용량 사용자, 전사 파이프라인, 하루에 몇 시간씩 오디오를 처리하는 사람들이 참조 구현 대신 이를 선택합니다. 모든 추론은 로컬에서 실행되며 핵심 라이브러리에는 클라우드 폴백이 없습니다. 설정에는 Python과 pip 환경에 대한 어느 정도의 친숙함이 필요하므로 비기술 사용자에게는 진입 장벽이 됩니다. Nvidia GPU, Linux 또는 Windows 머신이 있고, 처리 속도가 병목인 녹음이 충분히 많을 때 최적입니다.
5. mlx-whisper (Apple Silicon MCP Skill) - Mac의 Claude Code 워크플로를 위한 최고의 프라이버시 우선 전사
Mlx-whisper는 Apple의 MLX 프레임워크를 사용해 M 시리즈 Neural Engine에서 Whisper 모델을 네이티브로 실행하며, 이 기능을 Claude Code가 직접 호출할 수 있는 MCP 스킬로 노출합니다. 모든 추론 단계는 로컬에서 실행되며 전사 서비스로의 API 핸드오프가 없습니다. 좁지만 강력한 적합성입니다. 워크플로가 이미 Claude Code에 있고 해당 환경을 벗어나지 않으면서, 또는 오디오를 제3자 서비스로 라우팅하지 않으면서 전사가 필요하다면 mlx-whisper가 그 간극을 깔끔하게 메워 줍니다. 소비자용 앱이 아니며 Python 환경 설정이 필요하므로 비기술 사용자에게는 범위 밖입니다.
6. Offline Privacy Transcription (iOS/watchOS App) - iPhone 및 Apple Watch를 위한 최고의 모바일 오프라인 AI 전사
오프라인 개인정보 보호 전사는 iPhone과 Apple Watch에서 전적으로 기기 내에서 실행되며, 어느 단계에서도 서버 업로드가 없습니다. watchOS 통합은 드문 사례로, 시계에서 음성 메모를 캡처하고 전사가 기기를 떠나지 않도록 해주는데, 이는 휴대폰을 꺼내기 어려운 현장 인터뷰나 빠른 법률 메모에 중요합니다. 한계는 모델 크기입니다. 기기 내 모바일 추론은 휴대폰이나 시계의 메모리 제약 때문에 정확도를 일부 희생한 압축 모델을 사용합니다. 조용한 방의 깨끗한 오디오에서는 정확도가 뛰어납니다. 시끄러운 환경이나 강한 억양에서는 격차가 커집니다.
7. Whisper-Standalone-Win - Python 없이 Windows에서 최고의 플러그 앤 플레이 오프라인 전사
Whisper-Standalone-Win은 Whisper 모델과 모든 종속성을 단일 자체 포함 실행 파일로 패키징하여, Python이 설치되지 않은 Windows 사용자도 파일을 두 번 클릭하여 로컬 전사를 실행할 수 있습니다. 이러한 무종속성 설계는 개발자 툴체인을 설치할 수 없거나 설치하지 않으려는 소규모 비즈니스 사용자에게 핵심 차별점입니다. Python도, 패키지 관리자도, 터미널도 필요 없습니다. 외부 통신 위험은 낮습니다. 실행 파일에는 내장된 클라우드 폴백이 없습니다. 실질적인 제약은 GPU 지원입니다. CUDA 지원 Nvidia 카드는 처리를 크게 가속하지만, 구형 하드웨어에서 CPU 전용 전사는 긴 녹음 파일을 가진 사용자를 좌절시킬 만큼 느립니다.
8. Aiko - 간편함과 App Store 편의성을 위한 최고의 macOS 및 iOS 오프라인 전사 앱
Aiko는 Whisper를 전적으로 기기 내에서 실행하며 Mac App Store와 iOS App Store를 통해 배포됩니다. 즉, Apple의 샌드박싱 규칙이 개인정보 보호 정책이 약속하는 바를 강제합니다. 앱은 명시적인 사용자 허가 없이 임의의 네트워크 호출을 할 수 없습니다. 이러한 App Store 샌드박싱은 규제 환경의 독자에게 의미 있는 차별점입니다. 검증 부담을 "개발자의 정책을 신뢰"에서 "Apple의 강제 메커니즘을 신뢰"로 옮기기 때문입니다. Aiko는 간단한 끌어다 놓기 인터페이스, 진정한 로컬 추론, 그리고 문서를 읽지 않고도 감사 가능한 개인정보 보호 보장을 원할 때 올바른 선택입니다. 한계는 모델 유연성입니다. 모델 크기 메뉴가 아니라 Aiko가 제공하는 것을 그대로 얻습니다.
9. Vosk 오프라인 음성 인식 - 저전력 하드웨어 및 Linux 서버를 위한 최고의 경량 크로스 플랫폼 옵션
Vosk의 가장 작은 모델은 약 50 MB에서 시작하며 Raspberry Pi만큼 제약된 하드웨어에서 실행되므로, 진정한 에어갭 또는 저전력 서버 환경에서 작동하는 이 목록의 유일한 도구입니다. 20개 이상의 언어를 지원하며 GPU가 필요하지 않습니다. 외부 통신 위험은 0입니다. Vosk는 앱이 아니라 라이브러리이며 네트워크 호출을 하지 않습니다.
정확도 트레이드오프는 실제입니다. 저전력 하드웨어의 경량 모델은 최신 노트북의 Large Whisper 모델보다 더 많은 정리가 필요한 출력을 생성합니다. 제약된 인프라에서 전사 파이프라인을 운영하는 실무자에게는 그 트레이드오프가 수용 가능합니다. 단일 파일에서 클라우드에 가까운 정확도를 원하는 프로슈머에게는 그렇지 않습니다.
전사 후의 워크플로 격차 - 오프라인 도구가 처리하지 않는 것
이 목록의 대부분의 프로슈머는 같은 지점에 도달합니다. 텍스트 파일에 깔끔한 로컬 전사본이 있지만 다음 단계가 명확하지 않습니다. 다른 사람이 실제로 읽고, 편집하고, 행동할 수 있는 문서로 만들려면 두 번째 수동 작업이 필요하며, 그 복사-붙여넣기 단계는 로컬 도구가 절약한 시간을 조용히 상당 부분 지워버립니다.
그 마찰은 전사를 실제 업무일의 일부로 의존하는 사람들에게 가장 일관된 고통 지점 중 하나입니다. 회의 중에 수동으로 노트를 작성하는 것을 멈추거나 생각이 사라지기 전에 포착하는 것이 목표라면, 전사본과 완성된 문서 사이의 두 번째 수동 단계는 가장 필요 없는 것입니다. 오프라인 도구는 그 단계를 해결하지 않으며, 단지 그것이 일어나는 위치를 옮길 뿐입니다.
Cockatoo는 클라우드 도구로, 이 단계를 다르게 처리합니다. 파일이 전사되면 브라우저 편집기에서 전사본이 열리며, 여기서 이름을 수정하고, 화자를 한 번 이름 변경하여 모든 줄을 업데이트하고, 텍스트를 복사하지 않고도 DOCX, PDF, TXT, SRT, VTT, CSV 또는 JSON으로 내보낼 수 있습니다. Cockatoo는 36개 언어를 전사하며, 벤치마크 페이지에 언어별 결과가 있어 작업이 여러 언어에 걸쳐 있는 사용자에게 중요합니다. Pro에서는 Canvas가 전사본을 요약과 노트로 변환합니다. 오디오가 Cockatoo의 서버에서 처리되므로 오프라인으로 유지할 필요가 없는 녹음에 적합합니다.

비용 측면에서 이 비교는 분명히 언급할 가치가 있습니다. SpeechPulse와 같은 도구는 약 $99의 일회성 가격을 책정하는데, 이는 개인 사용자, 특히 그러한 가격이 일상적인 지역 외의 사용자에게 상당한 장벽입니다. Cockatoo의 무료 플랜은 비용이 전혀 들지 않고 신용카드도 필요 없습니다: V4-Flash에서 일일 제한 없이 무제한 전체 길이 전사본, 주간 V4-Pro 미리보기, 모든 내보내기 형식을 제공합니다. 화자 라벨은 V4-Pro와 함께 제공됩니다.
Canvas은 무료 플랜에서 사용해 볼 수 있습니다. Pro는 V4-Pro에서 전체 녹음을 실행하며, 화자 라벨, 우선 처리 및 무제한 파일 길이를 제공합니다. 현재 가격은 가격 페이지에 있습니다.
이 목록의 모든 도구는 전사본을 제공합니다. 그러나 어느 도구도 라벨에 광고하지 않는 것은 협조하지 않는 오디오, 즉 심한 억양, 겹치는 화자, 음향이 나쁜 방을 얼마나 우아하게 처리하는지입니다. 그것이 다음 섹션이 매핑하는 격차이며, 클라우드 지원 도구가 프라이버시 실패가 아니라 실용적인 선택인 정직한 사례들도 함께 다룹니다.
관련 읽기
오프라인 전사 정확도가 여전히 어려움을 겪는 곳과 그에 대한 대처법
Whisper의 텍스트 정규화기는 WER 점수가 계산되기 전에 구두점을 제거하고 철자를 표준화하며 비표준 형태를 매끄럽게 하므로, 억양이 있거나 잡음이 많은 오디오에서 가장 나타날 가능성이 높은 오류가 측정 전에 부분적으로 지워집니다. 이는 Benjamin Marie가 문서화한 대로, The Kaitchup에서 2023년 8월에 밝혔습니다.
"사용자는 고위험, 반복적 사용 사례(기업 회의, 로스쿨, 대학 강의, 가족 녹음)를 위해 오프라인 전사를 필요로 하며, 이러한 맥락에서의 정확도 실패는 실제 결과를 초래한다는 것을 암시합니다."
— 전사가 필요한 전문가와 학생들에게서 듣는 말
대형 Whisper 모델이 실제로 클라우드와 일치하는 곳과 그렇지 않은 곳
그러나 그 벤치마크 그림은 불완전합니다. 동일한 벤치마크 분석에서 훈련 데이터 표현이 희박해지는 심한 억양, 비표준 방언, 저품질 녹음에서 정확도 격차가 측정 가능하게 벌어진다는 사실이 발견되었기 때문입니다.
정확도 격차가 수동 전사보다 더 많은 시간을 소모할 때의 정리 패스 비용
1시간 길이의 녹음에서 10-15% 단어 오류율을 가진 전사본은 파일 전체에 수백 개의 잘못된 단어가 흩어져 있을 수 있습니다. 이러한 오류는 고르게 분포하지 않고, 모델이 이미 어려움을 겪는 오디오 조건 주변에 군집하여 수정 부담을 가중시킵니다. 지속적인 오류가 있는 60분 파일은 전사가 절약한 시간보다 더 많은 수정 시간을 쉽게 소모하여 도구의 효율성 이점을 완전히 지울 수 있습니다.
세 가지 완화 조치와 프라이버시 제어 클라우드 도구가 정직한 답인 경우
- RAM을 스래싱하지 않고 하드웨어가 지속할 수 있는 가장 큰 모델을 실행하세요.
- 전사 전에 오디오를 전처리하세요: 볼륨을 정규화하고, Audacity의 노이즈 감소 필터 같은 도구로 배경 소음을 줄이고, 무음을 다듬으세요. 더 깨끗한 입력은 동일한 모델에서 의미 있게 더 나은 출력을 생성합니다.
- 전체 파일에 착수하기 전에 실제 녹음 유형에서 대표적인 5분 클립으로 스팟 테스트하여, 정리 비용이 발생하기 전에 실제 오류율을 파악하세요.
해당 단계를 거쳐도 출력을 사용할 수 없고 녹음 파일이 기기 밖으로 나가는 것이 허용된다면, 정직한 답은 데이터가 어디로 가는지와 얼마나 정확한지를 명확히 밝히는 클라우드 도구입니다. Cockatoo는 미국과 EU(핀란드)에서 데이터를 저장·처리하며, 벤치마크 페이지에 방법론과 함께 공개된 언어별 정확도 결과를 통해 결정하기 전에 해당 언어의 성능을 확인할 수 있습니다. 정확도는 언어와 녹음 품질에 따라 달라지므로, 자신의 오디오 유형으로 직접 테스트하는 것이 여전히 중요합니다. 이 범주의 대부분 도구는 근거 데이터 없이 정확도만 주장하므로, 위에서 설명한 정리 패스 비용은 이미 파일에 시간을 투자한 뒤에야 드러납니다.
관련 읽을거리
다음 단계
민감한 녹음이 동의한 적 없는 서버에 계속 남는다면, 앞으로 나아갈 길은 "오프라인"을 라벨이 아닌 아키텍처 질문으로 다루는 데서 시작합니다. 핵심 추론은 로컬에서 실행하면서 구두점 복원, 화자 분리, 라이선스 핑을 외부로 라우팅하는 도구는 하이브리드 클라우드 제품과 동일한 실질적 노출을 제공하며, 그런 조용한 에스컬레이션을 가장 일으키기 쉬운 오디오는 전문가들이 가장 보호해야 하는 오디오입니다. 전사 소프트웨어부터 시작하세요.
하드웨어 우선 모델 선택 원칙은 사용 가능한 VRAM에 맞추지 않고 가장 큰 Whisper 변형을 선택하면 로컬 워크플로가 완전히 망가져, 사용자가 피하려 했던 바로 그 클라우드 폴백으로 밀려날 수 있음을 의미합니다. 벤치마크 상한 문제는 공개된 Word Error Rate 수치가 측정 전에 평활화되어, 억양이 있거나 노이즈가 많거나 기술적으로 밀도 높은 오디오에서 로컬과 클라우드의 정확도 격차가 어떤 사양서에도 나타나지 않은 채 벌어진다는 것을 의미합니다. 두 문제를 종합하면, 오프라인이든 아니든 어떤 도구를 선택하기 전에 자신의 대표 오디오로 테스트해야 한다는 결론에 이릅니다.
무료 계정으로 신용카드 없이 가장 어려운 오디오를 포함한 실제 파일을 업로드할 수 있는 전사 소프트웨어로 시작하세요. 출력이 실행 가능할 만큼 깨끗하다면, 비용을 지출하기 전에 실제 조건에서 도구를 검증한 것입니다.
자주 묻는 질문
오프라인 전사는 실제로 HIPAA를 준수하나요, 아니면 여전히 걱정해야 하나요?
HIPAA는 개인 오디오를 제3자 처리자에게 넘기기 전에 데이터 처리 계약과 많은 경우 명시적 대상자 동의를 요구하므로 아키텍처가 매우 중요합니다. 어떤 단계에서도 네트워크 호출 없이 전체 모델 추론을 로컬에서 실행하는 도구는 핵심 요구사항을 충족합니다. 오디오가 제3자 서버에 도달하지 않기 때문입니다. 반면 어려운 오디오에 대해 조용히 클라우드 API로 폴백하거나 화자 분리 같은 후처리 단계를 외부로 라우팅하는 도구는 HIPAA가 방지하도록 설계된 바로 그 노출을 만듭니다. 파이프라인은 주요 전사 단계뿐 아니라 모든 단계에서 완전히 감사 가능해야 합니다.
오프라인 전사는 Apple Silicon Mac에서 실제로 잘 작동하나요, 아니면 실용적이지 않을 만큼 느린가요?
Apple Silicon은 로컬 Whisper 추론에 가장 좋은 플랫폼 중 하나입니다. Whisper.cpp는 Apple Silicon의 Neural Engine을 사용해 전체 로컬 AI 모델 추론을 실행하며 medium 및 large 모델 변형에서 1.0보다 훨씬 낮은 실시간 계수를 달성합니다. 즉, 최신 MacBook에서는 10분 녹음이 10분 이내에 완료됩니다. 16 GB Apple M3 MacBook Pro는 Apple Silicon이 추론을 Neural Engine으로 오프로드하기 때문에 Whisper Large-v3을 문제없이 실행할 수 있습니다.
노트북에 실제로 어떤 Whisper 모델 크기를 설치해야 하는지 어떻게 알 수 있나요?
하드웨어 한계부터 시작하세요: 사용 가능한 RAM 또는 VRAM에 들어가는 가장 큰 모델을 찾은 다음, 그 정확도가 필요를 충족하는지 확인하세요. Tiny와 Base는 GPU 없이 표준 RAM에서 실행되지만 깨끗한 단일 화자 오디오를 넘어서면 더 높은 오류율을 보입니다; Small과 Medium은 적당한 GPU 자원이나 성능 좋은 CPU가 필요합니다; Large-v3는 최소 8 GB의 GPU VRAM이 필요합니다. 성능 좋은 하드웨어를 갖춘 대부분의 프로슈머에게 Medium은 솔직한 최적점이며, 하드웨어가 이를 감당하지 못하고 오디오가 기기를 떠날 수 있는 사용자의 경우 Cockatoo의 클라우드 전사는 자체 서버에서 실행되므로 출력 품질은 노트북의 RAM 용량이 아니라 모델과 오디오에 의해 결정됩니다.
도구가 "인터넷 필요 없음"이라고 하면, 그것은 제 오디오가 확실히 제 기기에 남는다는 뜻인가요?
아니요, "인터넷 필요 없음"이라는 표시는 도구가 연결 없이 작동할 수 있다는 것만 보장할 뿐, 연결이 있을 때 네트워크 호출을 절대 시도하지 않는다는 것은 아닙니다. 많은 도구는 오디오가 시끄럽거나 억양이 있을 때 조용히 클라우드 API 호출로 전환하며, 구두점 복원, 화자 분리, 언어 감지 같은 후처리 단계는 핵심 음향 모델이 로컬에서 실행되더라도 종종 서버 측에서 처리됩니다. 검증 단계는 실제 시끄러운 녹음 중에 패킷 캡처를 실행하여 전사 중 API 엔드포인트로 나가는 연결이 있는지 확인하는 것입니다.
화자 분리(diarization)는 로컬에서 처리되나요, 아니면 클라우드로 전송되나요?
화자 분리는 핵심 음향 모델이 로컬에서 실행되더라도 종종 서버 측에서 처리되는 후처리 단계 중 하나이며, 해당 글은 구두점 복원 및 언어 감지와 함께 데이터를 조용히 외부로 라우팅할 수 있는 파이프라인 단계로 이를 명시적으로 언급합니다. 도구의 프라이버시 보장은 파이프라인의 모든 단계가 검증 가능하게 로컬일 때만 유효하므로, 민감한 오디오를 다루는 사용자는 화자 분리를 독립적인 기능으로 감사해야 하며 최상위 "오프라인" 배지로 보장된다고 가정해서는 안 됩니다.






