I tassi di accuratezza della trascrizione ti stanno ingannando in 2026
I fornitori pubblicano cifre di accuratezza senza rivelare cosa hanno misurato. Ecco cosa calcola davvero il WER, perché i benchmark su audio pulito favoriscono ogni strumento e quanto ti costa quel numero di punta su una registrazione reale.
L'assunto comune è che se uno strumento pubblicizza un alto tasso di accuratezza, l'output dovrebbe essere abbastanza affidabile da usare con solo modifiche minori; il numero di punta è un segnale di qualità significativo. Le dichiarazioni di accuratezza dei fornitori sono ovunque. Nessuna di queste ti dice cosa ha effettivamente misurato il numero, né se quella misurazione abbia qualcosa a che fare con la tua registrazione.
Il problema centrale è di definizione. La stessa metrica, misurata in condizioni diverse, produce risultati radicalmente diversi, e nessuna regola obbliga i fornitori a dirti quali condizioni hanno usato.
Vedi il nostro software di trascrizione per come funziona in pratica.
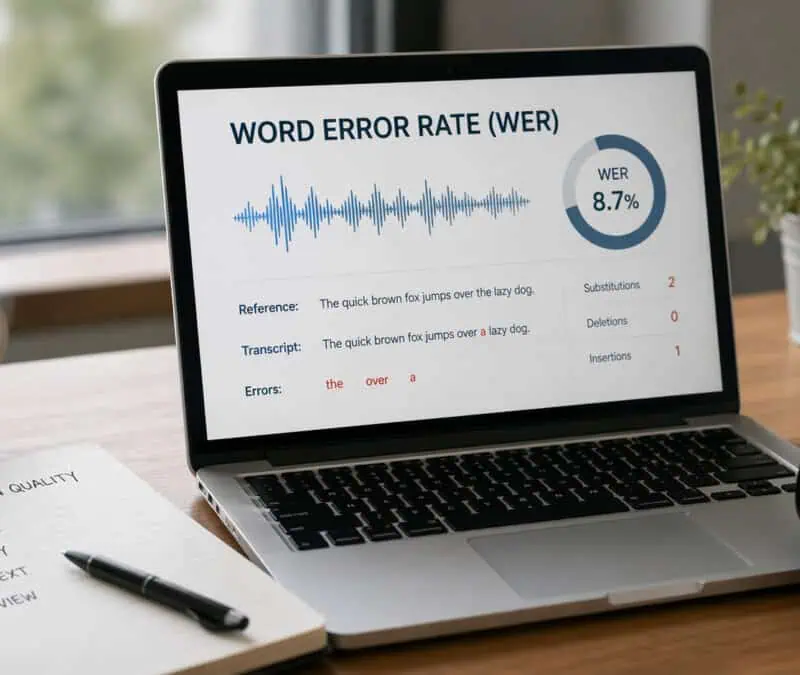
Il Word Error Rate (WER) è la metrica standard dietro ogni cifra di accuratezza nel settore della trascrizione. Secondo il paper e-WER della Association for Computational Linguistics 2018, il WER si calcola contando sostituzioni, cancellazioni e inserimenti rispetto al numero totale di parole in una trascrizione di riferimento. I moderni sistemi di IA possono raggiungere un WER da 2 a 5 per cento su audio pulito e di qualità da studio, che si traduce in un'accuratezza dal 95 al 98 per cento. L'inganno è nascosto in "pulito, di qualità da studio": un solo parlante, vicino al microfono, basso rumore di fondo, ambiente controllato. La maggior parte delle persone che trascrive una vera intervista, una chiamata con un cliente o una riunione registrata non lavora in quelle condizioni.
La stessa ricerca ACL chiarisce che il WER richiede una trascrizione di riferimento, e i fornitori scelgono quale audio produce quella trascrizione. Un fornitore può eseguire il proprio modello su una registrazione da studio pulita con un solo parlante, riportare un WER del 2 per cento e pubblicare "98% accurato" sulla propria homepage. Quel numero non è falso.
Sta misurando qualcosa che non ha nulla a che fare con la tua rumorosa sala conferenze o con l'accento regionale del tuo intervistato. Due fornitori possono entrambi dichiarare un'elevata accuratezza mentre i loro strumenti si comportano in modo completamente diverso su audio reale, perché hanno fatto il benchmark su condizioni completamente diverse. Non c'è alcun obbligo di divulgare il tipo di audio, il profilo del parlante, il livello di rumore o il dominio.
Nessuno standard industriale regola come debba essere misurata o riportata l'accuratezza della trascrizione. Poiché il WER è calcolato rispetto a un riferimento scelto in condizioni scelte, una singola cifra di punta riportata senza la divulgazione della metodologia non può essere interpretata in modo significativo come segnale di qualità per l'uso nel mondo reale. L'unico numero di cui fidarsi è quello misurato su audio reale, pubblicato per lingua, così puoi verificarlo rispetto al tuo tipo di registrazione prima di impegnarti.
Punti chiave
- "99% accurato" è un'affermazione di marketing, non una misurazione, i fornitori quasi mai rivelano su quale audio hanno testato, il che rende il numero impossibile da verificare o di cui fidarsi.
- Il Word Error Rate viene calcolato per impostazione predefinita su parlato pulito, registrato in studio, il che significa che la cifra principale di ogni fornitore è benchmarkata su condizioni che non hanno alcuna somiglianza con un'intervista reale, una riunione o una registrazione sul campo.
- Accenti, rumore di fondo, più parlanti e vocabolario specifico del dominio non sono casi limite, sono la realtà predefinita per la maggior parte del lavoro di trascrizione, ed è esattamente ciò che i benchmark dei fornitori escludono.
- I requisiti di accuratezza non sono un unico standard: un tasso 95% che va bene per una nota vocale personale sarebbe catastroficamente insufficiente per trascrizioni legali, mediche o di conformità.
- La trascrizione AI su audio pulito con un singolo parlante ora si avvicina all'accuratezza umana, il divario si allarga bruscamente nel momento in cui la qualità audio degrada, ed è allora che la scelta tra AI e umano conta davvero.
- Il miglioramento dell'accuratezza con il maggiore impatto avviene prima di premere registra: il posizionamento del microfono e l'acustica della stanza danno a qualsiasi motore di trascrizione un segnale migliore con cui lavorare rispetto a qualsiasi post-elaborazione.
- L'unico benchmark di cui vale la pena fidarsi nomina il set di test, specifica la lingua e l'accento e ti consente di replicarlo sul tuo audio, qualsiasi affermazione che non soddisfi questo standard dovrebbe essere ignorata.
- Cockatoo ti consente di eseguire tu stesso quel test nel mondo reale: carica il tuo audio o video, ricevi rapidamente la trascrizione AI e verifica l'accuratezza rispetto alle registrazioni che devi effettivamente elaborare, senza chiamate commerciali, senza file demo curati.
Come viene calcolato il Word Error Rate e perché i benchmark su audio pulito favoriscono ogni fornitore
Quella cifra deriva direttamente dalla formula del Word Error Rate, e una volta vista l'aritmetica, il divario tra il numero principale di un fornitore e la tua trascrizione effettiva diventa impossibile da ignorare.
La formula WER decodificata - Quanto ti costano realmente sostituzioni, cancellazioni e inserzioni
Il Word Error Rate è calcolato come (S + D + I) / N, dove S conta le parole sostituite, D conta le parole cancellate, I conta le parole inserite e N è il numero totale di parole nella trascrizione di riferimento. Ogni tipo di errore ha lo stesso peso nella formula, quindi una parola omessa costa esattamente quanto una sbagliata.
Un WER 5% non significa un errore ordinato ogni 20 parole. Significa cinque errori da qualche parte all'interno di ogni 100 parole, che si accumulano attorno a parlato accentato, voci sovrapposte e termini specifici del dominio, e quei gruppi tendono a concentrarsi proprio dove il significato è più concentrato.
Perché l'AI moderna ottiene un WER dal 2 al 5 percento su audio pulito, e come suona realmente quella registrazione
I moderni sistemi di riconoscimento vocale raggiungono un WER fino al 2 - 5% su audio pulito di qualità studio, benchmark che richiedono registrazioni con singolo parlante, basso rumore, vicino al microfono. Quelle cifre provengono da dataset come LibriSpeech: singolo parlante, microfono professionale, nessun rumore di fondo, nessuna interruzione, nessuna variazione di accento, nessun code-switching. Come nota il glossario di Allmaz sul Word Error Rate, la maggior parte dei motori generici non è addestrata su schemi conversazionali del mondo reale, il che significa che le cifre principali derivate da audio pulito e in-domain non predicono le prestazioni sulle registrazioni che la maggior parte degli utenti produce effettivamente.
95 percento accurato significa già 25 parole sbagliate per una trascrizione di 500 parole, prima che l'audio del mondo reale peggiori le cose
25
Parole sbagliate in una trascrizione di 500 parole con accuratezza 95%
Una trascrizione di una riunione di 500 parole contiene circa 25 errori con accuratezza 95%, abbastanza per sbagliare il nome di un cliente, corrompere una cifra o perdere completamente un punto d'azione chiave. Su registrazioni reali con rumore di fondo, accenti o più parlanti, l'accuratezza scende regolarmente nell'intervallo 85 - 92%. Al 85%, quella stessa trascrizione porta 75 errori: non una trascrizione da modificare, ma da riscrivere.
Una correzione di quella portata richiede un flusso di lavoro costruito attorno all'esportazione e al passaggio di consegne senza complicazioni. Le esportazioni Cockatoo di DOCX e PDF esistono proprio per questo; chi ha registrato la riunione non deve essere necessariamente la persona che ripulisce la trascrizione. Gli account gratuiti ottengono trascrizioni complete illimitate in V4-Flash, senza limite giornaliero, e ogni formato di esportazione: DOCX, PDF, TXT, SRT, VTT, CSV e JSON.
I fattori che distruggono davvero la precisione della trascrizione sulle registrazioni reali
Le registrazioni reali mettono in crisi gli strumenti di trascrizione in modi che i benchmark dei fornitori non rivelano mai. Le condizioni che fanno lievitare i tassi di errore non sono casi limite; sono la realtà predefinita per chiunque trascriva un'intervista, la registrazione di una chiamata o una tavola rotonda. Capire quali variabili innescano il crollo della precisione è la differenza tra caricare un file con sicurezza e passare due ore a correggere una trascrizione tornata quasi incomprensibile.
1. Rumore di fondo, eco della stanza e posizionamento scadente del microfono - Le quattro variabili di registrazione che i benchmark non testano mai
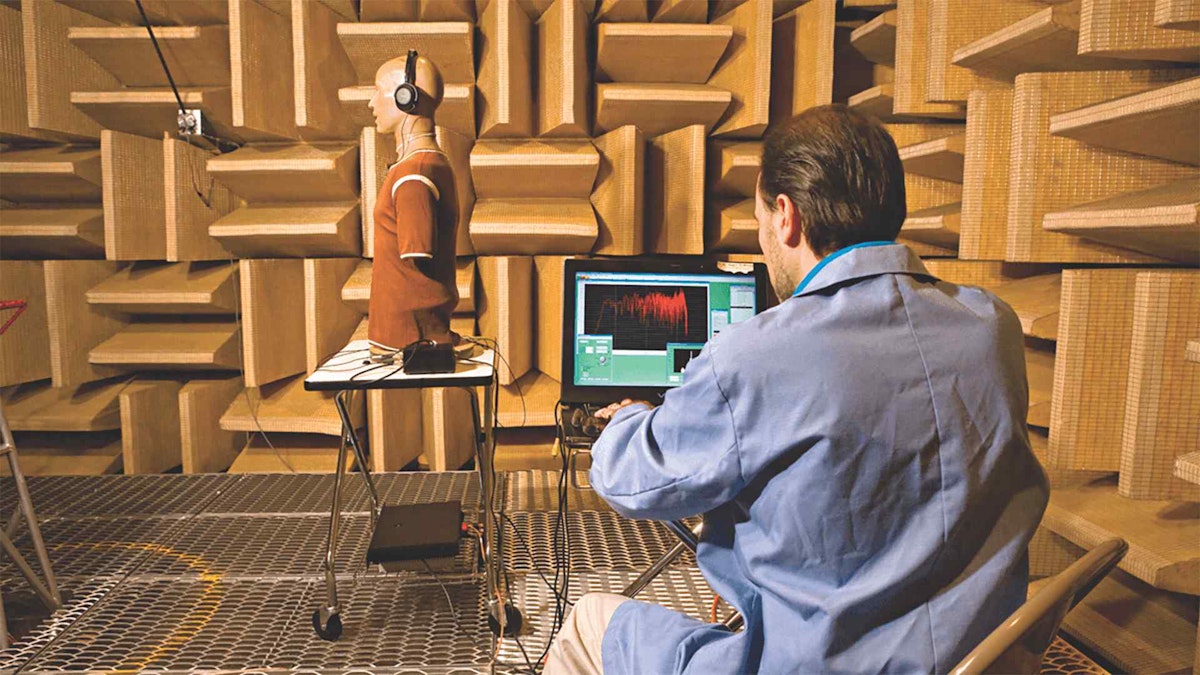
Il rapporto segnale-rumore è il singolo predittore più potente della precisione di trascrizione, e crolla rapidamente. Una ricerca pubblicata su Speech Communication mostra che il tasso di errore sulle parole può salire da meno di 5% su audio pulito a oltre 30% quando il rapporto segnale-rumore scende sotto 10 dB, un livello che descrive un normale ufficio con un condizionatore acceso o una telefonata fatta in cucina. L'eco della stanza aggrava ulteriormente la situazione: il suono riflesso confonde le consonanti tra loro, e il modello riceve due copie di ogni fonema a tempi leggermente diversi, causando errori di cancellazione che nessuna quantità di post-elaborazione può recuperare del tutto.
Il posizionamento del microfono è la variabile che la maggior parte delle persone sottovaluta. Un microfono da laptop che registra un interlocutore a due metri di distanza in una stanza non trattata acusticamente è una classe di segnale fondamentalmente diversa dagli input con microfono ravvicinato e in condizioni anecoiche usati dai benchmark.
È qui che la scelta della modalità conta nella pratica. Cockatoo ha due modalità di trascrizione. V4-Flash trascrive fino a 120x la velocità reale ed è gratuito e illimitato. V4-Pro è la modalità più precisa, funziona a circa 20x la velocità reale e aggiunge le etichette degli speaker. Gli account gratuiti ottengono anteprime settimanali di V4-Pro, così puoi confrontare entrambe le modalità su una registrazione fatta nella tua stanza prima di decidere di cosa ha bisogno il tuo audio.
Pro elabora intere registrazioni in V4-Pro, con limiti di utilizzo più alti e elaborazione prioritaria. I piani attuali sono sulla pagina dei prezzi.
2. Accenti non nativi e variazione dialettale regionale - Perché gli errori di sostituzione aumentano fuori dai corpus con accento maggioritario

La precisione della trascrizione sul parlato inglese non nativo differisce sostanzialmente dalla cifra principale. Una ricerca di settore ha rilevato che cinque principali sistemi ASR producevano per parlanti di inglese afroamericano tassi di errore doppi rispetto ai parlanti di inglese americano bianco, e le disparità legate all'accento per i parlanti non nativi sono ancora più ampie. La modalità di errore è quella delle sostituzioni: parole che suonano plausibili nel contesto ma sono sbagliate, così sopravvivono a una lettura superficiale e corrompono il verbale in silenzio.
Una ricerca di settore ha rilevato che cinque principali sistemi ASR producevano per parlanti di inglese afroamericano tassi di errore doppi rispetto ai parlanti di inglese americano bianco, e le disparità legate all'accento per i parlanti non nativi sono ancora più ampie.
Un'intervista registrata in un bar con due parlanti non nativi di inglese restituirà comunemente una precisione intorno al 70% alto da uno strumento che pubblicizza 99%. Il divario è una conseguenza strutturale di corpus di addestramento sbilanciati verso parlato con accento maggioritario registrato in studio. Cockatoo trascrive 36 lingue, e i suoi tassi di errore V4-Pro per lingua, su FLEURS e su registrazioni del mondo reale, sono pubblicati sulla sua pagina dei benchmark, il posto giusto per verificare la tua lingua prima di impegnare una registrazione specialistica.
Una volta che si ha in mano una trascrizione accurata, il passaggio successivo che genera attrito è ottenerla in un formato che un collega possa effettivamente aprire e modificare. Cockatoo esporta direttamente in PDF e DOCX, così una trascrizione arriva come file Word o PDF che qualcun altro può modificare senza alcun passaggio di conversione, un dettaglio che sembra secondario finché non hai provato a estrarre un file di testo semplice in un documento formattato con una scadenza.
3. Tasso di errore di diarizzazione (DER) - Il livello di accuratezza nascosto che i fornitori quasi mai pubblicano
Il Tasso di errore di diarizzazione (DER) misura quanto accuratamente un sistema assegna ogni parola al parlante corretto. Si calcola come la somma di parlato mancato, falsi allarmi e confusione tra parlanti, divisa per il tempo totale di parlato di riferimento. I benchmark di settore su registrazioni di riunioni con più parlanti provenienti da fonti come le valutazioni NIST Rich Transcription mostrano valori di DER di 15-30% su audio con sovrapposizioni o di qualità telefonica, il che significa che in un panel di quattro persone fino a tre parole su dieci possono essere assegnate al parlante sbagliato.
I fornitori quasi mai pubblicano il DER insieme al WER. Il risultato è che una trascrizione può sembrare accurata parola per parola pur essendo strutturalmente inutilizzabile: frasi spezzate a metà del ragionamento tra parlanti sbagliati, azioni da intraprendere attribuite alla persona sbagliata e un onere di pulizia che i ricercatori nel lavoro di interviste qualitative descrivono costantemente come peggiore rispetto a ribattere da zero.
4. Collasso non lineare della qualità audio - Perché l'accuratezza non degrada in modo graduale e alcuni file richiedono una riscrittura completa
L'accuratezza non scende in modo graduale man mano che le condizioni peggiorano. Si mantiene, poi crolla.
La ricerca sulla robustezza dell'ASR mostra un effetto soglia: i modelli mantengono un'accuratezza vicina al benchmark finché il degrado del segnale non supera un punto critico, oltre il quale il modello acustico perde stabilità e il tasso di errore schizza bruscamente invece di crescere in proporzione al rumore aggiunto. La conseguenza pratica è che un file che all'orecchio umano suona "un po' grezzo" può trovarsi appena oltre quella soglia, restituendo una trascrizione che richiede una riscrittura completa anziché una leggera modifica. La maggior parte dei trascrittori singoli lo scopre solo dopo aver già caricato il file, atteso e aperto il risultato.
Il piano Pro di Cockatoo supporta file di lunghezza illimitata, così i file di più ore vengono caricati per intero. Carica qualsiasi file audio o video e ricevi indietro una trascrizione modificabile. Su V4-Pro, i parlanti vengono rilevati automaticamente e rinominare un parlante nell'editor aggiorna ogni riga.

Le trascrizioni includono timestamp a livello di parola e punteggiatura automatica. Le prove di accuratezza sono disponibili nella pagina dei benchmark pubblicata (FLEURS per lingua e risultati reali per 36 lingue, con il metodo) anziché una percentuale nuda e cruda.
La lunghezza illimitata dei file è importante qui perché le registrazioni più lunghe, che statisticamente hanno maggiori probabilità di contenere condizioni acustiche variabili per tutta la loro durata, sono i file più propensi a raggiungere il punto di collasso non lineare a metà. Poter caricare senza troncare il file significa che il modello vede il contesto completo anziché una versione tagliata che potrebbe iniziare o finire a metà frase.
5. Parlato sovrapposto e diafonia - Come le voci simultanee distruggono l'integrità del segnale alla fonte

Quando due parlanti parlano contemporaneamente, il problema non è un limite del software. È un problema fisico. Il microfono riceve un'unica forma d'onda mista, e nessun modello può separare perfettamente due voci che occupano lo stesso spazio di frequenza nello stesso momento. Una registrazione di un panel con quattro voci sovrapposte in cui la diarizzazione spezza le frasi a metà del ragionamento tra parlanti sbagliati fallisce perché l'integrità del segnale è stata distrutta alla fonte.
La diafonia nelle registrazioni delle chiamate e nelle videoconferenze è particolarmente dannosa perché i codec di compressione utilizzati in tali pipeline degradano ulteriormente i segmenti sovrapposti, lasciando al modello un input già degradato prima ancora che entrino in gioco i fattori di accuratezza che influenzano la trascrizione.
Per le registrazioni video con parlato sovrapposto, l'esigenza a valle è spesso un file di didascalie o sottotitoli pubblicabile piuttosto che una trascrizione per l'editing. Cockatoo esporta file di sottotitoli in SRT e VTT su ogni piano, insieme a DOCX, PDF, TXT, CSV e JSON, e le esportazioni in blocco sono incluse con Pro, così l'output corretto può essere consegnato direttamente al video senza richiedere una conversione separata.
6. Vocabolario specifico del dominio e gergo tecnico - Il divario lessicale che gonfia il tasso di errore delle parole sulle registrazioni specialistiche
I modelli ASR generici sono ottimizzati per il vocabolario quotidiano e faticano con la terminologia medica, legale, scientifica o specifica del settore. Quando un parlante usa gergo di dominio, il modello sostituisce la parola comune foneticamente più simile, producendo errori più difficili da individuare in fase di revisione perché risultano plausibili. Per i professionisti che trascrivono contenuti specialistici, questo divario lessicale è un fattore costante e sottostimato della perdita di accuratezza della trascrizione che i punteggi WER su audio pulito oscurano completamente.
Che aspetto ha davvero una buona accuratezza di trascrizione nei diversi casi d'uso
I requisiti di accuratezza non sono un'unica soglia. La soglia che rende perfettamente utilizzabile una nota vocale personale farebbe licenziare un responsabile della conformità. Il livello di accuratezza che uno strumento di trascrizione deve effettivamente garantire è proporzionale a quanto catastroficamente una singola parola sbagliata può propagarsi a valle, quindi la cifra di punta del fornitore è attivamente fuorviante per alcuni utenti.
Una trappola sottovalutata: le metriche standard del Word Error Rate possono mentire per omissione. Uno strumento che elimina silenziosamente le voci incrociate, saltando i parlanti sovrapposti invece di tentare di trascriverli, registrerà un WER inferiore rispetto a uno strumento che ci prova e occasionalmente sfigura quegli scambi. Il primo strumento sembra più accurato sulla carta mentre consegna meno della tua riunione reale.
1. Accuratezza 80-90% - La soglia accettabile per note informali e dettatura personale
Note informali e dettatura personale tollerano un'accuratezza del 80-90% perché il costo di una parola mancata è basso e la correzione è rapida. Una lista della spesa con due voci storpiate è un fastidio minore. I professionisti che usano la voce-digitazione per la gestione della conoscenza personale scoprono costantemente che correggere qualche errore per paragrafo non annulla il tempo risparmiato nella cattura. Il vero limite qui è il carico cognitivo, non la precisione.
Anche a questo livello, un sottile problema di affidabilità mette in difficoltà molti utenti: un periodo iniziale di elevate prestazioni seguito da un calo inspiegabile dell'accuratezza. Quando accade, l'istinto è supporre che sia cambiata la qualità audio, quando la vera causa è spesso che la modalità o il percorso di elaborazione è cambiato. La pagina dei benchmark di Cockatoo pubblica i tassi di errore V4-Pro per lingua, con il metodo, così puoi verificare come si comporta la tua lingua prima di impegnarti in un flusso di lavoro, invece di scoprire la discrepanza dopo il calo.
2. Accuratezza 95%+ - Lo standard minimo per riunioni di lavoro, podcast e didascalie multimediali
Le riunioni di lavoro, le trascrizioni di podcast e le didascalie video si collocano in un livello diverso. Un tasso di errore delle parole del 4% sembra piccolo finché non sfigura il nome di un cliente, omette una cifra di budget o attribuisce un'azione alla persona sbagliata. Un team marketing che sottotitola video social può tollerare un WER del 4%; un team che produce un video di formazione sulla conformità non può. A questo livello, i nomi propri e i numeri sono le prime vittime dell'accuratezza degradata, e sono esattamente le parole che guidano le decisioni.
Il flusso di correzione conta quanto l'accuratezza iniziale. Nell'editor browser di Cockatoo, individui i nomi letti male e correggi le etichette dei parlanti senza rielaborare il file, e rinominare un parlante aggiorna ogni riga. Per le registrazioni di riunioni, Pro include anche Canvas per i riepiloghi. Invece di rileggere un'ora intera per verificare ogni azione, puoi partire da un riepilogo di ciò su cui bisogna effettivamente agire, per poi passare alla trascrizione solo per le correzioni mirate. Quel flusso di lavoro in due fasi mantiene raggiungibile l'accuratezza di livello business senza pagare un trascrittore umano su ogni file.
3. 99%+ di precisione - La soglia non negoziabile per la trascrizione legale, medica e di conformità
La trascrizione legale, medica e di conformità richiede una precisione di 99%+ senza eccezioni significative. Una singola parola trasposta o fraintesa può alterare il significato, introdurre responsabilità o far fallire un controllo normativo a una trascrizione. La ricerca di settore lo dice chiaramente: una singola parola imprecisa può alterare il significato di una diagnosi, di un piano di trattamento o di un'istruzione sui farmaci. A questo livello, la maggior parte degli strumenti di IA non può garantire la soglia su audio del mondo reale, e il divario tra il numero di punta di un fornitore e le prestazioni effettive sul campo è dove risiede la responsabilità.

Il problema della misurazione del WER è più acuto qui. Se uno strumento omette silenziosamente la sovrapposizione vocale di uno specialista durante una discussione tra più clinici, la trascrizione risultante può ottenere un buon punteggio sul tasso di errore pur mancando completamente contenuti clinicamente significativi, un esito peggiore di una trascrizione che ha tentato il passaggio e segnalato incertezza. Sapere come uno strumento gestisce il parlato sovrapposto, non solo il suo punteggio di precisione aggregato, è essenziale prima di affidarsi ad esso su registrazioni ad alto rischio.
4. La trascrizione umana a 99%+: il benchmark rispetto al quale misurare l'IA
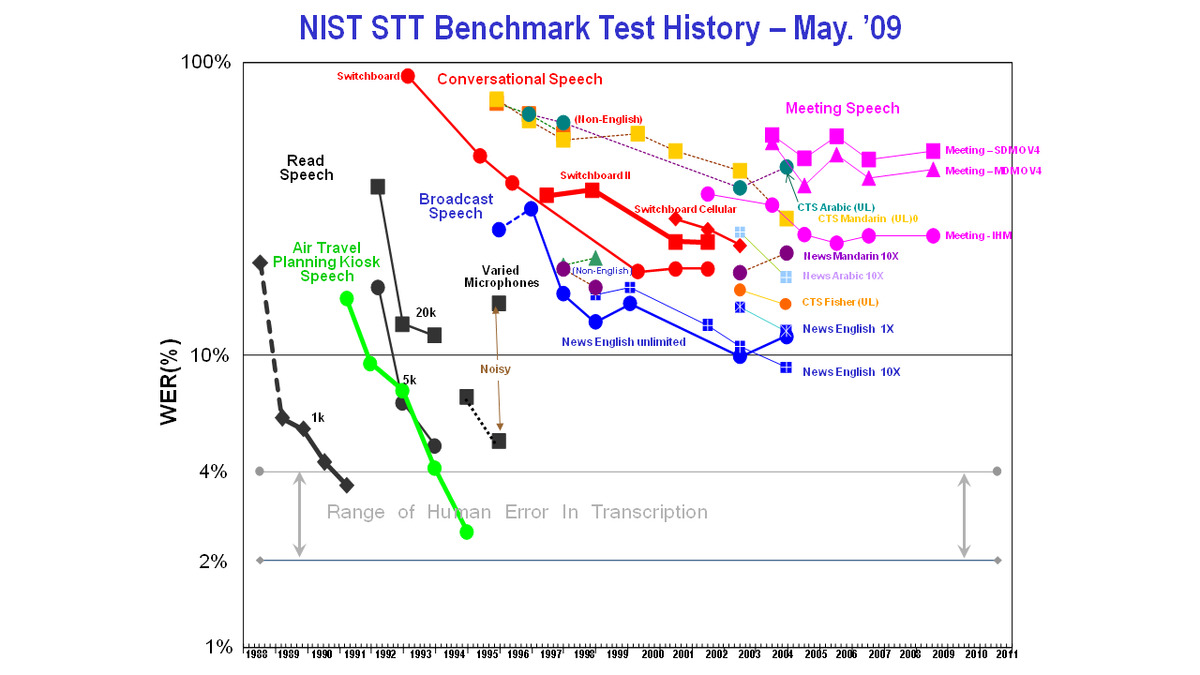
I trascrittori umani esperti raggiungono costantemente una precisione di 99%+ perché riascoltano, inferiscono il contesto e si adattano agli accenti in modi che un modello statistico non può fare. Questo è il benchmark rispetto al quale si misura l'IA, e su audio pulito da studio il divario si è ridotto in modo significativo. Su registrazioni con accento, rumorose o con più parlanti, il divario si amplia in modi che gli utenti non possono prevedere in anticipo. La trascrizione umana è la scelta giusta quando la registrazione è davvero ad alto rischio e le condizioni audio sono scadenti; è eccessiva per un riassunto di prima bozza di una riunione di lavoro.
La domanda pratica per la maggior parte dei prosumer e delle piccole imprese è se lo strumento che stanno valutando sia stato misurato su audio simile alle loro registrazioni effettive. Cockatoo affronta direttamente il livello intermedio: l'output dell'IA funziona immediatamente per appunti informali e bozze di riunioni, e l'editor del browser gestisce la fase di correzione di livello business, ottenendo correttamente nomi, numeri ed etichette dei parlanti senza un trascrittore umano su ogni file. Su Pro, i riassunti Canvas significano che le registrazioni lunghe possono essere condensate su ciò su cui è effettivamente necessario agire, così la fase di correzione è circoscritta e rapida anziché aperta.
Gli utenti possono verificare l'intero flusso di lavoro sui propri file con il piano Free, con trascrizioni complete illimitate, senza limite giornaliero e senza carta di credito richiesta, più anteprime settimanali V4-Pro, prima di impegnarsi in un piano a pagamento. Pro elabora intere registrazioni in V4-Pro, con etichette dei parlanti e lunghezza illimitata dei file, e aggiunge riassunti Canvas, rendendo pratico elaborare registrazioni di più ore attraverso lo stesso flusso di lavoro su larga scala.
Conoscere la propria soglia è solo metà dell'equazione. La domanda più difficile è se qualche strumento di IA, compresi quelli che citano 99% sulla loro homepage, superi effettivamente quella soglia sull'audio con accento, rumoroso e specifico del dominio che si trova nella cartella delle registrazioni. È esattamente ciò che misura la sezione successiva.
Letture correlate
- Miglior software di trascrizione
- Prezzi Turboscribe
- Trascrizione IA locale
- Come trascrivere un video
- Trascrizione multilingue
- Trascrizione IA offline
Come la precisione della trascrizione IA si confronta con la trascrizione umana sull'audio che si ha effettivamente
La scelta tra trascrizione IA e umana sembra un dibattito sulla qualità, ma in realtà è un dibattito sulle condizioni.
Su audio pulito l'IA quasi eguaglia i trascrittori umani
Secondo l'analisi dei benchmark di VexaScribe, i migliori motori di IA eguagliano o superano il trascrittore umano medio a circa 4-5% WER su registrazioni in inglese pulite con un solo parlante. Un'intervista di 60 minuti che restituisce un 3% WER richiede circa 15 minuti per la revisione, e la differenza di prestazioni tra i migliori e i peggiori motori di IA principali si attesta su circa 3-5 punti WER.
Un'implicazione sottovalutata: su materiale video pulito, una lezione, una demo di prodotto, un webinar registrato, la precisione dell'IA è spesso sufficiente perché Cockatoo possa trasformare la trascrizione in file di sottotitoli SRT o VTT in pochi secondi, pronti per una rapida revisione prima della pubblicazione.
Il divario si allarga sull'audio del mondo reale perché gli esseri umani inferiscono mentre l'IA tira a indovinare
Sulle registrazioni del mondo reale, il quadro cambia. L'analisi di VexaScribe ha rilevato che su riunioni, chiamate telefoniche e parlato con accento, l'IA è indietro rispetto ai trascrittori umani esperti di 2-5% WER. Un modello di IA confronta i pattern con i dati di addestramento e, quando l'audio esce da quella distribuzione, la precisione cala bruscamente e in modo imprevedibile, mentre i trascrittori umani inferiscono il significato dal contesto. La produzione umana di una trascrizione non la rende accurata; la rende autoriale, con tutta l'attenzione selettiva e l'inferenza che ciò implica.
Il tempo di correzione è il costo nascosto che annulla il vantaggio di velocità dell'IA sull'audio difficile
Un'intervista di 60 minuti con due non madrelingua e rumore di fondo udibile può tornare dall'IA con un WER di 14%.
Il Canvas di Cockatoo, incluso con Pro, è pensato esattamente per questo: invece di modificare riga per riga una lunga trascrizione parola per parola, lo si usa per riassumere la registrazione fino a ciò su cui occorre effettivamente agire.
Come migliorare la precisione della trascrizione prima di caricare un singolo file
Una registrazione fatta in una stanza rumorosa consegna a ogni motore di trascrizione un problema che non può risolvere completamente. Lo strumento riceve ciò che il microfono ha catturato; non può ricostruire informazioni vocali che non sono mai state registrate in modo pulito. Ecco perché il singolo miglioramento di precisione a più alto impatto disponibile per qualsiasi utente è una decisione su hardware e ambiente presa prima della registrazione, non un'impostazione software attivata al caricamento.
La maggior parte delle persone presume che la soluzione sia uno strumento migliore. La vera soluzione è un audio di origine migliore. Ecco sei passi concreti che fanno la differenza.
1. Migliora il microfono prima di toccare qualsiasi impostazione software
Il Journal of Electrical and Electronic Engineering conferma che i microfoni cardioidi superano i design omnidirezionali in ambienti rumorosi attenuando i suoni provenienti dai lati e dal retro, preservando il segnale vocale frontale. Un microfono a condensatore USB da $50 puntato direttamente verso l'oratore offre a qualsiasi motore di trascrizione un segnale più pulito di quanto possa mai fare un microfono da laptop. Spendere soldi per un livello di abbonamento superiore mentre si registra con hardware integrato ottimizza l'estremità sbagliata della pipeline.
2. Registra in una stanza silenziosa per eliminare il più grande killer della precisione
Un condizionatore, una strada fuori o una ventola in funzione si sommano in errori lungo tutta la registrazione. Chiudi le porte, spegni tutto ciò che ronza e registra lontano dalle finestre. Più la stanza è silenziosa, più informazioni vocali cattura il microfono e meno il motore deve indovinare.
3. Silenzia le notifiche e disattiva l'audio dei dispositivi prima di ogni sessione di registrazione
I suoni di notifica sono brevi, ma il loro impatto è sproporzionato. Un singolo suono di avviso sovrapposto a una parola pronunciata può corrompere completamente quella parola, perché il motore perde il suo riferimento di affidabilità esattamente in quel momento e spesso ne soffrono anche le parole circostanti. Metti i telefoni in silenzioso, chiudi le schede del browser che riproducono audio automaticamente e disabilita i suoni di sistema su ogni computer nella stanza prima di premere registra. Questo costa trenta secondi di configurazione e di norma risparmia minuti di correzione.
4. Evita gli altoparlanti del telefono e i microfoni integrati dei laptop per qualsiasi registrazione seria
L'audio di una chiamata telefonica elaborato attraverso un codec a banda stretta cattura un intervallo di frequenze compresso che elimina i dettagli acustici su cui il motore si basa per distinguere parole dal suono simile. I microfoni integrati dei laptop condividono lo stesso problema: sono omnidirezionali e posizionati lontano dalla bocca dell'oratore, quindi catturano la stanza con la stessa facilità della voce. Entrambi sono accettabili per appunti informali in cui gli errori minori hanno scarso peso. Per qualsiasi registrazione in cui nomi, cifre o decisioni contano, nessuno dei due è un dispositivo di acquisizione affidabile.
5. Stabilisci aspettative di accuratezza prima di accettare registrazioni sul campo o audio di chiamate telefoniche
Se qualcuno ti invia una registrazione fatta con un telefono in un caffè affollato, il limite massimo di accuratezza è già stabilito prima che tu la carichi. Nessun motore, e nessuna quantità di regolazioni post-caricamento, recupera le informazioni vocali che non sono mai state catturate in modo pulito. Prima di accettare un file da un cliente o un collega, fai una domanda: è stato registrato vicino a chi parla in uno spazio silenzioso? Se la risposta è no, segnalalo fin dall'inizio. Correggere una trascrizione scadente richiede molto più tempo che ricalibrare le aspettative prima di iniziare il lavoro.
6. Verifica la qualità delle registrazioni più vecchie e d'archivio prima di impegnarti nella trascrizione
Le registrazioni legacy portano artefatti, fruscio del nastro, rumore da codec, compressione di banda, che i moderni motori AI gestiscono in modo diverso rispetto ai trascrittori umani. Un umano riascolta e deduce dal contesto; un motore restituisce la sua migliore ipotesi statistica e va avanti, così gli errori si concentrano silenziosamente intorno ai passaggi degradati. Prima di caricare un file d'archivio, riproduci trenta secondi e ascolta se ci sono fruscii, clipping o eco. Se la riproduzione suona grezza al tuo orecchio, leggerà peggio nella trascrizione. Riregistrare un breve segmento dove possibile, o segnalare le sezioni degradate prima del caricamento, costa minuti e risparmia una riscrittura completa.
L'unico numero di accuratezza di cui fidarsi è quello che puoi verificare tu stesso
Le percentuali di Word Error Rate pubblicate dai fornitori sono tipicamente misurate su parlato inglese pulito e registrato in studio, condizioni che hanno poco in comune con l'audio degradato, multilingue o specifico di un dominio con cui la maggior parte delle organizzazioni lavora realmente. I benchmark significativi indicano il set di test, specificano la lingua e la distribuzione degli accenti, e scompongono le prestazioni per livello di qualità audio invece di ridurre tutto a una singola media ottimistica.
"Gli utenti non possono verificare in modo indipendente le affermazioni di '40% migliore accuratezza' o 'accuratezza molto migliore' fatte da TranscribeX; non viene fornito alcun benchmark, file di test o metodologia che chiunque possa replicare da solo."
— ciò che sentiamo dagli utenti di software di trascrizione
Il benchmark FLEURS di Google copre parlato realmente registrato in 102 lingue in condizioni standardizzate, rendendolo un riferimento esterno riproducibile che qualsiasi utente può verificare in modo incrociato. FLEURS pubblica suddivisioni di valutazione specifiche per lingua, quindi un word error rate per lingua su FLEURS è un'affermazione verificabile, non un numero che il fornitore ha selezionato in condizioni favorevoli.
Un modello che performa bene sull'inglese con accento maggioritario può restituire tassi di errore significativamente più alti su indonesiano, assamese o francese senza che il numero di punta si muova affatto. Un'accuratezza verificabile richiede tre cose insieme: un benchmark con nome (FLEURS è idoneo), suddivisioni per lingua invece di una cifra aggregata, e audio di test che rifletta le condizioni di registrazione del mondo reale.
Perché il compromesso accuratezza-prezzo accessibile è un problema tecnologico, non una legge fisica
Il deep learning all'avanguardia, progettato per velocità e accuratezza, rende l'alta accuratezza accessibile a qualsiasi volume.
Cockatoo pubblica risultati per lingua per la sua modalità V4-Pro in tutte le 36 lingue che trascrive. Sono misurati su FLEURS e su un set interno, etichettato da esseri umani, di registrazioni del mondo reale, valutati come WER (CER per cinese, giapponese, khmer e thai) con la normalizzazione del testo open-source di OpenAI Whisper. Il divario descritto in questo articolo emerge anche in quei numeri. Su clip FLEURS in inglese, il word error rate di V4-Pro è 3.9%. Su registrazioni inglesi del mondo reale, è 10.4% a 10.9%. V4-Pro ha il tasso di errore più basso tra i fornitori testati in 25 di 36 lingue su FLEURS, ma non in tutte le lingue: sull'inglese FLEURS, Universal-3.5 Pro di AssemblyAI ha ottenuto un punteggio inferiore. I risultati, il metodo e una nota che specifica che il set del mondo reale è un controllo in-sample sono sulla pagina dei benchmark. L'accuratezza varia in base alla lingua e alla qualità della registrazione.
Come eseguire un test di verifica di cinque minuti prima di abbonarti a qualsiasi cosa
Conta gli errori rispetto a ciò che è stato effettivamente detto. Il benchmark di un fornitore su FLEURS ti dice il limite minimo; il tuo clip ti dice la realtà. Un benchmark esterno insieme a una prova su un file reale eliminano insieme l'asimmetria informativa che un dato autodichiarato dal fornitore lascia in essere.
Letture correlate
- Migliore app di trascrizione
- Descript Vs Otter
- Fireflies Vs Otter
- Trint Vs Rev
- Happy Scribe Vs Rev
- Concorrenti di Otter.AI
Prossimi passi
Se le tue registrazioni continuano a restituire trascrizioni che richiedono più tempo per essere corrette che per essere ribattute, la strada da seguire inizia con il riconoscere che la cifra di accuratezza in evidenza non è mai stata misurata su audio come il tuo. Inizia con il nostro software di trascrizione.
L'impatto della qualità audio sull'accuratezza è molto maggiore di qualsiasi differenza tra i motori, e il divario tra i migliori e i peggiori strumenti di IA su registrazioni del mondo reale si riduce a 3-5 punti WER, un margine che le sole condizioni di registrazione possono far oscillare di più. Ciò significa che scegliere uno strumento "più accurato" senza prima testarlo sui propri file significa ottimizzare la variabile sbagliata. Allo stesso tempo, un fornitore che pubblica risultati per lingua su un dataset esterno standardizzato e ti consente di testare sul tuo audio prima di pagare ha strutturalmente eliminato l'asimmetria informativa che rende le dichiarazioni di accuratezza non verificabili per concezione.
Queste due condizioni insieme, benchmark esterno più prova su file reale, sono l'unica combinazione che ti consente di verificare la dichiarazione invece di fidarti. Insieme, indicano un ovvio prossimo passo: esegui il tuo audio attraverso uno strumento che pubblica entrambe le cose.
Inizia con un software di trascrizione che pubblica benchmark FLEURS per lingua e non richiede carta di credito per essere testato. Carica un clip reale dalle tue registrazioni, confronta il risultato con le cifre pubblicate per la tua lingua, e avrai l'unico numero di accuratezza che si trasferisce mai alle condizioni di produzione.
Domande frequenti
Cosa significa realmente un tasso di accuratezza del 95% per la mia trascrizione in pratica?
Un tasso di accuratezza del 95% significa circa 25 errori ogni trascrizione di 500 parole, abbastanza per sbagliare il nome di un cliente, corrompere una cifra o perdere del tutto un punto d'azione chiave. Su registrazioni reali con rumore di fondo, accenti o più parlanti, l'accuratezza scende regolarmente ulteriormente, nell'intervallo 85-92%, dove quella stessa trascrizione può contenere 75 errori e richiedere una riscrittura completa invece di una lieve revisione.
Perché i fornitori pubblicizzano un'accuratezza del 98% o del 99% quando le mie trascrizioni tornano piene di errori?
I fornitori testano i loro strumenti su audio pulito, di qualità da studio, con un solo parlante, dataset come LibriSpeech con microfoni professionali, nessun rumore di fondo e nessuna variazione di accento, e non sono tenuti a divulgare tali condizioni di test. La tua intervista, registrazione di chiamata o registrazione di riunione quasi certamente non corrisponde a quelle condizioni, quindi la cifra in evidenza semplicemente non è stata misurata su un audio come il tuo.
Quanto peggiora realmente il parlato sovrapposto per gli strumenti di trascrizione?
Quando due parlanti parlano contemporaneamente, il microfono cattura un'unica forma d'onda mista che nessun modello può separare perfettamente, perché le voci occupano lo stesso spazio di frequenza simultaneamente, è un problema di fisica, non di software. Oltre agli errori di parole che ciò causa, i benchmark di settore su registrazioni di riunioni con più parlanti mostrano tassi di errore di diarizzazione di 15-30% su audio sovrapposto o di qualità telefonica, il che significa che fino a tre parole su dieci possono essere assegnate al parlante sbagliato in un panel di quattro persone.
Il tasso di errore di parola è la stessa cosa della percentuale di accuratezza mostrata sulla homepage di un fornitore?
Sì, la percentuale di accuratezza è semplicemente il WER invertito. Il WER è calcolato come (sostituzioni + cancellazioni + inserimenti) diviso per il conteggio totale delle parole in una trascrizione di riferimento, quindi un WER del 5% diventa un'accuratezza dichiarata del 95%. Ogni tipo di errore conta allo stesso modo nella formula, il che significa che una cancellazione che elimina la parola "non" da "non procedere" costa quanto un banale errore di ortografia, e gli errori si concentrano intorno ai momenti più difficili, parlato con accento, voci sovrapposte e termini specifici del dominio, invece di distribuirsi uniformemente nella trascrizione.
La mia registrazione deve diventare davvero pessima prima che l'accuratezza crolli, o scivola gradualmente?
La precisione non scivola verso il basso in modo graduale, si mantiene vicina ai livelli di riferimento e poi crolla bruscamente una volta che il degrado del segnale supera una soglia critica. La ricerca sulla robustezza degli ASR mostra che questo effetto soglia significa che un file che all'orecchio umano suona solo "un po' grezzo" potrebbe già aver superato il punto in cui il tasso di errore aumenta drasticamente, restituendo una trascrizione che richiede una riscrittura completa anziché una modifica leggera.






