Míra přesnosti přepisu vás v 2026 uvádí v omyl
Dodavatelé zveřejňují čísla přesnosti, aniž by uváděli, co měřili. Zde je to, co WER skutečně počítá, proč benchmarky na čistém zvuku vylepšují obraz každého nástroje a co vás toto headline číslo stojí na skutečné nahrávce.
Běžný předpoklad je, že pokud nástroj inzeruje vysokou míru přesnosti, výstup by měl být dostatečně spolehlivý k použití jen s drobnými úpravami; headline číslo je smysluplný signál kvality. Tvrzení o přesnosti od dodavatelů jsou všude. Žádné z nich vám však neřekne, co číslo skutečně měřilo, ani zda má toto měření něco společného s vaší nahrávkou.
Zásadní problém je definiční. Stejná metrika měřená za různých podmínek produkuje divoce odlišné výsledky a žádné pravidlo nevyžaduje, aby dodavatelé uvedli, které podmínky použili.
Podívejte se na náš software pro transkripci, jak to funguje v praxi.
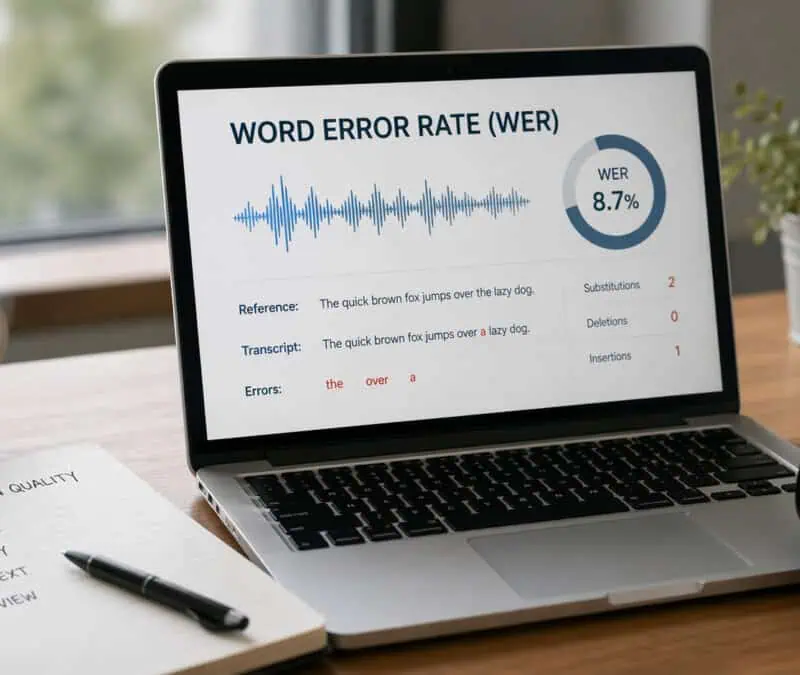
Word Error Rate (WER) je standardní metrika stojící za každým číslem přesnosti v transkripčním průmyslu. Podle článku o e-WER od Association for Computational Linguistics 2018 se WER vypočítává počítáním substitucí, delecí a inserací vzhledem k celkovému počtu slov v referenčním přepisu. Moderní AI systémy mohou dosáhnout 2 až 5 procent WER na čistém zvuku ve studiové kvalitě, což se překládá na 95 až 98 procent přesnosti. Háček je ukryt v „čistém zvuku ve studiové kvalitě“: jeden mluvčí, blízko mikrofonu, nízký šum na pozadí, kontrolované prostředí. Většina lidí přepisujících skutečný rozhovor, klientský hovor nebo zaznamenanou schůzku nepracuje s těmito podmínkami.
Stejný výzkum ACL objasňuje, že WER vyžaduje referenční přepis a dodavatelé volí, které audio tento přepis vytvoří. Dodavatel může spustit svůj model na čisté studiové nahrávce s jedním mluvčím, nahlásit 2 procent WER a zveřejnit na své domovské stránce „98% přesné“. To číslo není nepravdivé.
Měří něco, co nemá nic společného s vaší hlučnou zasedací místností nebo regionálním akcentem vašeho respondenta. Dva dodavatelé mohou oba tvrdit vysokou přesnost, zatímco jejich nástroje si na skutečném zvuku vedou zcela odlišně, protože je porovnávali za zcela odlišných podmínek. Neexistuje žádná povinnost zveřejnit typ audia, profil mluvčího, úroveň šumu nebo doménu.
Žádný celoodvětvový standard neupravuje, jak musí být přesnost transkripce měřena nebo vykazována. Protože se WER počítá vůči zvolenému referenčnímu přepisu za zvolených podmínek, jediné headline číslo uvedené bez zveřejnění metodologie nelze smysluplně interpretovat jako signál kvality pro použití v reálném světě. Jediné číslo, které stojí za to věřit, je to, které je porovnáno na skutečném zvuku a zveřejněno pro každý jazyk, takže si je můžete ověřit proti svému vlastnímu typu nahrávky, než se zavážete.
Klíčové poznatky
- „99% přesné“ je marketingové tvrzení, nikoli měření, dodavatelé téměř nikdy nezveřejní, na jakém audiu testovali, což činí toto číslo nemožné ověřit nebo mu důvěřovat.
- Míra chybovosti slov se ve výchozím nastavení počítá na čisté, studiově nahrané řeči, což znamená, že každé hlavní číslo dodavatele je benchmarkováno na podmínkách, které nemají nic společného s reálným rozhovorem, schůzkou nebo terénním záznamem.
- Akcenty, hluk na pozadí, více mluvčích a oborově specifická slovní zásoba nejsou okrajové případy, jsou výchozí realitou pro většinu transkripční práce, a právě to benchmarky dodavatelů vylučují.
- Požadavky na přesnost nejsou jediná laťka: míra 95%, která stačí pro osobní hlasovou poznámku, by byla katastrofálně nedostatečná pro právní, lékařskou nebo compliance transkripci.
- AI transkripce čistého audia s jedním mluvčím se nyní blíží lidské přesnosti, propast se prudce rozšiřuje ve chvíli, kdy se kvalita audia zhorší, a právě tehdy skutečně záleží na volbě mezi AI a člověkem.
- Nejpřínosnější zlepšení přesnosti nastává ještě před stisknutím nahrávání: umístění mikrofonu a akustika místnosti dají jakémukoli transkripčnímu enginu lepší signál, než kdy dokáže dodat následné zpracování.
- Jediný benchmark, kterému stojí za to věřit, pojmenovává testovací sadu, specifikuje jazyk a akcent a umožňuje vám replikovat ho na vašem vlastním audiu, jakékoli tvrzení, které tuto laťku nesplňuje, by mělo být ignorováno.
- Cockatoo vám umožňuje provést ten test v reálném světě sami: nahrajte své vlastní audio nebo video, rychle získejte AI transkripci zpět a ověřte přesnost na nahrávkách, které skutečně potřebujete zpracovat, žádný obchodní hovor, žádný upravený demo soubor.
Jak se míra chybovosti slov počítá a proč benchmarky čistého audia lichotí každému dodavateli
Toto číslo pochází přímo ze vzorce míry chybovosti slov, a jakmile uvidíte aritmetiku, propast mezi hlavním číslem dodavatele a vaším skutečným přepisem se stane nemožné ignorovat.
Vzorec WER rozluštěn - co vás substituce, delece a inzerce skutečně stojí
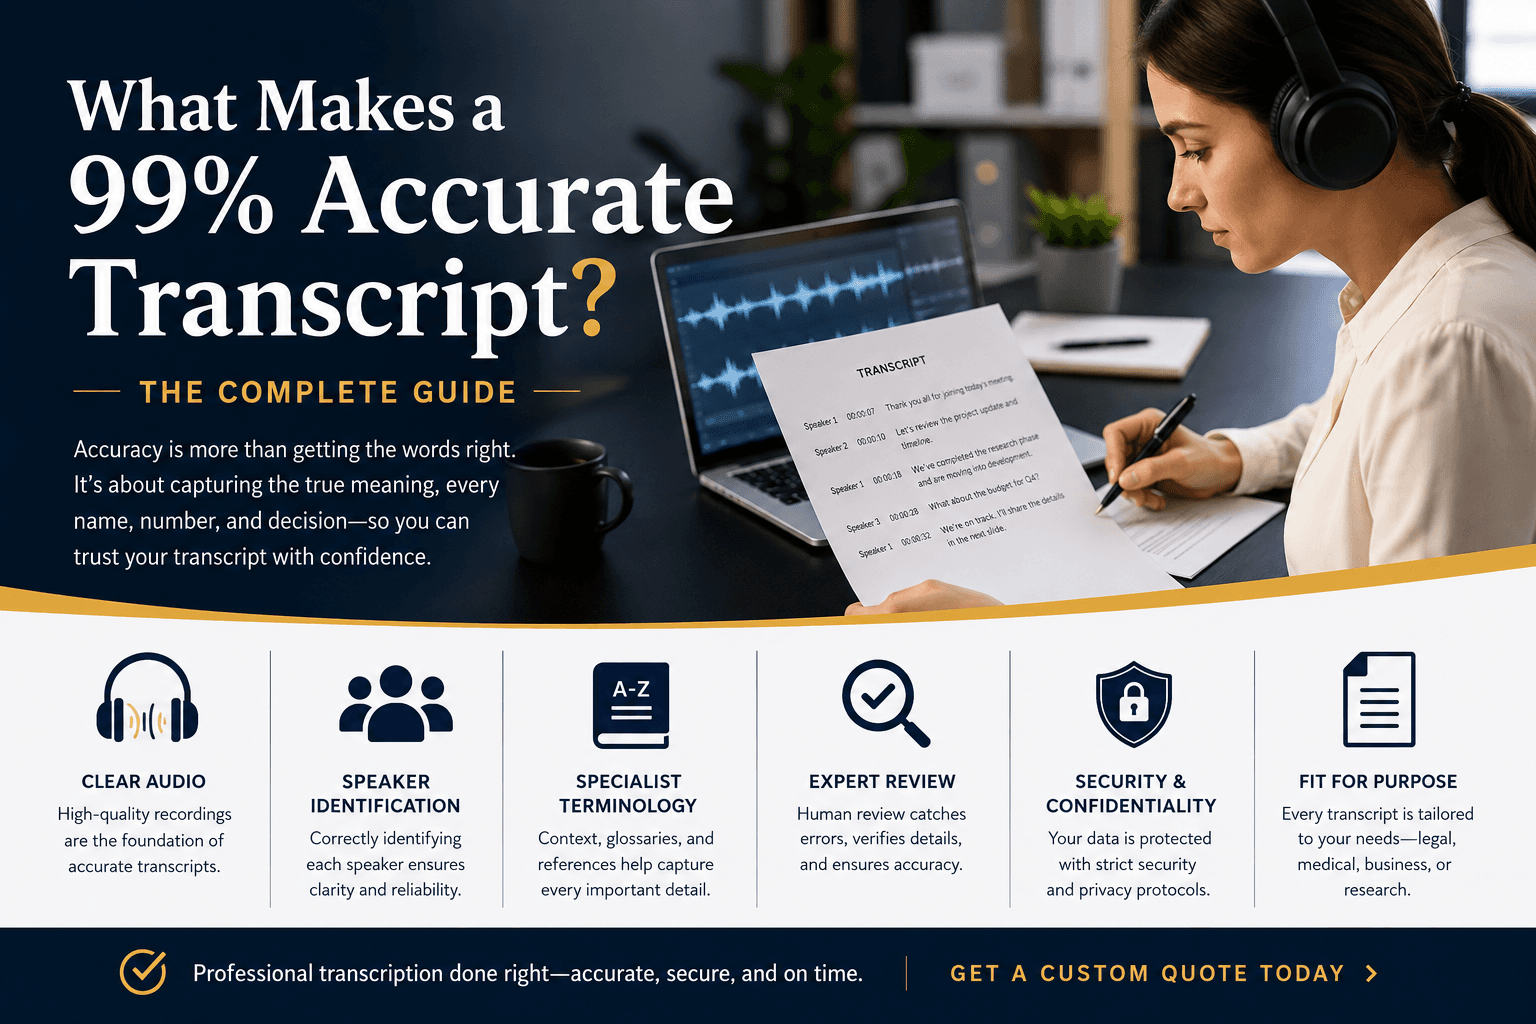
Míra chybovosti slov se počítá jako (S + D + I) / N, kde S počítá substituovaná slova, D počítá smazaná slova, I počítá vložená slova a N je celkový počet slov v referenčním přepisu. Každý typ chyby má ve vzorci stejnou váhu, takže vynechané slovo stojí přesně tolik jako chybné.
WER 5% neznamená jednu chybu úhledně každých 20 slov. Znamená pět chyb někde uvnitř každých 100 slov, hromadících se kolem akcentované řeči, překrývajících se hlasů a oborově specifických termínů, a tyto shluky mají tendenci přistávat přesně tam, kde je význam nejkoncentrovanější.
Proč moderní AI dosahuje WER 2 až 5 procent na čistém audiu a jak takový záznam skutečně zní
Moderní systémy rozpoznávání řeči dosahují WER až 2 až 5% na čistém audiu studiové kvality, benchmarky, které vyžadují nahrávky s jedním mluvčím, s nízkým šumem a blízko mikrofonu. Tato čísla pocházejí z datových sad jako LibriSpeech: jeden mluvčí, profesionální mikrofon, žádný hluk na pozadí, žádné přerušení, žádná variace akcentu, žádné přepínání kódů. Jak poznamenává glosář Allmaz k míře chybovosti slov, většina univerzálních enginů není trénována na vzorech reálné konverzace, což znamená, že hlavní čísla odvozená z čistého, doménově blízkého audia nepředpovídají výkon na nahrávkách, které většina uživatelů skutečně produkuje.
95 procent přesnosti už znamená 25 chybných slov na 500-slovný přepis, než to reálné audio ještě zhorší
25
Chybná slova v 500-slovném přepisu při 95% přesnosti
Přepis schůzky o 500 slovech obsahuje přibližně 25 chyb při 95% přesnosti, dost na to, aby špatně pojmenoval klienta, zkomolil číslo nebo úplně vynechal klíčový úkol. Na skutečných nahrávkách s hlukem na pozadí, akcenty nebo více mluvčími přesnost běžně klesá do rozmezí 85 až 92%. Při 85% nese tentýž přepis 75 chyb: to není přepis, který editujete, ale který přepisujete.
Tento rozsah korekcí vyžaduje pracovní postup postavený na snadném exportu a předání. Exporty DOCX a PDF v Cockatoo existují právě pro tento účel; ten, kdo schůzku nahrál, nemusí být ten, kdo přepis čistí. Bezplatné účty získávají neomezené přepisy v plné délce v V4-Flash, bez denního limitu, a ve všech exportních formátech: DOCX, PDF, TXT, SRT, VTT, CSV a JSON.
Faktory, které na skutečných nahrávkách skutečně ničí přesnost přepisu
Skutečné nahrávky rozbíjejí nástroje pro přepis způsoby, které benchmarky výrobců nikdy neodhalí. Podmínky, které zvyšují míru chyb, nejsou okrajové případy; jsou výchozí realitou pro každého, kdo přepisuje rozhovor, nahrávku hovoru nebo panelovou diskusi. Pochopení toho, které proměnné spouštějí zhroucení přesnosti, je rozdílem mezi nahráním souboru s jistotou a strávením dvou hodin opravováním přepisu, který se vrátil téměř jako nesmysl.
1. Šum na pozadí, ozvěna místnosti a špatné umístění mikrofonu - Čtyři proměnné nahrávání, které benchmarky nikdy netestují
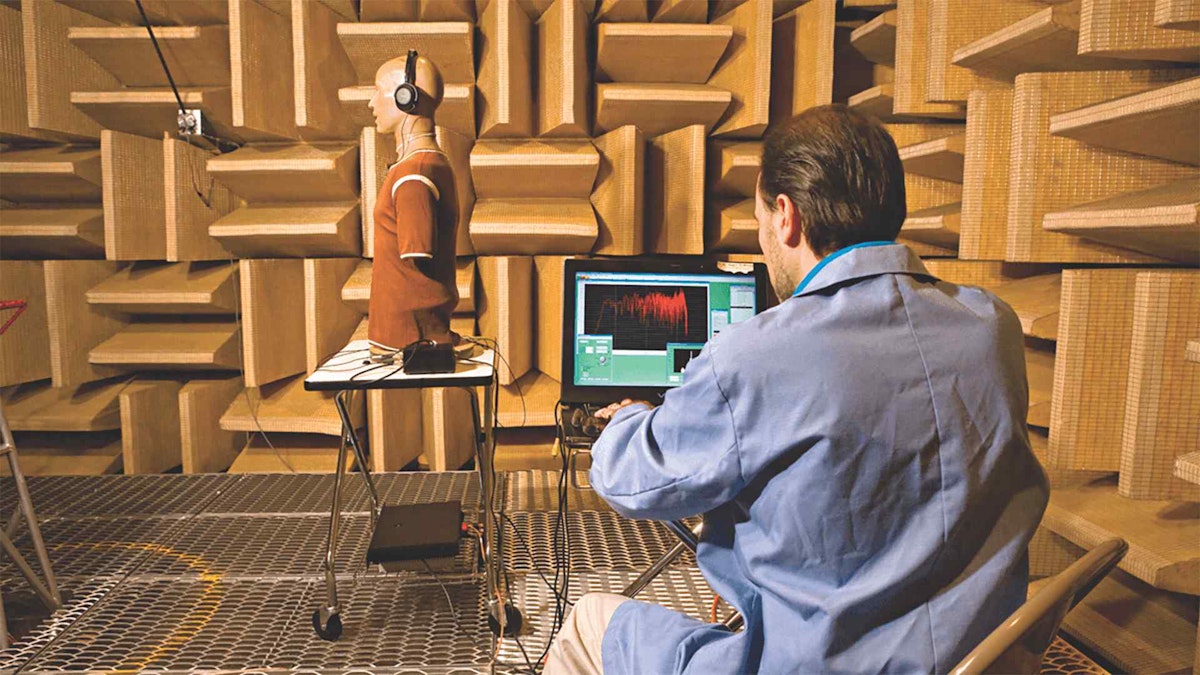
Poměr signálu k šumu je nejsilnější jednotlivý prediktor přesnosti přepisu a rychle se hroutí. Výzkum publikovaný v Speech Communication ukazuje, že míra chybovosti slov může vzrůst z méně než 5% u čistého zvuku na více než 30%, když poměr signálu k šumu klesne pod 10 dB, což je úroveň, která popisuje běžnou kancelář s běžící klimatizací nebo telefonní hovor uskutečněný v kuchyni. Ozvěna místnosti to dále zhoršuje: odražený zvuk rozmazává souhlásky dohromady a model dostává dvě kopie každého fonému v mírně odlišných časech, což způsobuje chyby vynechání, které žádné množství následného zpracování nedokáže plně obnovit.
Umístění mikrofonu je proměnná, kterou většina lidí podceňuje. Mikrofon notebooku nahrávající mluvčího dva metry daleko v neupravené místnosti představuje zásadně odlišnou třídu signálu než vstupy s blízkým mikrofonem v bezdozvukovém prostředí, které používají benchmarky.
Zde je volba režimu v praxi důležitá. Cockatoo má dva režimy přepisu. V4-Flash přepisuje až 120x rychleji než v reálném čase a je zdarma a neomezeně. V4-Pro je nejpřesnější režim, běží přibližně 20x rychleji než v reálném čase a přidává označení mluvčích. Bezplatné účty získávají týdenní náhledy V4-Pro, takže můžete oba režimy porovnat na nahrávce pořízené ve vaší vlastní místnosti, než se rozhodnete, který váš zvuk potřebuje.
Pro provádí celé nahrávky v V4-Pro s vyššími limity využití a prioritním zpracováním. Aktuální plány jsou na stránce s cenami.
2. Nerodilí mluvčí a regionální dialektové variace - Proč chyby záměny prudce rostou mimo korpusy s většinovým přízvukem

Přesnost přepisu anglické řeči nerodilých mluvčích se podstatně liší od uváděného čísla. Průmyslový výzkum zjistil, že pět předních systémů ASR produkovalo u mluvčích černošské americké angličtiny chybovost dvakrát vyšší než u mluvčích bělošské americké angličtiny, a rozdíly související s přízvukem u nerodilých mluvčích jsou ještě větší. Způsob selhání představují chyby záměny: slova, která v kontextu znějí věrohodně, ale jsou špatná, takže přežijí letmé čtení a tiše poškodí záznam.
Průmyslový výzkum zjistil, že pět předních systémů ASR produkovalo u mluvčích černošské americké angličtiny chybovost dvakrát vyšší než u mluvčích bělošské americké angličtiny, a rozdíly související s přízvukem u nerodilých mluvčích jsou ještě větší.
Rozhovor nahraný v kavárně se dvěma nerodilými mluvčími angličtiny běžně vrátí přesnost kolem vysokých 70 % od nástroje, který inzeruje 99%. Tato mezera je strukturálním důsledkem trénovacích korpusů zatížených ve prospěch řeči s většinovým přízvukem nahrané ve studiu. Cockatoo přepisuje 36 jazyků a jeho chybovost V4-Pro pro jednotlivé jazyky, na FLEURS i na nahrávkách z reálného světa, je zveřejněna na jeho stránce s benchmarky, což je správné místo pro ověření vašeho jazyka před zadáním specializované nahrávky.
Jakmile máte k dispozici přesný přepis, dalším třecím bodem je dostat ho do formátu, který kolega skutečně dokáže otevřít a upravit. Cockatoo exportuje přímo do PDF a DOCX, takže přepis přistane jako soubor Word nebo PDF, který může někdo jiný upravovat bez jakéhokoli kroku konverze – detail, který zní nepodstatně, dokud se nepokusíte dostat soubor s prostým textem do formátovaného dokumentu v termínu.
3. Míra chyb v rozlišení mluvčích (DER) - skrytá vrstva přesnosti, kterou dodavatelé téměř nikdy nezveřejňují
Míra chyb v rozlišení mluvčích (DER) měří, jak přesně systém přiřazuje každé slovo správnému mluvčímu. Vypočítá se jako součet zmeškané řeči, falešných poplachů a záměny mluvčích dělený celkovou referenční dobou řeči. Průmyslové benchmarky na nahrávkách schůzek s více mluvčími ze zdrojů, jako jsou hodnocení NIST Rich Transcription, ukazují hodnoty DER 15-30% u překrývajícího se zvuku nebo zvuku v telefonní kvalitě, což znamená, že u čtyřčlenného panelu může být až tři slova z deseti přiřazeno nesprávnému mluvčímu.
Dodavatelé téměř nikdy nezveřejňují DER spolu s WER. Výsledkem je, že přepis může vypadat přesně na úrovni jednotlivých slov, ale být strukturálně nepoužitelný: věty rozdělené uprostřed myšlenky mezi nesprávné mluvčí, akční body přiřazené nesprávné osobě a břemeno čištění, které výzkumníci v kvalitativní práci s rozhovory důsledně popisují jako horší než přepisování od nuly.
4. Nelineární zhroucení kvality zvuku - proč se přesnost nezhoršuje plynule a některé soubory vyžadují úplné přepsání
Přesnost nesklouzává plynule dolů, jak se podmínky zhoršují. Drží se, a pak se zlomí.
Výzkum robustnosti ASR ukazuje prahový efekt: modely si udržují přesnost blízkou benchmarku, dokud degradace signálu nepřekročí kritický bod, v němž akustický model ztratí půdu pod nohama a míra chyb prudce vyskočí, místo aby stoupala úměrně s přidaným šumem. Praktickým důsledkem je, že soubor, který lidskému uchu zní „trochu hrubě“, může být právě za tímto prahem a vrátí přepis, který vyžaduje úplné přepsání, nikoli lehké úpravy. Většina samostatných přepisovatelů to zjistí až poté, co už soubor nahráli, počkali a otevřeli výsledek.
Plán Pro od Cockatoo podporuje neomezenou délku souboru, takže vícehodinové soubory se nahrají celé. Nahrajte jakýkoli zvukový nebo video soubor a získejte zpět upravitelný přepis. Na V4-Pro jsou mluvčí detekováni automaticky a přejmenování mluvčího v editoru aktualizuje každý řádek.

Přepisy přicházejí s časovými razítky na úrovni slov a automatickou interpunkcí. Důkazy o přesnosti najdete na zveřejněné stránce s benchmarky (výsledky FLEURS pro jednotlivé jazyky a výsledky z reálného světa pro 36 jazyků, včetně metodiky) namísto holého procenta.
Neomezená délka souboru je zde důležitá, protože delší nahrávky, které statisticky pravděpodobněji obsahují proměnlivé akustické podmínky po celou dobu, jsou soubory s největší pravděpodobností, že v průběhu narazí na bod nelineárního zhroucení. Možnost nahrát soubor bez zkrácení znamená, že model vidí úplný kontext namísto oříznuté verze, která může začínat nebo končit uprostřed věty.
5. Překrývající se řeč a přeslechy - jak simultánní hlasy ničí integritu signálu už u zdroje

Když dva mluvčí mluví současně, problém není omezení softwaru. Je to problém fyziky. Mikrofon přijímá jediný smíšený průběh signálu a žádný model nedokáže dokonale oddělit dva hlasy, které v daném okamžiku zaujímají stejný frekvenční prostor. Nahrávka panelu se čtyřmi překrývajícími se hlasy, kde rozlišení mluvčích rozděluje věty uprostřed myšlenky mezi nesprávné mluvčí, selhává, protože integrita signálu byla zničena už u zdroje.
Přeslechy v nahrávkách hovorů a videokonferencích jsou obzvláště škodlivé, protože komprimační kodeky používané v těchto pipeline dále zhoršují překrývající se segmenty a model tak dostává už degradovaný vstup, než vůbec přijdou na řadu faktory přesnosti ovlivňující přepis.
U videonahrávek s překrývající se řečí je potřebou navazujících kroků často publikovaný soubor s titulky, nikoli přepis pro editaci. Cockatoo exportuje soubory titulků ve formátech SRT a VTT v každém tarifu, společně s DOCX, PDF, TXT, CSV a JSON, a hromadné exporty jsou součástí tarifu Pro, takže opravený výstup lze doručit přímo k videu, aniž by byla nutná samostatná konverze.
6. Slovní zásoba specifická pro danou oblast a technický žargon - Lexikální mezera, která zvyšuje míru chybovosti slov u specializovaných nahrávek
Modely ASR pro všeobecné použití jsou optimalizovány pro každodenní slovní zásobu a mají potíže s lékařskou, právní, vědeckou nebo oborovou terminologií. Když mluvčí použije oborový žargon, model nahradí nejbližší foneticky podobné běžné slovo, což vytváří chyby, které je při revizi obtížnější odhalit, protože vypadají věrohodně. Pro profesionály přepisující specializovaný obsah je tato lexikální mezera stálým a nedostatečně reportovaným hybatelem ztráty přesnosti přepisu, který skóre WER na čistém zvuku zcela zakrývá.
Jak ve skutečnosti vypadá dobrá přesnost přepisu napříč různými případy použití
Požadavky na přesnost nejsou jediná laťka. Práh, díky kterému je osobní hlasová poznámka dokonale použitelná, by dostal compliance officer vyhozeného. Úroveň přesnosti, kterou musí nástroj pro přepis skutečně dodávat, se odvíjí od toho, jak katastrofálně může jedno chybné slovo kaskádovat do navazujících kroků, takže čelní údaj dodavatele je pro některé uživatele aktivně zavádějící.
Jedna nedoceněná past: standardní metriky míry chybovosti slov mohou lhát opomenutím. Nástroj, který tiše vynechává přeslechy, přeskakuje překrývající se mluvčí, místo aby se je pokusil přepsat, vykáže nižší WER než nástroj, který se o to pokusí a občas tyto výměny zkomolí. První nástroj vypadá na papíře přesněji, přitom dodává méně z vaší skutečné schůzky.
1. Přesnost 80-90% - Přijatelná spodní hranice pro neformální poznámky a osobní diktování
Neformální poznámky a osobní diktování snášejí přesnost 80-90%, protože cena za vynechané slovo je nízká a oprava rychlá. Nákupní seznam se dvěma zkomolenými položkami je drobná nepříjemnost. Praktikující, kteří používají převod řeči na text pro osobní správu znalostí, důsledně zjišťují, že oprava několika chyb na odstavec nesmaže ušetřený čas při zachycení. Skutečným limitem je zde kognitivní zátěž, nikoli přesnost.
I na této úrovni mnoho uživatelů narazí na jemný problém spolehlivosti: počáteční období vysokého výkonu následované nevysvětlitelným poklesem přesnosti. Když se to stane, instinkt je předpokládat, že se změnila kvalita zvuku, zatímco skutečnou příčinou je často to, že se posunul režim nebo cesta zpracování. Stránka s benchmarky produktu Cockatoo zveřejňuje míry chybovosti V4-Pro pro jednotlivé jazyky včetně metodiky, takže si můžete ověřit, jak si váš jazyk vede, než se zavážete k pracovnímu postupu, místo abyste nesoulad objevili až po poklesu.
2. Přesnost 95%+ - Minimální standard pro obchodní schůzky, podcasty a mediální titulky
Obchodní schůzky, přepisy podcastů a titulky k videím stojí na jiné úrovni. Míra chybovosti slov 4% zní malá, dokud nezkomolí jméno klienta, nevynechá rozpočtovou částku nebo nepřiřadí úkol špatné osobě. Marketingový tým vytvářející titulky k videím na sociálních sítích snese WER 4%; tým produkující video o compliance školení nikoli. Na této úrovni jsou vlastní jména a čísla prvními oběťmi zhoršené přesnosti, a to jsou právě ta slova, která řídí rozhodnutí.
Pracovní postup oprav je stejně důležitý jako počáteční přesnost. V prohlížečovém editoru produktu Cockatoo zachytíte špatně přečtená jména a opravíte označení mluvčích bez opětovného zpracování souboru a přejmenování mluvčího aktualizuje každý řádek. Pro nahrávky schůzek zahrnuje Pro také Canvas pro shrnutí. Místo opětovného čtení celé hodiny za účelem ověření každého úkolu můžete pracovat se shrnutím toho, na čem je skutečně třeba jednat, a do přepisu vstoupit jen pro cílené opravy. Tento dvoukrokový postup udržuje dosažitelnou přesnost obchodní úrovně, aniž byste u každého souboru platili lidskému přepisovateli.
3. 99%+ přesnost - nekompromisní práh pro právní, lékařský a compliance přepis
Právní, lékařský a compliance přepis vyžaduje přesnost 99%+ bez jakýchkoli smysluplných výjimek. Jediné přehozené nebo špatně slyšené slovo může změnit význam, zavést odpovědnost nebo způsobit, že přepis neprojde regulačním auditem. Průmyslový výzkum to říká jasně: jediné nepřesné slovo může změnit význam diagnózy, léčebného plánu nebo pokynu k medikaci. Na této úrovni většina AI nástrojů nedokáže zaručit tento práh na audiozáznamech z reálného světa a mezera mezi uváděným číslem prodejce a skutečným výkonem v terénu je místem, kde vzniká odpovědnost.

Problém měření WER je zde nejpalčivější. Pokud nástroj tiše vynechá odborníkův přeslech během diskuse více klinických pracovníků, výsledný přepis může dosáhnout dobrého skóre chybovosti, přitom však zcela chybí klinicky významný obsah, což je horší výsledek než přepis, který se o pasáž pokusil a označil nejistotu. Znalost toho, jak nástroj zachází s překrývající se řečí, nejen jeho souhrnné skóre přesnosti, je nezbytná předtím, než mu svěříte vysoce rizikové nahrávky.
4. Lidský přepis na úrovni 99%+: referenční hodnota, proti níž musí být AI měřena
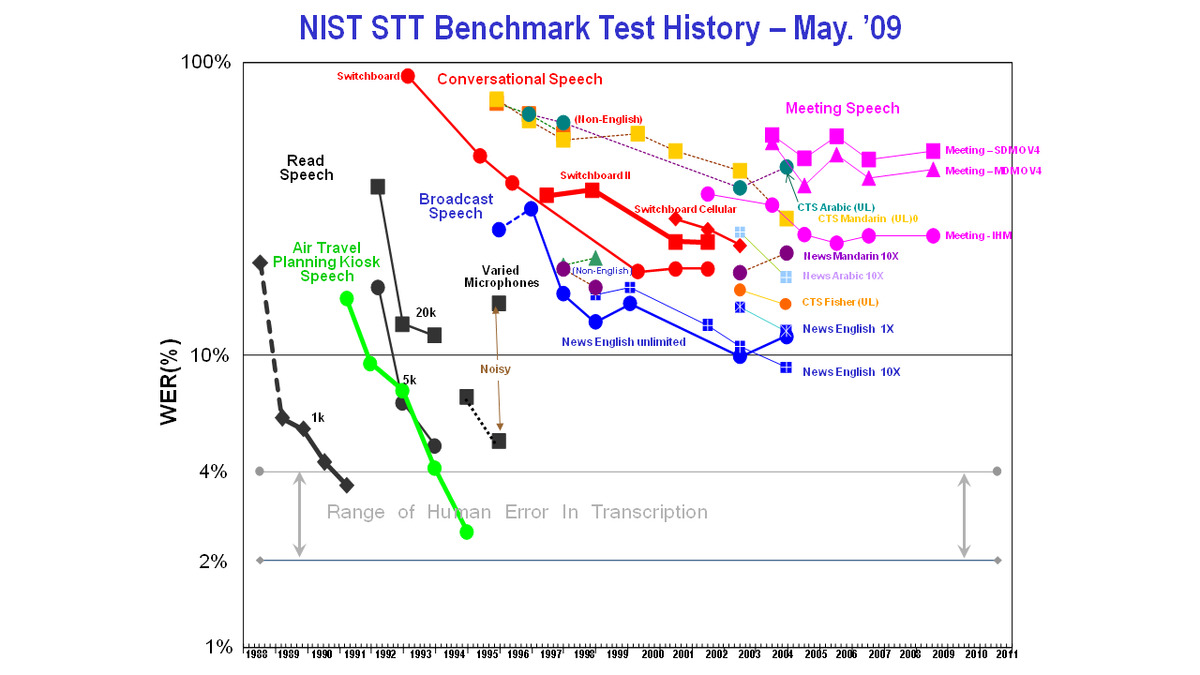
Zkušení lidští přepisovatelé soustavně dosahují přesnosti 99%+, protože znovu poslouchají, odvozují kontext a přizpůsobují se akcentům způsoby, které statistický model nedokáže. To je referenční hodnota, proti níž je AI měřena, a na čistém studiovém audiu se mezera výrazně zúžila. U nahrávek s akcentem, šumem nebo více mluvčími se mezera rozšiřuje způsoby, které uživatelé nemohou předem předpovědět. Lidský přepis je správná volba, když je nahrávka skutečně vysoce riziková a audio podmínky jsou špatné; je to přehnané pro první návrh shrnutí obchodní schůzky.
Praktická otázka pro většinu prosumerů a malých podniků je, zda je nástroj, který hodnotí, benchmarkován na audiu, které se podobá jejich skutečným nahrávkám. Cockatoo se přímo zabývá střední úrovní: výstup AI funguje okamžitě pro neformální poznámky a návrhy schůzek a editor v prohlížeči zvládá korekční průchod na obchodní úrovni, správně zpracovává jména, čísla a označení mluvčích bez lidského přepisovatele u každého souboru. V Pro znamenají shrnutí Canvas, že dlouhé nahrávky lze zkrátit na to, co skutečně vyžaduje akci, takže korekční průchod je rozsahově vymezený a rychlý, nikoli otevřený.
Uživatelé mohou ověřit celý tento pracovní postup na svých vlastních souborech v rámci plánu Free, s neomezenými přepisy v plné délce, bez denního limitu a bez nutnosti kreditní karty, plus týdenními náhledy V4-Pro, než se zavážou k placené úrovni. Pro zpracovává celé nahrávky v V4-Pro, s označením mluvčích a neomezenou délkou souboru, a přidává shrnutí Canvas, což umožňuje prakticky zpracovávat mnohahodinové nahrávky stejným pracovním postupem ve velkém měřítku.
Znát svůj práh je jen polovina rovnice. Těžší otázka je, zda nějaký AI nástroj, včetně těch, které na své domovské stránce citují 99%, skutečně překoná tuto laťku na audiozáznamech s akcentem, šumem a specifických pro danou doménu, které se nacházejí ve vaší složce s nahrávkami. To je přesně to, co měří následující část.
Související čtení
- Nejlepší software pro přepis
- Ceník Turboscribe
- Lokální AI přepis
- Jak přepsat video
- Vícejazyčný přepis
- Offline AI přepis
Jak si AI přepis poradí s lidským přepisem na audiu, které skutečně máte
Volba mezi AI a lidským přepisem vypadá jako debata o kvalitě, ale ve skutečnosti je to debata o podmínkách.
Na čistém audiu se AI téměř vyrovná lidským přepisovatelům
Podle benchmarkové analýzy VexaScribe se špičkové AI enginy vyrovnají průměrnému lidskému přepisovateli nebo jej překonají při zhruba 4-5% WER na čistých anglických nahrávkách s jediným mluvčím. 60minutový rozhovor vracející se s 3% WER vyžaduje přibližně 15 minut na revizi a výkonnostní rozdíl mezi nejlepšími a nejhoršími hlavními AI enginy se pohybuje kolem 3-5 bodů WER.
Jedna nedoceněná implikace: u čistého video materiálu, přednášky, produktového dema, nahraného webináře je přesnost AI často natolik vysoká, že Cockatoo dokáže převést přepis na soubory titulků SRT nebo VTT během několika sekund, připravené k rychlé kontrole před publikováním.
U zvuku z reálného světa se mezera zvětšuje, protože lidé usuzují, zatímco AI hádá
U nahrávek z reálného světa se obraz mění. Analýza VexaScribe zjistila, že u schůzek, telefonních hovorů a řeči s přízvukem zaostává AI za zkušenými lidskými přepisovateli o 2-5% WER. Model AI porovnává vzory s trénovacími daty, a když audio spadne mimo toto rozložení, přesnost prudce a nepředvídatelně klesá, zatímco lidští přepisovatelé odvozují význam z kontextu. Lidská produkce přepisu jej nečiní přesným; činí jej autorským, se vší selektivní pozorností a inferencí, kterou to implikuje.
Čas na opravy je skrytý náklad, který maže rychlostní výhodu AI u obtížného zvuku
60minutový rozhovor se dvěma nerodilými mluvčími a slyšitelným šumem na pozadí se může vrátit z AI s 14% WER.
Canvas v Cockatoo, součástí Pro, je postaven přesně pro toto: místo úpravy dlouhého přepisu slovo po slovu jej použijete k shrnutí nahrávky na to, na co je skutečně třeba jednat.
Jak zlepšit přesnost přepisu, než nahrajete jediný soubor
Nahrávka pořízená v hlučné místnosti dává každému přepisovacímu enginu problém, který nedokáže plně vyřešit. Nástroj dostává to, co zachytil mikrofon; nedokáže rekonstruovat řečovou informaci, která nebyla od začátku čistě zaznamenána. Proto je jediným nejúčinnějším zlepšením přesnosti dostupným každému uživateli rozhodnutí o hardwaru a prostředí učiněné před nahráváním, nikoli softwarové nastavení přepnuté při nahrávání.
Většina lidí předpokládá, že řešením je lepší nástroj. Skutečným řešením je lepší zdrojový zvuk. Zde je šest konkrétních kroků, které pohnou jehlou.
1. Vylepšete mikrofon, než se dotknete jakéhokoli softwarového nastavení
Journal of Electrical and Electronic Engineering potvrzuje, že kardioidní mikrofony překonávají všesměrové konstrukce v hlučném prostředí tím, že utlumují zvuky přicházející ze stran a zezadu a zachovávají hlasový signál vpředu. Kondenzátorový USB mikrofon za $50 namířený přímo na mluvčího dává každému přepisovacímu enginu čistší signál, než kdy dokáže mikrofon notebooku. Utrácet peníze za vyšší předplatné, zatímco nahráváte na vestavěný hardware, optimalizuje špatný konec pipeline.
2. Nahrávejte v tiché místnosti, abyste eliminovali největšího zabijáka přesnosti
Klimatizace, ulice venku nebo běžící ventilátor se sčítají do chyb v celé nahrávce. Zavřete dveře, vypněte vše, co hučí, a nahrávejte daleko od oken. Čím tišší místnost, tím více řečové informace mikrofon zachytí a tím méně musí engine hádat.
3. Ztlumte oznámení a ztište zařízení před každým nahráváním
Zvuky oznámení jsou krátké, ale jejich dopad je nepřiměřený. Jediný zvuk upozornění překrývající vyslovené slovo může toto slovo zcela zkazit, protože engine přesně v tom okamžiku ztratí svou kotvu důvěry a často trpí i okolní slova. Dejte telefony na ticho, zavřete karty prohlížeče, které automaticky přehrávají zvuk, a vypněte systémové zvuky na každém počítači v místnosti, než stisknete nahrávání. To stojí třicet sekund nastavení a pravidelně ušetří minuty oprav.
4. Vyhněte se reproduktorům telefonu a vestavěným mikrofonům notebooku u jakéhokoli seriózního nahrávání
Zvuk telefonního hovoru zpracovaný úzkopásmovým kodekem zachycuje komprimovaný frekvenční rozsah, který odstraňuje akustický detail, na nějž se engine spoléhá při rozlišování podobně znějících slov. Vestavěné mikrofony notebooků mají stejný problém: jsou všesměrové a umístěné daleko od úst mluvčího, takže zachycují místnost stejně snadno jako hlas. Oba jsou přijatelné pro neformální poznámky, kde mají drobné chyby nízkou sázku. Pro jakoukoli nahrávku, kde záleží na jménech, číslech nebo rozhodnutích, není ani jeden spolehlivým zařízením pro záznam.
5. Stanovte si očekávání přesnosti ještě před přijetím terénních nahrávek nebo zvuku z telefonních hovorů
Pokud vám někdo pošle nahrávku, kterou pořídil na telefonu v rušné kavárně, strop přesnosti je daný už před nahráním. Žádný engine ani sebevětší úpravy po nahrání nedokážou obnovit řečovou informaci, která nebyla nikdy čistě zachycena. Než od klienta nebo kolegy přijmete soubor, položte si jednu otázku: byl nahrán blízko mluvčího v tichém prostředí? Pokud je odpověď ne, označte to hned na začátku. Oprava špatného přepisu zabere mnohem více času než nastavení očekávání před začátkem práce.
6. Před závazkem k přepisu prověřte kvalitu starších a archivních nahrávek
Starší nahrávky nesou artefakty, šum pásky, šum kodeku, kompresi šířky pásma, s nimiž si moderní AI enginy poradí jinak než lidští přepisovatelé. Člověk si nahrávku znovu poslechne a domýšlí z kontextu; engine vydá svůj nejlepší statistický odhad a jde dál, takže se chyby tiše shlukují kolem zhoršených pasáží. Než archivní soubor nahrajete, přehrajte třicet sekund a poslouchejte, zda neslyšíte šum, ořezávání nebo ozvěnu. Pokud vám přehrávka zní hrubě, v přepisu bude vypadat ještě hůř. Opětovné nahrání krátkého úseku, kde je to možné, nebo označení zhoršených částí před nahráním stojí minuty a ušetří celé přepisování.
Jediné číslo přesnosti, kterému se vyplatí věřit, je to, které si můžete sami ověřit
Procenta míry chybovosti slov (WER), která zveřejňují dodavatelé, se obvykle měří na čisté, studiově nahrané anglické řeči – tedy v podmínkách, které jen málo připomínají zhoršený, vícejazyčný nebo oborově specifický zvuk, s nímž většina organizací skutečně pracuje. Smysluplné benchmarky uvádějí testovací sadu, specifikují jazykové a akcentové rozložení a rozpadají výkon podle úrovně kvality zvuku, místo aby vše slily do jednoho optimistického průměru.
„Uživatelé nemohou nezávisle ověřit tvrzení o ‚40% lepší přesnosti‘ nebo ‚mnohem lepší přesnosti‘, která uvádí TranscribeX; není k dispozici žádný benchmark, testovací soubor ani metodika, kterou by kdokoli mohl sám replikovat.“
— co slýcháme od uživatelů přepisovacího softwaru
Benchmark Google FLEURS pokrývá skutečnou nahranou řeč v 102 jazycích za standardizovaných podmínek, takže je reprodukovatelnou externí referencí, kterou si každý uživatel může křížově ověřit. FLEURS zveřejňuje jazykově specifická hodnoticí rozdělení, takže míra chybovosti slov pro jednotlivé jazyky na FLEURS je ověřitelné tvrzení, nikoli číslo, které si dodavatel vybral za příznivých podmínek.
Model, který si dobře vede na angličtině většinového akcentu, může vykazovat výrazně vyšší chybovost u indonéštiny, ásámštiny nebo francouzštiny, aniž by se hlavní číslo vůbec pohnulo. Auditovatelná přesnost vyžaduje tři věci zároveň: pojmenovaný benchmark (FLEURS vyhovuje), rozpad podle jednotlivých jazyků místo smíšeného čísla a testovací zvuk, který odráží podmínky skutečného nahrávání.
Proč je kompromis mezi přesností a cenovou dostupností technologický problém, a ne fyzikální zákon
Špičkové hluboké učení, navržené pro rychlost a přesnost, činí vysokou přesnost cenově dostupnou při jakémkoli objemu.
Cockatoo zveřejňuje výsledky pro jednotlivé jazyky pro svůj režim V4-Pro napříč všemi 36 jazyky, které přepisuje. Měří se na FLEURS a na interní, lidsky anotované sadě nahrávek z reálného světa, hodnoceny jako WER (CER pro čínštinu, japonštinu, khmerštinu a thajštinu) s open-source normalizací textu OpenAI Whisper. Rozdíl, který tento článek popisuje, se objevuje i v těchto číslech. Na anglických kliprech FLEURS je míra chybovosti slov u V4-Pro 3.9%. Na anglických nahrávkách z reálného světa je to 10.4% až 10.9%. V4-Pro má nejnižší chybovost ze testovaných poskytovatelů v 25 z 36 jazyků na FLEURS, ale ne ve všech jazycích: na anglickém FLEURS dosáhl nižší hodnoty Universal-3.5 Pro od AssemblyAI. Výsledky, metoda a poznámka, že sada z reálného světa je kontrolou na vzorku, jsou na stránce s benchmarky. Přesnost se liší podle jazyka a kvality nahrávky.
Jak provést pětiminutový ověřovací test, než si cokoli předplatíte
Počítejte chyby oproti tomu, co bylo skutečně řečeno. Benchmark dodavatele na FLEURS vám ukáže spodní hranici; váš vlastní klip vám ukáže realitu. Externí benchmark plus test na skutečném souboru společně eliminují informační asymetrii, kterou číslo uváděné samotným dodavatelem ponechává na místě.
Související čtení
- Nejlepší přepisovací aplikace
- Descript Vs Otter
- Fireflies Vs Otter
- Trint Vs Rev
- Happy Scribe Vs Rev
- Konkurence Otter.AI
Další kroky
Pokud se vaše nahrávky stále vracejí s přepisy, jejichž oprava trvá déle než přepsání znovu, cesta vpřed začíná uznáním, že hlavní číslo přesnosti nebylo nikdy měřeno na zvuku, jako je ten váš. Začněte s naším softwarem pro přepis.
Vliv kvality zvuku na přesnost převyšuje jakýkoli rozdíl mezi enginy a mezera mezi nejlepšími a nejhoršími AI nástroji na nahrávkách z reálného světa se smrskne na 3 až 5 bodů WER, což je rozpětí, které mohou samotné podmínky nahrávání posunout o větší rozdíl. To znamená, že výběr „přesnějšího“ nástroje bez předchozího otestování na vašich vlastních souborech je optimalizace špatné proměnné. Zároveň dodavatel, který zveřejňuje výsledky pro jednotlivé jazyky na standardizovaném externím datasetu a umožňuje vám otestovat vaše vlastní audio před platbou, strukturálně odstranil informační asymetrii, kvůli níž jsou tvrzení o přesnosti ze své podstaty neověřitelná.
Tyto dvě podmínky dohromady, externí benchmark plus test na skutečném souboru, jsou jedinou kombinací, která vám umožní tvrzení auditovat, místo abyste mu věřili. Společně ukazují na jeden zřejmý další krok: prožeňte své vlastní audio nástrojem, který zveřejňuje obojí.
Začněte se softwarem pro přepis, který zveřejňuje benchmarky FLEURS pro jednotlivé jazyky a nevyžaduje kreditní kartu k vyzkoušení. Nahrajte skutečný klip ze svých nahrávek, porovnejte výsledek se zveřejněnými čísly pro váš jazyk a máte jediné číslo přesnosti, které se kdy přenese do produkčních podmínek.
Často kladené otázky
Co ve skutečnosti znamená míra přesnosti 95% pro můj přepis v praxi?
Míra přesnosti 95% znamená zhruba 25 chyb v každém přepisu o 500 slovech, což stačí na to, aby byl klient chybně pojmenován, zkomolen údaj nebo zcela vypadl klíčový úkol. Na skutečných nahrávkách s hlukem na pozadí, přízvuky nebo více mluvčími přesnost běžně dále klesá, do rozmezí 85 až 92%, kde tentýž přepis může obsahovat 75 chyb a vyžadovat kompletní přepsání, nikoli lehké úpravy.
Proč dodavatelé inzerují přesnost 98% nebo 99%, když se mé přepisy vracejí plné chyb?
Dodavatelé testují své nástroje na čistém, studiovém audiu s jediným mluvčím, na datasetech jako LibriSpeech s profesionálními mikrofony, bez hluku na pozadí a bez variace přízvuku, a nejsou povinni tyto testovací podmínky zveřejnit. Váš rozhovor, nahrávka hovoru nebo nahrávka schůzky téměř jistě těmto podmínkám neodpovídá, takže hlavní číslo prostě nebylo měřeno na zvuku, jako je ten váš.
Jak špatné to vlastně je s překrývající se řečí pro přepisovací nástroje?
Když dva mluvčí mluví současně, mikrofon zachytí jednu smíšenou vlnu, kterou žádný model nedokáže dokonale oddělit, protože hlasy současně zaujímají stejný frekvenční prostor, je to fyzikální problém, ne softwarový. Kromě slovních chyb, které to způsobuje, průmyslové benchmarky na nahrávkách schůzek s více mluvčími ukazují míru chyb diarizace 15-30% u překrývajícího se audia nebo audia v telefonní kvalitě, což znamená, že až tři slova z deseti mohou být přiřazena nesprávnému mluvčímu u panelu čtyř osob.
Je Word Error Rate totéž co procento přesnosti zobrazené na domovské stránce dodavatele?
Ano, procento přesnosti je jen převrácená hodnota WER. WER se počítá jako (Substituce + Delece + Inzerce) děleno celkovým počtem slov v referenčním přepisu, takže WER 5% se stává tvrzenou přesností 95%. Všechny typy chyb se ve vzorci počítají stejně, což znamená, že delece, která vypustí slovo „ne“ z „nepokračujte“, stojí stejně jako triviální překlep, a chyby se shlukují kolem nejtěžších momentů, řeči s přízvukem, překrývajících se hlasů a termínů specifických pro danou oblast, místo aby se rovnoměrně rozprostřely po celém přepisu.
Musí se moje nahrávka opravdu hodně zhoršit, než se přesnost zhroutí, nebo se zhoršuje postupně?
Přesnost neklesá plynule dolů, drží se poblíž úrovní benchmarku a poté se prudce zlomí, jakmile degradace signálu překročí kritickou hranici. Výzkum robustnosti ASR ukazuje, že tento prahový efekt znamená, že soubor, který lidskému uchu zní jen „trochu hrubě“, už může být za bodem, kde míra chyb dramaticky vyskočí, a vrací přepis, který vyžaduje kompletní přepsání, nikoli lehkou úpravu.






